TimeSeries-Insight (KI-Analyse-Engine)
Übersicht
PlantPulse TimeSeries-Insight ist ein MCP-Server für KI-Anomalieerkennung, Prognose und umfassende Analyse, der auf Zeitreihendaten aus der Fertigung spezialisiert ist.
Mit den KI-Modellen IBM Granite TSPulse (Anomalieerkennung) und TinyTimeMixer TTM (Prognose) bietet er intelligente Analysen für sämtliche Zeitreihendaten der Fabrik — Sensordaten, OEE, RAM, EMS, Alarme, Arbeitsaufträge und mehr.
Mit 39 Analyse-Werkzeugen und einem Feature Store werden sowohl Echtzeitanalysen als auch vorberechnete umfassende Erkenntnisse unterstützt. Ab 2026.10 wartet die Engine nicht mehr darauf, als Werkzeug aufgerufen zu werden, sondern findet Probleme von sich aus und hält sie als «Fund» fest, und der Copilot nimmt diesen auf und meldet ihn dem Menschen → KI-Funde und Genauigkeit
insight-api(:8970) ist für Werkzeuge und Daten zuständig, die Modellinferenz (TSPulse·TTM) wird an
insight-server(:8980) delegiert. Die GPU wird nur für die Inferenz benötigt, daher können die beiden Dienste auf
unterschiedlichen Geräten laufen.
Wo Anomalieerkennung im Copilot zu sehen ist
Von der Engine gefundene Anlagenanomalien erscheinen im Copilot unter Vorschläge › Aufgaben › Unerwartet als zu prüfende Anomalie. Pro Anlage eine Zeile; klickt man eine Zeile an, sieht man im Detail Trendlinie · zugehörige Tags · Begründung und entscheidet Als Incident melden oder Ignorieren (mit Begründung) → Vorschläge
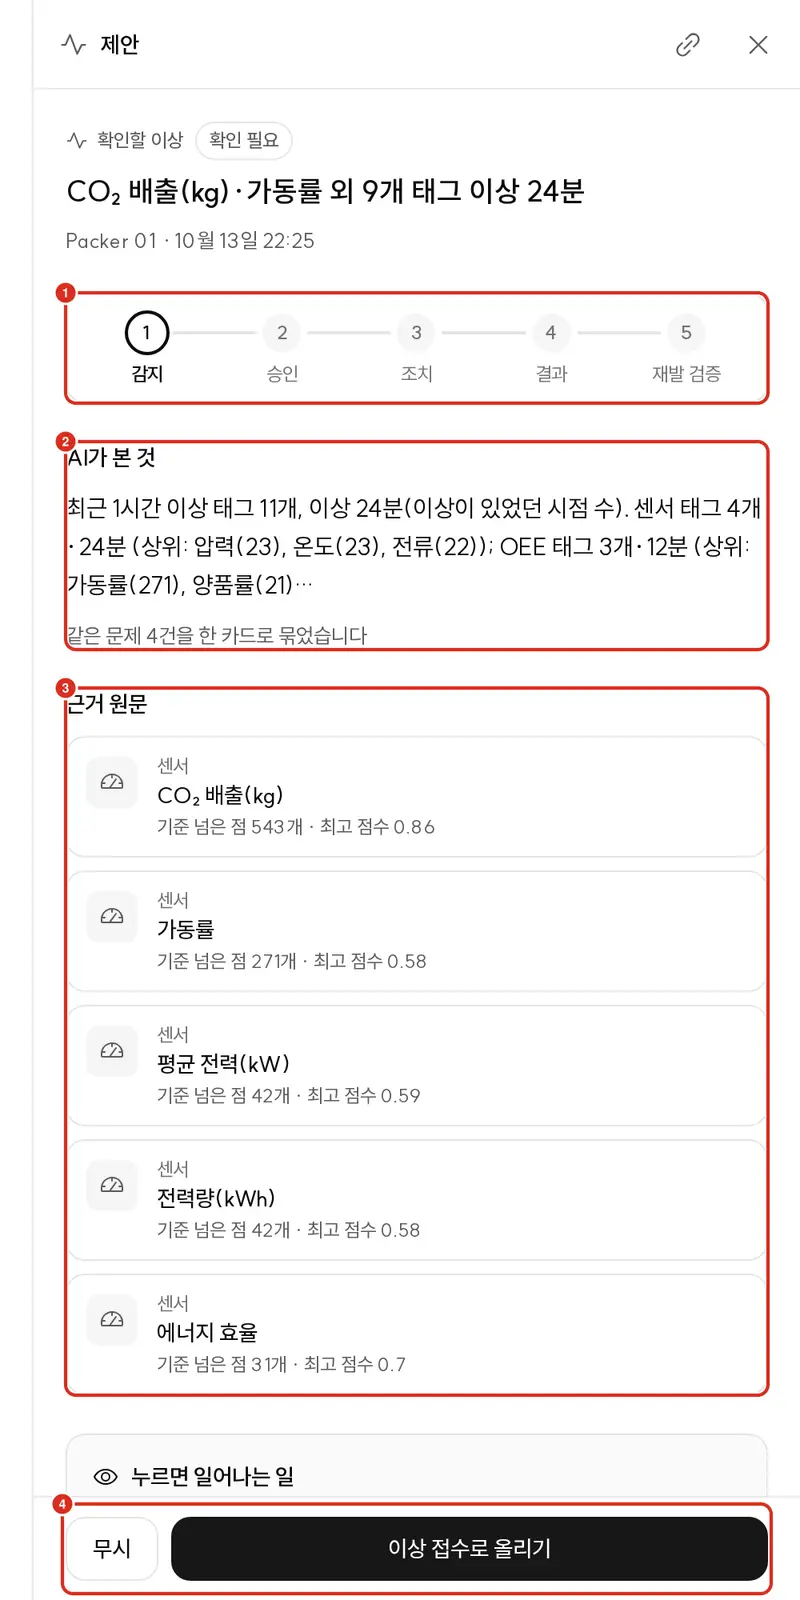
Das frühere Menü «Anomaliediagnose» samt der darin enthaltenen «Betriebskonsole» ist entfallen; diese Aufgabe erledigt man nun unter Vorschläge › Unerwartet (die alte Adresse /anomaly leitet nicht mehr weiter).
| Was früher in der Betriebskonsole erledigt wurde | Jetzt |
|---|---|
| Anomalieliste durchsehen · prüfen | Vorschläge › Aufgaben › Unerwartet. Nach Dringlichkeit sortiert |
| Als korrekt/falsch markieren (KI-Bewertung) | Bei Fehlalarm wird unter Ignorieren ein Grund ausgewählt → KI-Funde und Genauigkeit |
| Schaltfläche «Ausführen» für Vollscan · Zielscan | Es gibt keine Schaltfläche mehr. Der Server läuft nach festem Zyklus — siehe unten |
| Anlagen-Zeitachse | Bei Installationen mit verbundenem Digital Thread einfach fragen: „Zeig mir chronologisch, was bei dieser Anlage zuletzt passiert ist“ |
Erkennung erfolgt in zwei Zyklen
| Was wird geprüft | Wann (Standard) | |
|---|---|---|
| Vollscan | Alle Anlagen | Alle 2 Stunden |
| Zielerkennung | Nur Anlagen mit kürzlichem Alarm | Alle 10 Minuten |
Zyklus · Kriterien für Schweregrad · Benachrichtigungskanäle finden Sie unter Anomalieerkennung · Incident-Reaktion.
Die frühere Möglichkeit, Benachrichtigungen pro Anlage stummzuschalten, und der «Noise-Top-10» gibt es im neuen Bildschirm nicht mehr.
Neu angeschlossene oder lange stillstehende Anlagen liefern erst dann Anomaliewerte, wenn pro Tag eine Baseline ermittelt wurde. In dieser Zeit erscheinen Anomalien, selbst wenn vorhanden, nicht als zu prüfende Anomalie → KI-Funde und Genauigkeit — In Lernphase · nicht beurteilbar
KI-Anomalieerkennung (Anomaly Detection)
Basismodell: IBM Granite TSPulse
| Ziel | Werkzeug | Analyseinhalt |
|---|---|---|
| Anlagensensoren | detect_asset_anomaly | Erkennung von Anomaliemustern bei Temperatur, Druck, Vibration usw. |
| Systemressourcen | detect_system_anomaly | Erkennung von CPU-, Speicher-, Festplattenanomalien |
| OEE | detect_oee_anomaly | Anomaliemuster bei Verfügbarkeit, Leistung, Qualität |
| RAM | detect_ram_anomaly | Anomaliemuster bei MTBF, MTTR |
| EMS | detect_ems_anomaly | Anomalien bei Energieverbrauch, Leistung, CO2-Ausstoß |
| Arbeitsauftrag | detect_order_anomaly | Anomalien bei Produktionsqualität (OEE/RAM/EMS/kombiniert) |
| Alarm | detect_alarm_anomaly | Anomaliemuster bei Alarmhäufigkeit |
Wichtige Parameter:
threshold— Schwellenwert für Anomaliebeurteilung. Bei Anlagensensoren (detect_asset_anomaly) bezieht sich der Wert auf den korrigierten Score, Standard ist 5.0 — 🔴0ist nicht «automatisch», sondern zählt fast jeden Punkt als Anomalietop_k— Anzahl der Top-Anomalie-Metrikenlookback_minutes— Analysezeitraumtarget_columns— Analyseziel (bei fehlender Angabe automatische Abfrage aller Sensoren)
Der Anomalie-Score für Anlagensensoren (score_scale: calibrated) basiert auf dem Abschnitt unmittelbar vor dem Analysefenster
und gibt an, um wie viele Vielfache (robuster Z-Wert) der Rekonstruktionsfehler von der typischen Schwankung
dieses Abschnitts (Median · MAD) abweicht.
0 bedeutet «normal», 5 ist der Standardschwellenwert.
- Statustags (Werte wie Betrieb/Stillstand) werden vom Scoring ausgenommen.
- Zählertags (z. B. kumulierte Produktionsmenge) werden nicht als kumulativer Wert, sondern als Mittelwert der 5-Intervall-Zuwächse betrachtet — so wird erkannt, wenn der Zuwachs bei Produktionsstopp auf 0 fällt.
- Der vordere Abschnitt, der das erste Modellfenster dupliziert, wird vom Scoring ausgenommen.
- Aggregations-/Glättungsfenster betragen bei Sensoren 8 / 4 (
aggr_win_size·smoothing_window_size). Die früheren Werte 32 / 16 verwischten den Score über fast 30 Minuten und übersahen kurze Stillstände.
Scores im Domänenbereich wie OEE · RAM · EMS werden weiterhin bei jedem Aufruf auf 0–1 normiert — auch
beim gleichen threshold unterscheidet sich die Skala.
KI-Prognose (Forecasting)
Basismodell: TinyTimeMixer — Granite-TTM R3 (512-96-dec-512-r3, Kontext 512 · Prognose 96)
| Ziel | Werkzeug | Prognoseinhalt |
|---|---|---|
| Anlagensensoren | forecast_asset | Zukünftiger Trend des Sensorwerts |
| Systemressourcen | forecast_system | CPU-/Speicher-/Festplattenauslastung |
| OEE | forecast_oee | Zukünftiger Verlauf von Verfügbarkeit, Leistung, Qualität |
| RAM | forecast_ram | Zukünftiger Trend der Anlagenzuverlässigkeits-Kennzahlen |
| EMS | forecast_ems | Prognose zu Energieverbrauch, CO2-Ausstoß |
| Arbeitsauftrag | forecast_order | Zukünftiger Verlauf der Produktionsqualität |
| Alarm | forecast_alarm | Trend der Alarmhäufigkeit, Ausfallprognose |
Wichtige Parameter:
prediction_length— Anzahl der Prognoseschritteenable_bounds— Ausgabe des Konfidenzintervalls (oben/unten)
Achten Sie auf model_used in der Antwort — 200 heißt nicht automatisch TTM
Die Prognoseantwort enthält auch die Angabe, womit sie erzeugt wurde.
| Wert | Bedeutung |
|---|---|
TTM | Vom trainierten Modell erzeugt |
NAIVE | Aus Datenmangel per drift · seasonal-naive erzeugt. Der Grund steht in fallback_reason |
NAIVE liefert HTTP 200Nur bei Datenmangel meldet die Engine keinen Fehler, sondern fällt auf einfache Extrapolation zurück. Wer beim Aufruf nur auf 200 achtet, sieht statt der „TTM-Prognose“ eine einfache Extrapolation.
Lesen und protokollieren Sie deshalb unbedingt model_used. Steigt NAIVE an, ist das bereits ein Warnsignal.
Spalten, für die selbst einfache Extrapolation keinen Wert liefern kann, werden nicht mit 0 aufgefüllt, sondern in
dropped_columns vermerkt und ausgelassen. Fallen alle Spalten aus, folgt 422.
Alle anderen Fehler werden nicht abgefangen — denn wiederholte Versuche beheben sie nicht, und sie dürfen nicht verborgen werden.
| Was | Antwort |
|---|---|
| Fataler CUDA-Fehler (GPU ausgefallen) · Inferenz-Warteschlange voll | 503 + Retry-After |
| Fehlerhafte Modellkonfiguration (unten) · Laden der Gewichte fehlgeschlagen · Codefehler | 500 |
Wurde ein Konfidenzintervall (enable_bounds) angefordert, aber nicht mitgeliefert, erklärt bounds_reason den Grund —
hier wird unterschieden zwischen „diese Anlage kann kein Intervall liefern“ und „die gesendeten Daten reichten nicht aus“.
TS_TTM_MODEL_CLASS — Einstellung zur Abstimmung von Checkpoint-Generation und Loader
Das Prognosemodell (TTM) liest je nach Generation eine andere Klasse. Über eine einzelne Umgebungsvariable in insight-server lässt sich dies wählen (eingeführt in der Version nach dem 2026-09-21 — in früheren Versionen gibt es diese Einstellung nicht, dort ist sie fest auf ForPrediction gesetzt).
| Wert | Verwendung |
|---|---|
| Leer (Standard) | Wird vom config.json(decompose) im Checkpoint bestimmt — meist so belassen |
ForPrediction | TTM-R2-Checkpoint |
ForDecomposedPrediction | Granite-TTM-R3 (dekomponierte Prognose)-Checkpoint |
Das im Image enthaltene Standardmodell ist R3. R2 ist unter model/ttm-r2 ebenfalls mitgeliefert; beim Zurückwechseln
muss nur ein Pfad geändert werden, ohne die Klasse anzufassen.
TS_TTM_DIR=/app/model/ttm-r2 # R2 로 되돌리기 — 클래스는 그 디렉터리의 config 가 정합니다
R2 und R3 haben keine einzige gemeinsame Gewichtsbezeichnung, dennoch liest jede Klasse den Checkpoint der jeweils anderen ausnahmslos ein. Ohne Schutz entstünde ein Modell, bei dem alle 445 Parameter neu (zufällig) initialisiert werden, das aber unter dem Namen model_used="TTM" Antworten liefert.
Aktuell wird beim Laden abgelehnt, sobald auch nur ein Parameter neu erzeugt werden müsste, weil er im Checkpoint fehlt. Im Log erscheint dann Folgendes:
[MODEL_LOAD] TTM dir=… , class=ForPrediction, in_channels=…
[MODEL_LOAD_FAIL] TTM dir=… — 학습된 가중치를 못 읽었다. 무작위 초기화 모델로 대체하지 «않는다».
    reason=[ForPrediction] 체크포인트에 없어 새로 지은 파라미터 445개 (예: …) —
           클래스가 체크포인트 세대와 맞는지 보라(TS_TTM_MODEL_CLASS)
Ein Konfigurationsfehler bringt den Server nicht zum Absturz — da derselbe Prozess auch die Anomalieerkennung bedient, soll ein Fehler in der Prognosekonfiguration nicht auch unabhängige Funktionen lahmlegen.
Stattdessen zeigt er sich in /health. In models der Antwort erscheint der Ladestatus je Modell, und sobald
auch nur eines nicht geladen werden konnte, steht status auf degraded (HTTP bleibt 200). Der vom Container-Healthcheck
genutzte /ping meldet 503 nur, wenn beide Modelle ausgefallen sind — damit der Container nicht ständig neu
startet, nur weil die Prognose allein ausgefallen ist.
"status": "degraded",
"models": {
  "tspulse": { "loaded": true,  "error": null },
  "ttm":     { "loaded": false, "error": "ModelConfigError: …" }
}
⚠ Fehlt in /health der Eintrag models, handelt es sich um eine ältere Version — dort erscheint der Healthcheck
weiterhin als normal, prüfen Sie daher anhand der nachfolgenden Prognoseanfrage und Startlogs. Auch das unterscheidet sich je nach Version.
| Version | Prognoseanfrage | Startlog |
|---|---|---|
| Nach 2026-09-21 | HTTP 500 | [MODEL_WARMUP_FAIL] TTM ch=… 설정이 체크포인트와 맞지 않는다 — 이 설정으로는 모든 예측이 실패한다 |
| Davor | HTTP 200 · model_used="NAIVE" | [MODEL_WARMUP_SKIP] TTM ch=… |
In älteren Versionen wurde selbst ein Konfigurationsfehler durch einfache Extrapolation abgefangen, sodass der Zustand /health als normal · Prognose 200 · alle Antworten lautlos per einfacher Extrapolation fortbestehen konnte. Heute wird zwischen Fehlern, die auch wiederholte Versuche nicht beheben (Konfiguration), und vorübergehenden Fehlern (z. B. Datenmangel) unterschieden, wobei nur Erstere gemeldet werden.
🔴 Welche der beiden Versionen vorliegt, lässt sich nicht an der Versionsnummer, sondern nur an der «Logzeile» erkennen. Der Image-Tag dieses Monats wird mehrfach mit demselben Datumsstempel neu gebaut
(2026.09-<date>-<시각>) — auch bei gleichem 2026.09 können unterschiedliche Versionen vorliegen.
Ein falscher Wert fällt nicht lautlos auf den Standardwert zurück, sondern wird sofort abgelehnt. Es gibt zwei Fälle.
| Situation | Logmeldung |
|---|---|
| Unbekannter Name | TS_TTM_MODEL_CLASS='…' 를 모른다 — ['ForDecomposedPrediction', 'ForPrediction'] 중 하나여야 한다 |
| Name korrekt, aber Bibliotheksversion zu alt | … 를 골랐는데 이 tsfm_public 판에 그 클래스가 없다 (granite-tsfm 0.3.9 이상 필요) |
Tiefenanalyse von Alarmen
| Werkzeug | Beschreibung |
|---|---|
get_alarm_stats | Zusammenfassung der Alarmstatistik — Häufigkeit, Prioritätsverteilung, Top-Alarme, Top-Tags |
analyze_alarm_duration | Analyse von Alarmdauer/MTTA — Erkennung von Verschlechterung, Trend der durchschnittlichen Erkennungszeit |
analyze_alarm_correlation | Korrelation Alarm–Sensor — welche Sensoränderungen Alarme auslösen |
Anlagen-Gesundheitsindex
get_asset_health — Zusammenfassung von Sensoren + OEE + RAM + EMS + Alarmen zu einem Gesundheitswert von 0–100 Punkten
Feature Store
Bietet mit vorberechneten Features und LLM-Kontext schnelle, umfassende Analysen.
| Werkzeug | Beschreibung |
|---|---|
get_feature_status | Status des Feature Store — Scheduler-Jobs, Ausführungszeitpunkte, Backfill-Status |
get_asset_features | Abfrage von Anlagen-Features — Gesundheitswert, Anomaliewert, Alarme, Status, Produktionskennzahlen |
get_asset_context | LLM-Kontext — vorab generierter zusammenfassender Analysetext pro Tag |
analyze_asset | Umfassende Anlagenanalyse — Gesundheitswert, Sensoren, Alarme, OEE/RAM/EMS, Ursachenhinweise |
explain_asset_anomaly | Ursachenanalyse von Anomalien — Ursachenschätzung anhand von Anomalie-Tags, Alarmen, Statusänderungen |
trigger_feature_pipeline | Manuelle Ausführung der Feature-Pipeline |
Architektur des Feature Store:
- Scheduler: automatische, stündliche (hourly) und tägliche (daily) Feature-Berechnung
- Embedding: Umwandlung der Anlagen-Features in Vektoren zur Unterstützung der Ähnlichkeitssuche
- LLM-Kontext: vorab generierte tägliche Analysetexte zur maximalen Beschleunigung der Antwortzeit
MCP-Ressourcen (6)
| Ressourcen-URI | Beschreibung |
|---|---|
plantpulse://system/info | Systeminformationen |
plantpulse://domains | Domänenliste und API-Endpunkte |
plantpulse://metrics/oee | Beschreibung der OEE-Metriken |
plantpulse://metrics/ram | Beschreibung der RAM-Metriken |
plantpulse://metrics/ems | Beschreibung der EMS-Metriken |
plantpulse://metrics/alarm | Alarmmetriken und Analysefähigkeiten |
Funde · Beachtung · Produktion (2026.10)
Werkzeuge, die lesen, was die Engine von sich aus festgehalten hat, und Fragen zur Produktion beantworten. Im Chat erscheinen sie mit dem Präfix insight_.
| Werkzeug | Beschreibung |
|---|---|
list_findings | Von der KI selbst gefundene Funde — Anlagenanomalie · Zielverfehlung bei Aufträgen · Datenunterbrechung · Datenqualität · Kettenstillstand · Ausfallrisiko · Grenzwerterreichung · Lastspitze · Änderung der KI-Konfiguration usw. Schweregrad · Dringlichkeit · Belegfakten · Status |
get_attention_ranking | Rangliste „Heute zuerst zu prüfende Anlage“ pro Standort — Beachtungswert (0–100) mit drei Gründen, Rangänderung gegenüber dem Vortag |
forecast_order_completion | Ob ein laufender Arbeitsauftrag bis zum geplanten Ende die Zielmenge erreicht — erwartete Gutmenge (P10–P90) · Erreichungswahrscheinlichkeit · Fehlmenge |
get_oee_losses | Warum die OEE niedrig ist — Verlustzeit bei Verfügbarkeit · Leistung · Qualität, die sechs großen Verluste, Stillstandsursachen |
get_spc_chart | Fehlerquoten-Regelkarte (p-Karte) für Anlage · Produkt — Mittellinie · Regelgrenzen · Anomaliesignale |
autonomy_status | Aktueller Status der selbstständigen KI-Verbesserung (Normalbaseline · Scorer) — Modus · verwendete Version · Schatten · Pausiert |
Ab 2026.10 Re-Release (2026-10-20) sind list_findings · get_attention_ranking von Anfang an aktiviert und beantworten „Welche Anlage sollte ich mir heute zuerst ansehen?“ · „Fass die offenen Erkenntnisse zusammen“ sofort.
Die vier forecast_order_completion · get_oee_losses · get_spc_chart · autonomy_status kommen deaktiviert herein; um sie in Abfragen zu nutzen, aktiviert ein Administrator sie in der
AI-Verwaltungskonsole unter MCP Gateway › Tools → MCP Gateway
Verständnis von Anlagen und Tags
Sind an einer Anlage mehrere Tausend Tags vorhanden, kann kein Mensch mehr jedes Einzelne erklären. Die folgenden Werkzeuge ordnen die Natur der Tags automatisch anhand realer Datenstatistik und Plattform-Metadaten.
| Werkzeug | Beschreibung |
|---|---|
list_asset_tags | Tag-Liste einer Anlage |
get_asset_profile | Anlagenprofil — Zuordnung, welcher Tag welche Eigenschaft hat |
get_asset_tag_relations | Korrelation zwischen Tags — Gruppierung gemeinsam sich bewegender Tags |
Fallsuche und -vergleich
| Werkzeug | Beschreibung |
|---|---|
find_similar_assets | Suche ähnlicher Anlagen — auf Basis von Vektor-Embedding und Kosinus-Ähnlichkeit |
find_similar_anomalies | Suche nach ähnlichen Anomaliefällen — ob in der Vergangenheit bereits eine gleichartige Anomalie auftrat |
find_fleet_outlier | Ausreißer in der Flotte — welche Anlage derselben Art sich allein abweichend verhält |
search_pattern | Mustersuche — Abschnitte finden, die einer angegebenen Wellenform ähneln |
check_failure_precursor | Prüfung auf Vorboten eines Ausfalls — ob derzeit Signale sichtbar sind, die früher vor einem Ausfall auftraten |
Anwendungsszenarien
| Szenario | Verwendete Werkzeuge |
|---|---|
| Frühzeitige Erkennung von Anlagenanomalien | detect_asset_anomaly → explain_asset_anomaly |
| Planung vorausschauender Instandhaltung | get_asset_health → forecast_asset → forecast_ram |
| Tägliches Anlagen-Briefing | get_asset_context → get_asset_features |
| Ursachenanalyse bei Alarmflut | get_alarm_stats → analyze_alarm_correlation → analyze_alarm_duration |
| Vergleichende Analyse ähnlicher Anlagen | analyze_asset → find_similar_assets |
| War diese Anomalie schon einmal da | detect_asset_anomaly → find_similar_anomalies |
| Ausfall vor dem Eintreten abfangen | check_failure_precursor → forecast_ram |
| Gleiche Anlage, aber nur eine abweichend | find_fleet_outlier → analyze_asset |
| Erkennung von Energieanomalien | detect_ems_anomaly → forecast_ems |
| Prognose der Produktionsqualität | detect_order_anomaly → forecast_order |
| Wird dieser Auftrag rechtzeitig fertig | forecast_order_completion → get_oee_losses |
| Wo sollte ich heute zuerst hinschauen | get_attention_ranking → list_findings |