HA-Konfiguration (Hochverfügbarkeit)
Die Plattform wird doppelt (A · B) nebeneinander betrieben, sodass auch bei einem totalen Ausfall einer Seite kein einziges Betriebsdatenobjekt verloren geht. Dies ist für Kraftwerke, große Anlagen und 24/365-unterbrechungsfreie Anlagen gedacht.
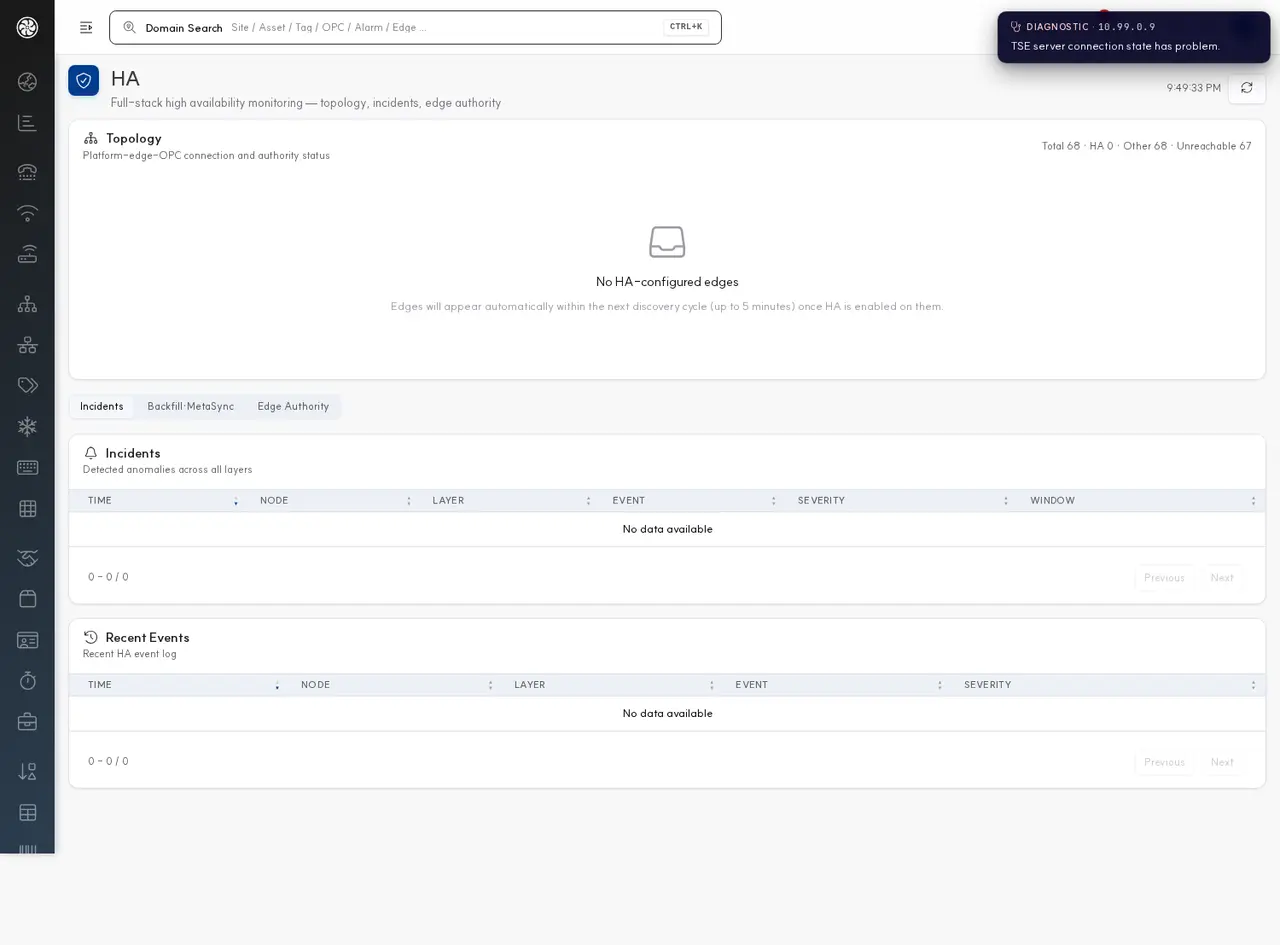
HA übernimmt die Verfügbarkeit, Konsistenz und Verlustfreiheit der Daten. Der Sicherheitszustand der Anlage wird bei jedem Softwarefehler unabhängig von der SPS / Sicherheits-SPS (SIS) gewährleistet (IEC 61508 / 61511 SIL). Die Plattform ist nicht der Garant für Sicherheit.
Zwei Zusagen
1 · Daten gehen nicht verloren
Der Abschnitt, der sich nur auf der Gegenseite angesammelt hat, während eine Seite ausgefallen war, wird nach der Wiederherstellung nur um den verpassten Anteil nachgezogen. Zeit wird weder berechnet noch geschätzt — denn der Kafka-Commit-Offset-Cursor weiß genau, wie weit empfangen wurde.
2 · Steuerung geht nur an eine Stelle aus
Steuerbefehle verhalten sich genau entgegengesetzt zu Daten. Sie gehen nicht an beide Seiten, sondern nur an den gesunden einzelnen Leader. Wenn die Autorität unklar ist, wird nicht gesendet (fail-closed).
Eine abgelehnte Verbindung ist vor der Übertragung, daher kann sie sicher an die andere Seite übergeben werden. Eine Zeitüberschreitung hingegen ist ein Zustand, bei dem „nicht bekannt ist, ob gesendet wurde oder nicht“ — daher wird nicht erneut versucht, denn ein erneuter Versuch wäre bereits eine Doppelbetätigung.
Konfiguration — Edge-Plattform-Paar
Eine SPS wird von zwei Edges jeweils gelesen und an unterschiedliche Plattformen gesendet. Dadurch empfangen beide Plattformen dieselben Daten live.
Eine SPS wird von zwei Edges unabhängig erfasst, Edge #1 sendet nur an A, Edge #2 nur an B. Das ist nicht dasselbe wie zwei Edges an einer Plattform — das wäre doppelte Speicherung.
Wenn sie am selben Switch hängen, ist dieser Switch ein Single Point of Failure und die Redundanz verliert ihren Sinn → Edge-Redundanz
Im Normalbetrieb wird nichts getan
plantpulse-ha Der Daemon läuft auf jeder Plattform permanent, aber im Normalzustand leitet er keinen Datenverkehr weiter. Die normale Versorgung beider Seiten erfolgt durch das obige Edge-Paar. Der Daemon arbeitet nur, nachdem eine Seite ausgefallen und wiederhergestellt wurde, und tut dabei zwei Dinge.
| Aufgabe | Was |
|---|---|
| Zeitserien-Backfill | Abonniert das pp-batch-Topic des Peers und veröffentlicht nach der lokalen Wiederherstellung nur den während des Ausfalls verpassten Abschnitt erneut auf das lokale pp-batch. Da der bestehende batch-web dieses direkt übernimmt, muss der Zielcode nicht angefasst werden |
| PG-Metadatensynchronisation | Konfigurationen, die nicht über Kafka laufen, wie Tag-Metadaten, Anlagenstruktur und Alarmdefinitionen, werden alle 60 Sekunden per Pull vom sekundären Cluster aus der PG des primären Clusters geholt |
Die PG-Metadatensynchronisation überträgt auch die Daten der Vor-Ort Tablet-App (frontline) — Bedienerkonten und Zuständigkeitsbereiche (einschließlich PIN-Hash), Kiosk-Einstellungen · Stillstandsgrundlisten pro Anlage · registrierte Tablets. Der KI-Schlüssel wird nur bei metasync.include.tokens=true übertragen; Sitzungen · Audit-Log · Anmelde-Cache bleiben pro Knoten getrennt (frontline-Hochverfügbarkeit).
event und nicht pp-batch istpp-batch ist die Form nachdem CEP bereits durchlaufen wurde. Daher löst eine Wiedergabe am Ziel kein erneutes CEP aus. Das alte Modell (ständiges Fan-out des event-Topics) wurde wegen erneuter CEP-Auslösung und ständiger Doppelübertragungslast verworfen.
Wie der Backfill ankommt
INIT → GUARD → WAIT_LOCAL_READY → CATCH_UP → TAIL
                                     ↑          ↓
                                   PAUSED ←─────┘   (헬스 상실 / 회복)
| Zustand | Was |
|---|---|
GUARD | Wenn die clusterId von Peer und lokal identisch ist, wird der Start verweigert — Schutz gegen den Peer als sich selbst |
WAIT_LOCAL_READY | Wartet, bis die Health des lokalen server-web stabil ist |
CATCH_UP | Veröffentlicht den Abschnitt vor dem Grenzzeitpunkt T_b erneut auf das lokale System |
TAIL | Verwirft alles nach T_b, da der Edge diesen Abschnitt bereits lokal eingefügt haben sollte |
PAUSED | Stoppt und committet nicht, wenn die Health verloren geht |
INCIDENT | Wenn ein Abschnitt aufgrund der Retention nicht gelesen werden konnte, wird dies protokolliert und ab earliest fortgesetzt |
Das Umschaltkriterium ist nicht der Consumer-Lag, sondern «Rekord-Zeitstempel gegen feste Grenze T_b». Bei Partitionen mit wenig Verkehr führt eine Beurteilung anhand des Lags zu Fehlurteilen und Flapping.
In TAIL wird ebenfalls ein 60-sekündiger verzögerter Commit durchgeführt (commit.lag.seconds) — damit das kurze Fenster unmittelbar vor der Erkennung des Health-Verlusts natürlich vom nächsten CATCH_UP abgedeckt wird.
Die Schleife ist strukturell blockiert
Wiedergegebenen Datensätzen wird der pp-ha-origin-Header hinzugefügt. Datensätze mit diesem Header werden nicht erneut wiedergegeben — es geht nur von Original (h=0) → Wiedergabe (h=1), und h=1 stoppt.
Duplikate werden absorbiert
In der Nähe der Grenze kann derselbe Datensatz zweimal ankommen, aber da die Aster-TSDB-Neuladung idempotent auf Basis von tag_id + timestamp ist, bleiben weder Verluste an Tag-Punkten noch Duplikate zurück.
Garantien und Grenzen
Wenn die Ausfallzeit länger ist als die Aufbewahrungsdauer des pp-batch-Peers, kann dieser Teil nicht automatisch nachgeholt werden.
Dieser Abschnitt wird unter INCIDENT protokolliert und muss zur Wiederherstellung über backfill.force.from manuell neu abgespielt werden. Planen Sie die Aufbewahrungsdauer länger als die erwartete maximale Ausfallzeit ein.
| Grenze | Inhalt |
|---|---|
| Statistikzähler sind nicht idempotent | Die Neuladung von Tag-Punkten ist vollständig idempotent, aber Statistikzähler in der Form count = count + ? können bei doppelter Wiedergabe zu hohe Werte anzeigen |
| Asymmetrische Störungen können nicht behoben werden | Wenn nur eine Edge ausfällt und nur eine Seite nicht mehr versorgt wird, ist die lokale Plattform selbst gesund, sodass das Health-Gate dies nicht erkennt → manuelle Wiederholung |
| PG-Synchronisation ist unidirektional | Primär → Sekundär. Konsolen-Einstellungen sollten daher immer nur am primären Cluster geändert werden — Änderungen am sekundären werden im nächsten Zyklus überschrieben |
Standorte mit nur einer Edge — Doppelübertragungs-Client
Wenn zwei Edges nicht möglich sind, überträgt der Collector direkt doppelt an beide Cluster.
Da plantpulse-api-ha dieselbe Oberfläche wie das bestehende APIClient bietet, muss nur die Erzeugungsseite ersetzt werden.
- Schreiben wird an alle Ziele gefächert und sofort zurückgegeben (gebundene Warteschlange + Worker + Backoff pro Ziel).
- Lesen erfolgt Leader-first + Failover + Sticky.
- Die Topologie wird durch Polling der
/api/clusterdes HA-Daemons alle 10 Sekunden zwischengespeichert (last-known-good).
Betrieb
# 기동 · 정지 (각 플랫폼에서)
sh/start.sh [설정파일]     # 기본 config/plantpulse-ha.properties, 이미 떠 있으면 WARN + exit 0
sh/stop.sh                 # SIGTERM → 15초 대기 → SIGKILL
sh/log-viewer.sh
Das Bereitstellungslayout ist <서비스 루트>/plantpulse-ha/{sh,lib,logs,config,etc}.
Bei einem Ausfall
| Situation | Was passiert |
|---|---|
| Cluster B ausgefallen | A lädt weiter. Wenn B wiederhergestellt ist, liest B's Daemon über CATCH_UP den Abschnitt, der nur auf A liegt, und veröffentlicht ihn auf B → Konvergenz |
| Nur der Daemon ausgefallen | Der Commit-Offset liegt nicht im Daemon, sondern im Peer-Broker. Nach dem Neustart wird ab dem letzten Commit fortgesetzt (das Health-Gate muss erneut passiert werden) |
| Konfigurationsänderung am primären Cluster | Der sekundäre Cluster übernimmt den Diff im nächsten Zyklus (60 Sekunden) |
Siehe auch
Edge-Redundanz (HA) · Backup · Wiederherstellung · Cluster-Installation