Diagnose
Inhaltsverzeichnis
- Überblick
- Bildschirmaufbau
- Suchbereich oben
- Zeitleiste
- Links — Diagnoseprotokolltabelle
- Rechtes Statistikpanel (3 Panels)
- Gesamtausgabe (CSV)
- Standarddiagnoseverfahren bei Störungen
- Häufige Diagnosemeldungsmuster
- Häufig gestellte Fragen
- Verwandte Bildschirme
Überblick
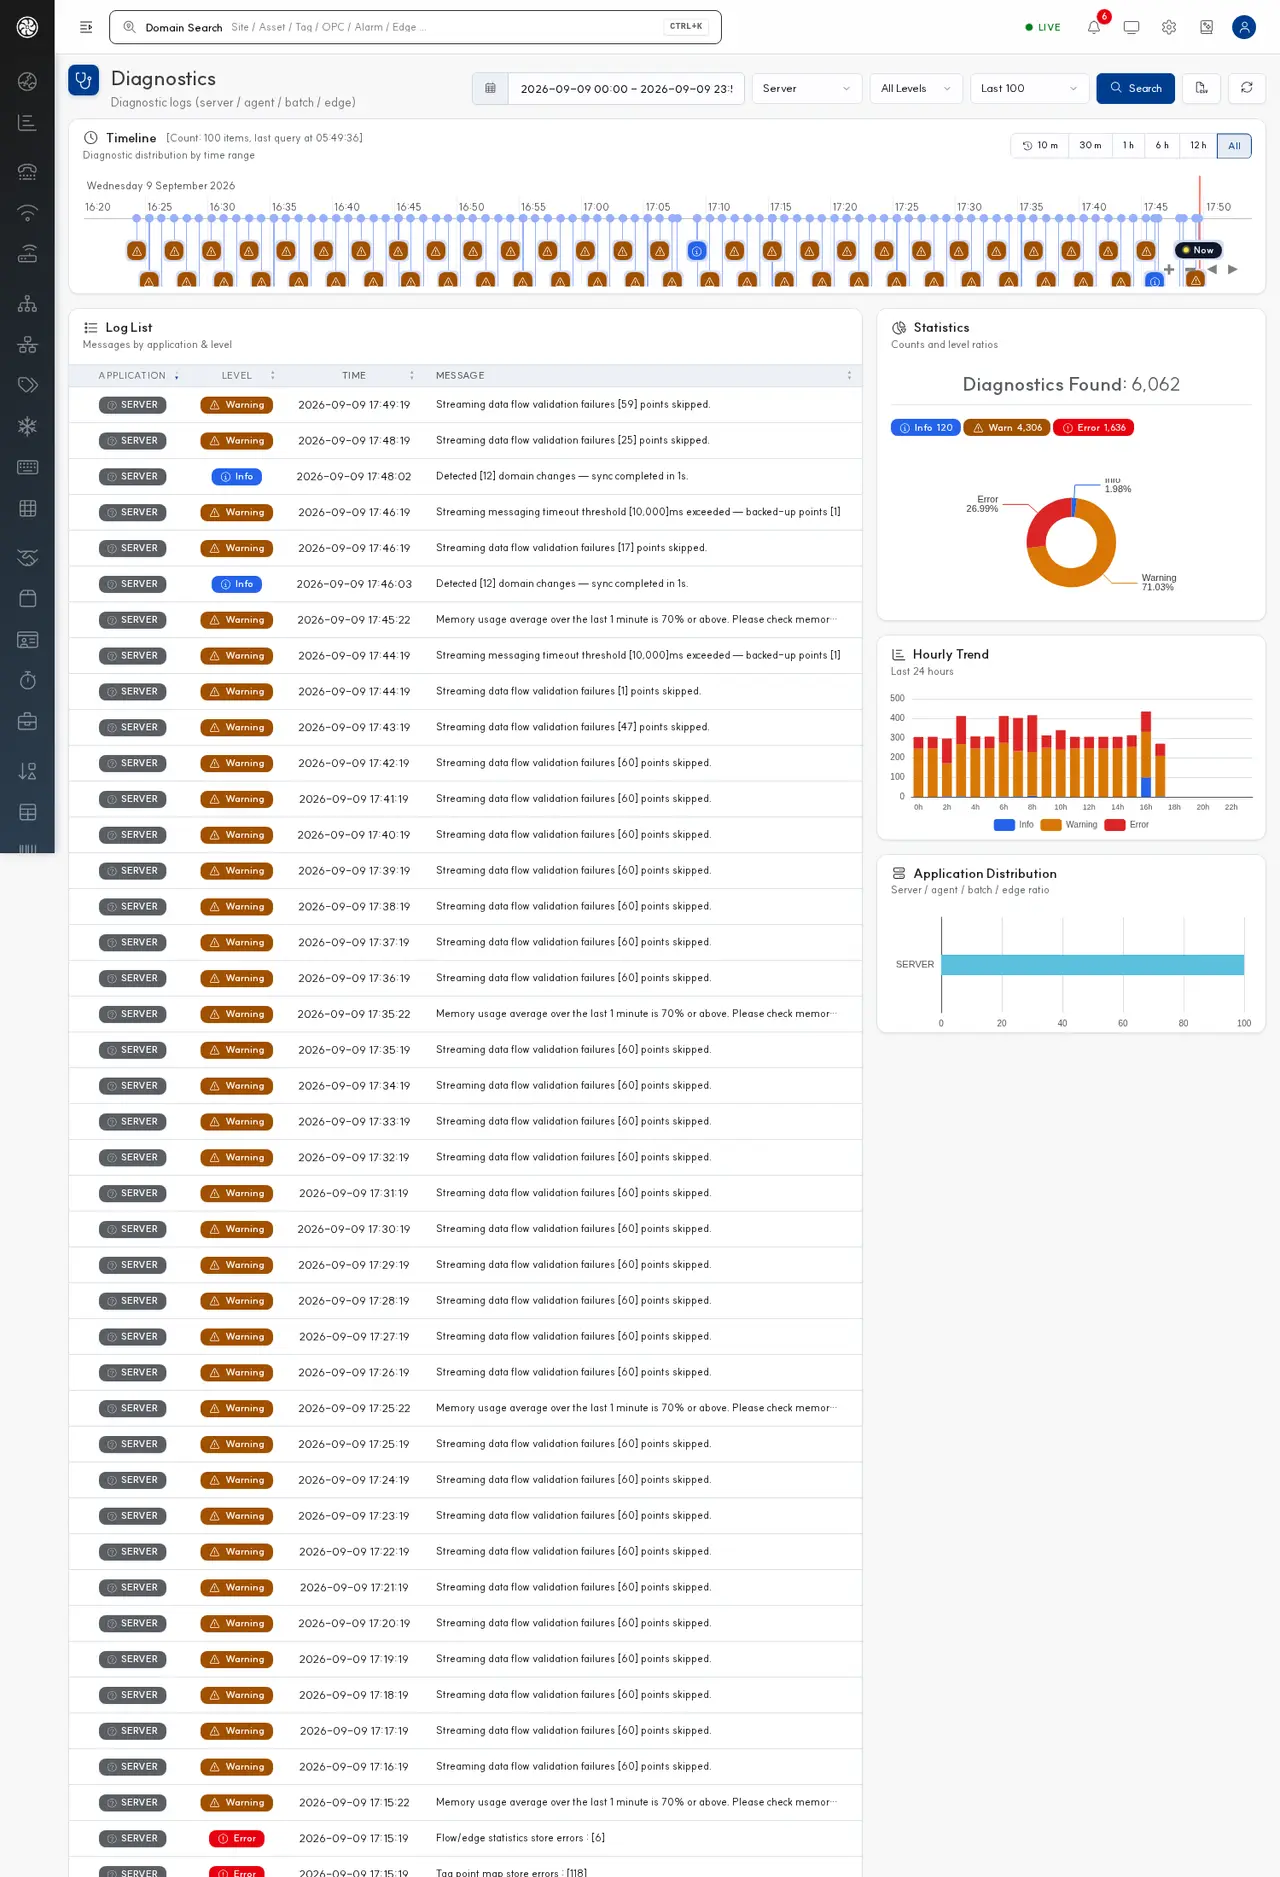
Der Diagnosebildschirm zeigt alle im Plattforminneren aufgetretenen Diagnoseereignisse (Information·Warnung·Kritisch) gleichzeitig aus drei Perspektiven: als chronologische Zeitleiste, als Tabelle und als Statistikdiagramme. Dieser Bildschirm ist der erste Anlaufpunkt für Systemadministratoren oder Betreiber, um die Ursache von Störungen zu ermitteln.
Dieser Bildschirm vereint die folgenden Funktionen:
- Zeitleiste — auf einen Blick, wo und was im Zeitverlauf passiert ist
- Protokolltabelle — exakte Uhrzeit·Anwendung·Stufe·Meldungsinhalt
- Statistikpanel — Stufenanteile·Zeitverteilung·Anwendungsverteilung
Pfad: Linkes Menü > System > Diagnose (interne URL /diagnostic/index)
Bildschirmaufbau
┌───────────────────────────────────────────────────────────────────────────────┐
│ 🩺 진단                                                                          │
│   [기간]  [애플리케이션]  [레벨]  [건수]  [조회] [전체 출력] [↻]                  │ ← ① 검색 영역
├───────────────────────────────────────────────────────────────────────────────┤
│                          타임라인 + 빠른 시간 범위                                │ ← ② 타임라인
├──────────────────────────────────────────────────────────┬────────────────────┤
│                                                          │ 🥧 통계             │
│                  진단 로그 테이블                          │  검색된 진단 N건    │
│      애플리케이션 │ 레벨 │ 시간      │ 메세지              │  정보·경고·심각 뱃지│ ← ③
│      ...                                                 │  레벨 비율 차트     │
│                                                          ├────────────────────┤
│                                                          │ 📊 시간별 발생 추이 │
│                                                          ├────────────────────┤
│                                                          │ 🖥 애플리케이션별  │
│                                                          │   분포              │
└──────────────────────────────────────────────────────────┴────────────────────┘
| Bereich | Position | Anzeige |
|---|---|---|
| ① Suchbereich | Formular oben rechts | Zeitraum·Anwendung·Stufe·Anzeigenanzahl + Abfragen/Gesamtausgabe/Aktualisieren |
| ② Zeitleiste | Volle Breite | Diagnosemarker auf Zeitachse + 6 Schnellzeitbereich-Buttons |
| ③ Links | col-lg-8 | Diagnoseprotokolltabelle (feste 4 Spalten) |
| ③ Rechts | col-lg-4 | 3 Statistikpanels (Stufenanteil·Zeitverlauf·Anwendungsverteilung) |
Suchbereich oben
Das Suchformular oben rechts auf der Seite ist einzeilig angeordnet und enthält von links nach rechts die folgenden Steuerelemente.
Eingabefelder und Buttons
| Steuerelement | Breite | Form | Standardwert·Optionen | Beschreibung |
|---|---|---|---|---|
Zeitraum (search_time) | 280px | Texteingabe (mittig ausgerichtet, fett) | Leer | Beim Klicken öffnet sich ein Datums-/Zeitbereichsauswahl, um Start-/Endzeit festzulegen. Im Formular wird dies über hidden-Felder search_date_from / search_date_to übergeben |
Anwendung (app_name) | 120px | Dropdown | Server (SERVER), Agent (AGENT), Batch (BATCH), Edge-Gateway (EDGE) | Modul, das die Diagnose ausgegeben hat |
Stufe (level) | 100px | Dropdown | Alle Stufen, Information (INFO), Warnung (WARN), Kritisch (ERROR) | Filter für Diagnosestufe. Leerer Wert bedeutet alle |
Meldungssuche (message) | 250px (ausgeblendet) | Texteingabe | Leer | Stichwortsuche im Meldungstext. Standardmäßig ausgeblendet, je nach Betriebsumgebung einblendbar |
Anzahl (limit) | 130px | Dropdown | 100, 200, 300, 500, 1.000 | Anzahl der anzuzeigenden letzten Diagnoseeinträge |
| Abfragen | (automatisch) | Roter Button + 🔍 | — | Diagnosedaten mit den obigen Bedingungen abfragen |
| Gesamtausgabe | (automatisch) | Roter Button + 📄 | — | Diagnoseergebnis der aktuellen Bedingungen als CSV-Datei herunterladen |
Aktualisieren (realtime_icon) | (automatisch) | Roter Button + ↻ | — | Erneutes Abfragen mit den vorherigen Bedingungen — kann als Dashboard verwendet werden |
Bedeutung des Anwendungs-Dropdowns
| Wert | Label | Beschreibung |
|---|---|---|
SERVER | Server | Webserver·Verwaltungskonsole·Domänendienste |
AGENT | Agent | Datenerfassungsagent (Pipeline) |
BATCH | Batch | Batchverarbeitung·Aggregation·Berichtserstellung |
EDGE | Edge-Gateway | Edge-Gerät (vor Ort installierte Gateways) |
Bedeutung des Stufen-Dropdowns
| Wert | Label | Farbe | Bedeutung | Empfohlene Maßnahme |
|---|---|---|---|---|
| `` (leerer Wert) | Alle Stufen | — | Alle Stufen | |
INFO | Information | Blau | Informationen zum normalen Betrieb·Start-/Stopp-Meldungen usw. | Keine Maßnahme erforderlich |
WARN | Warnung | Orange | Potenzielle Probleme·Soft-Grenzwert überschritten | Trend prüfen, andere Module im gleichen Zeitraum inspizieren |
ERROR | Kritisch | Rot | Fehler·Funktionsstörung·Ausnahme | Sofortige Ursachenanalyse + Systemadministrator |
Zeitleiste
Unterhalb des Suchbereichs wird im Panel die Diagnosezeitleiste dargestellt.
| Element | Beschreibung |
|---|---|
| Kopfzeile | 🕐 "Zeitleiste" + kleine Schrift rechts mit Zusammenfassung der Suchergebnisse (result_txt) |
| Zeitleisteninhalt | alarm_timeline — Horizontale Zeitachse, Diagnoseeinträge als farbige Marker |
| Markerfarbe | Information=Blau, Warnung=Orange, Kritisch=Rot |
| Hover | Beim Überfahren eines Markers erscheint ein Tooltip mit Zeit + Meldungsvorschau |
| Klick | Die entsprechende Zeile wird in der linken Tabelle automatisch hervorgehoben |
Schnelle Zeitbereiche (Timeline range)
Mit den 6 Buttons rechts in der Zeitleistenkopfzeile kann sofort gezoomt werden.
| Button | data-range | Aktion |
|---|---|---|
| Vor 10 Minuten | 10M | Zoomt auf den Zeitraum der letzten 10 Minuten |
| Vor 30 Minuten | 30M | Zoomt auf den Zeitraum der letzten 30 Minuten |
| Vor 1 Stunde | 1H | Zoomt auf den Zeitraum der letzten Stunde |
| Vor 6 Stunden | 6H | Zoomt auf den Zeitraum der letzten 6 Stunden |
| Vor 12 Stunden | 12H | Zoomt auf den Zeitraum der letzten 12 Stunden |
| Gesamter Zeitraum | ALL | Gesamter Suchzeitraum (standardmäßig aktiv) |
Die Schnellbereich-Buttons wenden nur einen Zoom auf die bereits auf dem Bildschirm angezeigten Ergebnisse an. Um einen längeren Zeitraum zu sehen, muss im Suchbereich über das Zeitraum-Feld neu abgefragt werden.
Links — Diagnoseprotokolltabelle
| 애플리케이션 | 레벨 | 시간              | 메세지                                |
|-------------|------|------------------|--------------------------------------|
| server      | ERROR| 2026-05-08 12:00 | Connection timeout to upstream...     |
| messaging   | WARN | 2026-05-08 11:55 | Buffer overflow threshold reached...  |
| Spalte | Breite | Ausrichtung | Anzeige |
|---|---|---|---|
| Anwendung | 140px | Mitte | Name des Moduls, das die Diagnose ausgegeben hat (z. B.: server, agent, batch, edge) |
| Stufe | 80px | Mitte | Farbiges Badge — INFO(Blau) / WARN(Orange) / ERROR(Rot) |
| Zeit | 160px | Mitte | Zeitpunkt des Diagnoseereignisses (yyyy-MM-dd HH:mm:ss) |
| Meldung | Automatisch (Rest) | Links | Diagnosetext (wird bei table-layout: fixed an die Zellbreite angepasst abgeschnitten — für vollständige Anzeige mit Zeilenumbruch Zeile doppelklicken oder mit der Maus darüberfahren) |
Zeileninteraktion
- Hover: Zeilenhintergrund wird hervorgehoben
- Klick: Der entsprechende Marker in der Zeitleiste wird synchron hervorgehoben (links·rechts Synchronisierung)
- Doppelklick/Popup: Vollständiger Text und Stacktrace usw. werden in einem modalen Fenster angezeigt
Seitennavigation unterhalb der Tabelle
Bei vielen Ergebnissen wird auf Seiten umgebrochen. Die Anzahl der Zeilen pro Seite richtet sich nach der Anzahl-Dropdown im Suchbereich (100/200/300/500/1.000).
Rechtes Statistikpanel (3 Panels)
Statistische Visualisierung der Suchergebnisse. Alle zeigen dieselben Daten wie die linke Tabelle, nur aus einer anderen Perspektive.
1. Statistik — Stufenanteil (diag_level_chart)
┌────────────────────────────────┐
│  검색된 진단 : N 건             │  ← 큰 글씨 헤드라인
│  [정보 N] [경고 N] [심각 N]     │  ← 3색 뱃지
│                                │
│        도넛/막대 차트           │  ← diag_level_chart (150px 높이)
└────────────────────────────────┘
| Element | ID | Anzeige |
|---|---|---|
| Überschrift | — | "Gefundene Diagnosen : N" in großer Schrift |
| Gefundene Gesamtanzahl | diag_total_count | Ganzzahl |
| Info-Badge | diag_info_count | Anzahl der Info-Stufen — blauer Hintergrund |
| Warn-Badge | diag_warn_count | Anzahl der Warn-Stufen — oranger Hintergrund |
| Kritisch-Badge | diag_error_count | Anzahl der Kritisch-Stufen — roter Hintergrund |
| Stufenanteilsdiagramm | diag_level_chart | Diagramm des Anteils von Information·Warnung·Kritisch |
| Leerzustandshinweis | diag_stats_empty | Bei fehlenden Daten wird "Keine Daten vorhanden." angezeigt |
2. Zeitlicher Verlauf (diag_hourly_chart)
| Element | Beschreibung |
|---|---|
| Kopfzeile | 📊 "Zeitlicher Verlauf" |
| Diagramm | Balkendiagramm nach Zeitraum (Stunden) (170px hoch) — X-Achse Zeit, Y-Achse Diagnoseanzahl |
| Balkenaufteilung | Information/Warnung/Kritisch werden farblich gestapelt dargestellt |
Interpretation: Wenn der Balken in einem Zeitraum plötzlich ansteigt, gab es in dieser Zeit ein massives Problem. Zeit notieren und in der linken Tabelle die Zeilen dieses Zeitraums doppelklicken, um Details anzuzeigen.
3. Verteilung nach Anwendung (diag_app_chart)
| Element | Beschreibung |
|---|---|
| Kopfzeile | 🖥 "Verteilung nach Anwendung" |
| Diagramm | Donut-/Balkendiagramm (140px hoch) — Diagnoseanzahl pro Anwendung |
Interpretation: Wenn eine Anwendung mehr als 70 % der Gesamtanzahl ausmacht, deutet dies auf eine Konzentration von Störungen in diesem Modul hin. Im Suchbereich über die Anwendung-Dropdown eingrenzen und dann die linke Tabelle ansehen.
Gesamtausgabe (CSV)
Durch Klicken auf den Gesamtausgabe-Button im Suchbereich können alle Diagnosen mit den aktuellen Suchbedingungen als CSV-Datei heruntergeladen werden.
CSV-Spalten
| Spalte | Format |
|---|---|
| Anwendung | Text |
| Stufe | Text (INFO/WARN/ERROR) |
| Zeit | Text (yyyy-MM-dd HH:mm:ss) |
| Meldung | Text (mit doppelten Anführungszeichen maskiert) |
Die CSV-Ausgabe exportiert nicht nur die auf dem Bildschirm sichtbaren Zeilen, sondern alle Ergebnisse, die den Suchbedingungen entsprechen. Sie ist nicht von der Anzahl-Dropdown (letzte N Einträge) abhängig und daher für Langzeitanalysen geeignet.
Tipps zur CSV-Nutzung
- Beim Weiterleiten an Systemadministratoren als Archiv (.zip) anhängen
- In externe Analysetools (Tabellenkalkulation·BI-Tools) importieren und zusätzliche Analysen nach Modul·Zeitraum·Stichwort durchführen
- Eine Woche an Daten zusammenführen und vergleichen, ob dasselbe Muster täglich wiederkehrt
Standarddiagnoseverfahren bei Störungen
Bei einer Störung gehen Sie am effizientesten in der folgenden Reihenfolge vor.
Schritt 1 — Zeitraum eingrenzen
- Im Zeitraum-Feld den Störungszeitpunkt ±10 bis ±30 Minuten angeben
- Anzahl auf 1.000 setzen (damit nichts übersehen wird)
Schritt 2 — Zuerst Kritisch abfragen
- Stufe-Dropdown auf Kritisch(ERROR) stellen → Abfragen
- Die erste Zeile in der linken Tabelle (neuester ERROR) prüfen und Meldung ansehen
- Im rechten Verteilung nach Anwendung-Diagramm prüfen, welches Modul die meisten ERROR erzeugt
Schritt 3 — Warnungen im gleichen Zeitraum prüfen
- Stufe auf Warnung(WARN) ändern und denselben Zeitraum abfragen
- WARN-Meldungen prüfen, die 1–5 Minuten vor dem ERROR aufgetreten sind — sie sind oft Hinweise auf die Ursache
Schritt 4 — Nach Modul eingrenzen
- Die Anwendung mit den meisten ERROR/WARN über die Anwendung-Dropdown auswählen
- Stufe wieder auf Alle Stufen setzen, um alle Flüsse innerhalb des Moduls zu sehen — ein Abbruch der INFO-Meldungen ist ein Hinweis
Schritt 5 — Meldungsmuster
Den Meldungstext in der linken Tabelle prüfen. Unterscheiden, ob dieselbe Meldung wiederholt auftritt (Regel-Sturm) oder nur einmal (externe Zustandsänderung).
Schritt 6 — Übergabe an Systemadministrator
Wenn der Betreiber die Störungsursache nicht selbst beheben kann, über den Gesamtausgabe-Button die CSV-Datei erstellen und an den Systemadministrator weiterleiten. Dem Bericht sollten Sie Folgendes beilegen:
- Zeitpunkt des Störungsbeginns (Zeit des ersten ERROR)
- Betroffener Umfang (welcher Standort/welches Modul)
- Text von 1–3 ERROR-Meldungen
- CSV-Datei
Häufige Diagnosemeldungsmuster
| Meldungsstichwort | Bedeutung | Allgemeine Maßnahme |
|---|---|---|
Connection timeout | Zeitüberschreitung bei externen Dienstverbindungen | Netzwerkstatus·Verfügbarkeit des Zieldienstes prüfen |
Out of memory / OOM | Speichermangel | Systemressourcen prüfen·Neustart in Betracht ziehen (Systemadministrator) |
Disk space low | Nicht genügend Speicherplatz | Alte Daten bereinigen oder Datenträger erweitern |
Authentication failed | Authentifizierung fehlgeschlagen | Token·Kontoinformationen auf Ablauf/Fehler prüfen |
Buffer overflow | Verarbeitungswarteschlange voll | Trigger-Vorfilter·Externe IO-Drosselung zur Lastglättung |
Job already running | Job-Doppelausführung | Vorheriger Job unvollständig — Prüfung durch Systemadministrator |
Failed to parse | Meldungsanalyse fehlgeschlagen | Payload-Format des externen Systems prüfen |
Schema mismatch | DB-/Meldungsschema stimmt nicht überein | Prüfung durch Systemadministrator (kann direkt nach einer Bereitstellung auftreten) |
Pipeline exception | Ausnahme in der Datenpipeline | Zusätzlich das Detaildiagramm für ausgewählten Tag der Tagesstatistik prüfen |
Edge disconnect | Edge-Gerät getrennt | Gerätestatus in Verbindungsverwaltung prüfen |
Häufig gestellte Fragen
F. Das Eingabefeld für die Meldungssuche (Stichwort) wird nicht angezeigt.
A. Je nach Betriebsumgebungskonfiguration kann die Suche im Meldungstext deaktiviert sein (display:none). Wenden Sie sich an den Systemadministrator, um sie zu aktivieren.
F. Wie lange werden Diagnosedaten aufbewahrt?
A. Standardmäßig 7 Tage. Für langfristige Aufbewahrung die CSV über Gesamtausgabe in einem externen System ablegen oder über den Diagnose-Trigger (flow_on_diagnostic) im Flow automatisch in ein externes Protokollsystem laden.
F. Es sind sehr viele ERROR aufgelaufen, alle mit derselben Meldung. Kann ich sie ignorieren? A. Wenn derselbe ERROR in kurzer Zeit wiederholt auftritt, ist dies ein Zeichen für eine einzige ausufernde Ursache, und die bloße Anzahl sagt wenig aus. Zuerst den Zeitpunkt des ersten Auftretens und die Meldung selbst ansehen.
F. Kann der Aktualisieren-Button in eine automatische Aktualisierung umgewandelt werden? A. Der Bildschirm unterstützt nur explizites Aktualisieren. Für automatische Aktualisierungen im Betriebsmonitoring klicken Sie in kurzen Abständen auf Aktualisieren oder richten Sie über Flow eine Push-Benachrichtigung bei Auftreten eines ERROR ein.
F. Die Marker in der Zeitleiste sind zu dicht gedrängt. A. Reduzieren Sie die Anzahl-Dropdown auf einen kleineren Wert (100–200 Einträge) oder grenzen Sie die Stufe auf ERROR/WARN ein, um die Lesbarkeit zu verbessern.
F. Alle Module haben zum gleichen Zeitpunkt einen ERROR ausgegeben. A. Dies deutet stark auf eine Störung der gemeinsamen Infrastruktur (Nachrichtenkanal·Speicher) hin. Prüfen Sie zusätzlich den Infrastruktur-/Engine-Status in der Health-Leiste rechts im Dashboard.
F. Der CSV-Download dauert lange. A. Die Suchbedingungen sind wahrscheinlich zu breit gefasst. Reduzieren Sie den Zeitraum auf 24 Stunden oder weniger oder schränken Sie die Module ein.
Verwandte Bildschirme
- Dashboard — Vorschau der letzten Diagnosen in der Health-Leiste rechts
- Tagesstatistik — Systemdiagnosetrends und Verteilung von Ausnahmetypen/-codes
- Alarm — Domänenalarmhistorie
- Verbindungsverwaltung — Status von Edge-/OPC-Geräten
- Flow — Automatische Diagnoseweiterleitung über
flow_on_diagnostic-Trigger