Flow (Flow)
Inhaltsverzeichnis
Erste Schritte
Bildschirm-Leitfäden
Nachrichten-/Knoten-Referenz
- Nachrichtenstruktur · Payload-Beispiele nach Trigger · Node-Katalog
- Trigger · Filter · Transformation
- Aktion — Integration/Speicherung · Anlagen-Ereignis-Veröffentlichung · Domain CRUD
- Edge (22종) · Externe Anbindung · Ablaufsteuerung
- Detaillierte Node-Optionsreferenz · Script-Node-Erstellung · JS-Ausführungsumgebungsspezifikation · Speichersichere Erstellungsmuster · Mobiler Push-Benachrichtigungskanal · Automatische Aktualisierung externer Authentifizierungstoken
Beispiele·Muster
Betrieb
Produktionsbetrieb
- Häufig gestellte Fragen (FAQ) · Best Practices für den Betrieb · Sicherheit·Umgang mit sensiblen Informationen
- Flow-Metriken und Alarme · Nachrichtenverarbeitungssemantik und Backpressure · Was in der Ausführungshistorie zu sehen ist
- Cluster·HA-Verhalten · End-to-End-Trace · Katalog der Graph-Muster · Best Practices für Flow-Tests
- Leistungsgrenzen und Tuning · Audit·Historien-Tracking · Checkliste für die Bereitstellung neuer Flows · Bereitstellungsstrategie (Canary/Blue-Green/A·B) · Notfallreaktionsverfahren
- Schnelle Node-Konfigurationsreferenz · Flow REST API · Webhook-Trigger · OPC/PLC-Industrieintegrationsmuster
- Cookbook für externe Systemintegration · Cookbook für Datentransformation · Sammlung wiederverwendbarer Skripte
Fehlerbehebung
Sonstiges
Übersicht
Flow ist ein Automatisierungsmenü, mit dem Sie die Datenanbindung an externe Systeme (MES/ERP/SCADA usw.) sowie die automatische Erstellung/Aktualisierung von Domänenobjekten (Tag, Anlage, Arbeitsauftrag, Mitarbeiter usw.) als visuellen Graphen definieren. Operatoren können Automatisierungsszenarien ohne Programmierkenntnisse selbst entwerfen, bereitstellen und betreiben.
Über 100 Knotentypen werden per Drag & Drop auf die Canvas platziert und über Wires verbunden, um Datenverarbeitungspipelines zu erstellen.
Pfad: Linkes Menü > Automation > Flow
Lernpfad — Empfohlene Einstiegsreihenfolge nach Rolle
Dieses Handbuch ist ein umfassender Leitfaden mit über 4.000 Zeilen. Es ist effizient, mit dem Abschnitt zu beginnen, der Ihrer Rolle und Ihrem Ziel entspricht.
👶 Erstbenutzer (ersten Flow innerhalb einer Stunde erstellen)
- Kernkonzepte — 5 Minuten
- Erste Schritte — 5 Minuten
- End-to-End-Tutorial — 30 Minuten (Schritte 1–10 folgen)
- Bildschirmaufbau + Bearbeitungsbildschirm — 10 Minuten
- Beispiel-Flows 1·2·3 nachvollziehen — 10 Minuten
→ Erster Flow bereitgestellt. Danach benötigte Knoten im Node-Katalog suchen.
🧑🏭 Vor-Ort-Operator (Erstellung von Automatisierungsszenarien)
- Payload-Beispiele nach Trigger — reale Datenstruktur verstehen
- Detaillierte Node-Optionsreferenz — häufig verwendete Node-Optionen kennenlernen
- Cookbook für Datentransformation — gängige Transformationsmuster kopieren
- Katalog der Graph-Muster — Verdrahtungsmuster auswählen
- Beispiel-Flows (17종) — fertige Beispiele je Szenario
🛠 Systemadministrator (Betrieb·Tuning·Störungsbehebung)
- Flow-Metriken und Alarme — welche Kennzahlen zu beobachten sind
- Was in der Ausführungshistorie zu sehen ist — Diagnoseprotokolle interpretieren
- Cluster·HA-Verhalten — Multi-Node-Umgebung verstehen
- End-to-End-Trace — problematische Nachrichten verfolgen
- Leistungsgrenzen und Tuning + Notfallreaktionsverfahren
🔌 Entwickler·Integrationsingenieur (Anbindung externer Systeme)
- Cookbook für externe Systemintegration — Slack/Teams/Jira/SAP-Beispiele
- Flow REST API — Flow programmatisch steuern
- Webhook-Trigger — Flow von außen auslösen
- OPC/PLC-Industrieintegrationsmuster — Szenarien für den Industriebetrieb
- JS-Ausführungsumgebungsspezifikation + Sammlung wiederverwendbarer Skripte
🔐 Sicherheitsverantwortlicher (Audit·Authentifizierung)
- Sicherheit·Umgang mit sensiblen Informationen — Aufbewahrung von Anmeldedaten
- Automatische Aktualisierung externer Authentifizierungstoken — Betrieb von OAuth2-Token
- Berechtigungen — mögliche Aktionen je Rolle
- Audit·Historien-Tracking — Aufbewahrung von Änderungs-/Ausführungshistorie
📚 Schnellreferenz (für bereits erfahrene Benutzer)
| Gesuchte Information | Abschnitt |
|---|---|
| Node-ID und Kurzbeschreibung | Node-Katalog |
| Standardwerte der Node-Optionen | Detaillierte Node-Optionsreferenz |
| JSON-Beispiele für Nachrichten | Payload-Beispiele nach Trigger |
| Direkt verwendbare Skripte | Sammlung wiederverwendbarer Skripte · Cookbook für Datentransformation |
| API-Aufruf curl | Flow REST API |
| Interpretation der Ausführungshistorie | Was in der Ausführungshistorie zu sehen ist |
| Leitfaden zur Fehlerbehebung | Schrittweiser Debugging-Leitfaden · Häufig auftretende Probleme |
| Schnelle Optionsübersicht | Schnelle Node-Konfigurationsreferenz |
Alle Abschnittslinks sind Anker innerhalb desselben Dokuments. Auch die Stichwortsuche mit
Ctrl+Fist wirksam.
Kernkonzepte
| Begriff | Beschreibung |
|---|---|
| Flow (Flow) | Ein einzelner Automatisierungs-Workflow, der aus einer Menge von Knoten und Wires (Beziehungen) besteht. Es handelt sich um einen gerichteten Graphen mit Einstiegspunkt, dessen Aktivierung über den Bereitstellen/Aufheben-Schalter gesteuert wird |
| Node (Node) | Eine Einheit, die eine Nachricht empfängt, verarbeitet und an den nächsten Node weiterleitet. Unterteilt in 7 Kategorien (Trigger·Filter·Transformation·Aktion·Externe Anbindung·Ablaufsteuerung·Edge) |
| Relation (Relation) | Das Label des Wires vom Node-Ausgang zum nächsten Node. Der Node bestimmt die Verzweigung direkt durch Labels wie SUCCESS/FAILURE/TRUE/FALSE/MATCH/NO_MATCH/DEFAULT/THROTTLED/EXHAUSTED. Alle Labels sind auf Großbuchstaben standardisiert |
| Message (Message) | Die Payload, die im Flow fließt. Enthält type (Klassifizierung), originator (Subjekt-Entität), data (Inhalt), metadata (Kontext) |
| Trigger (Trigger) | Der Node, der den Startpunkt des Flows bildet. Es gibt drei Arten: Domain-Ereignisse (Tag-Datenpunkt·Alarm·Anlagen-Ereignis usw.), externer Eingang (Webhook·MQTT·externe DB) und Zeit (Schedule) |
Erste Schritte
Am schnellsten machen Sie sich mit Flow in folgenden 4 Schritten vertraut.
- Klicken Sie im Listenbildschirm auf die Schaltfläche
새 플로우, um einen leeren Flow zu erstellen (nur Name und Beschreibung eingeben). - Ziehen Sie im Bearbeitungsbildschirm aus der linken Palette nacheinander einen Trigger-Node (z. B.
flow_on_tag_alarm) → Filter → Aktion (z. B.flow_send_email) und verbinden Sie die Nodes über Wires. - Klicken Sie auf jeden Node, geben Sie die Optionen im rechten Inspektor ein und überprüfen Sie den Ablauf mit Speichern → Testlauf oben rechts einmal.
- Wenn Sie den Schalter Bereitstellen oben aktivieren, wird der Flow bei jedem eingehenden Trigger-Ereignis automatisch ausgeführt; das Ergebnis können Sie im Live-Debug-Panel und im Ausführungshistorie-Bildschirm einsehen.
Zu Verdrahtungsmustern für Automatisierungsszenarien siehe Beispiel-Flows und Anwendungsbeispiele in diesem Dokument. Ein schrittweises Tutorial, das einen echten Flow von Anfang bis Ende erstellt, finden Sie im End-to-End-Tutorial.
End-to-End-Tutorial
Ein schrittweises Tutorial, in dem ein in der Produktionsumgebung tatsächlich nutzbarer Automatisierungs-Flow von Anfang bis Ende erstellt wird. Szenario: Wenn die Motortemperatur 80 °C überschreitet, automatisch einen dringenden Wartungsauftrag ausstellen und den Verantwortlichen per E-Mail benachrichtigen.
Schritt 1 — Neuen Flow erstellen
- Klicken Sie im linken Menü auf Automation > Flow → Listenbildschirm öffnen
- Klicken Sie oben rechts auf die Schaltfläche Neuer Flow
- Geben Sie folgende Informationen ein und klicken Sie auf Bestätigen
| Element | Eingabewert |
|---|---|
| Name | 모터 과열 자동 정비 발행 |
| Beschreibung | [자동화] 모터 자산의 온도 80°C 초과 시 긴급 정비 작업지시 + 이메일. 담당: ops@example.com |
Nach Erstellung des Flows öffnet sich automatisch der Bearbeitungsbildschirm mit leerer Canvas.
Schritt 2 — Trigger-Node platzieren
Motortemperaturdaten aus einem Anlagen-Telemetrie-Ereignis empfangen.
- Kategorie Trigger (Trigger) in der linken Palette aufklappen
- Node
flow_on_tag_pointauf die Canvas ziehen - Node anklicken → folgende Optionen im rechten Inspektor eingeben
| Option | Wert |
|---|---|
| Anzeigename | 태그 포인트 인입 |
tag_id_pattern | MOTOR-*.TEMP |
Wenn nur der Motortemperatur-Tag mit
tag_id_patterndurchgelassen wird, verringert sich der nachfolgende Durchsatz erheblich. Andere Tags werden als SKIPPED behandelt und nicht in den Zähler aufgenommen.
Schritt 3 — Schwellenwertfilter
Fügen Sie einen Skriptfilter hinzu, damit nur Nachrichten über 80 °C durchgelassen werden.
flow_script_filteraus der Kategorie Filter (Filter) ziehen- Wire vom Ausgangsport des Trigger-Nodes zum Eingangsport des neuen Filter-Nodes verbinden
- Im Inspektor Folgendes eingeben
| Option | Wert |
|---|---|
| Anzeigename | 임계값 필터 (80°C 초과) |
language | JS |
script | data.value > 80 |
Schritt 4 — Domänenänderung (Tag → Anlage)
Da Alarm und Arbeitsauftrag natürlicherweise auf Anlagenebene ausgestellt werden, wird der Originator der Nachricht vom Tag in die übergeordnete Anlage transformiert.
flow_change_originatoraus der Kategorie Transformation (Transform) ziehen- Wire vom
TRUE-Ausgang des Filter-Nodes verbinden - Inspektor:
| Option | Wert |
|---|---|
| Anzeigename | Tag → Asset 변경 |
entity_type | Asset |
id_field | metadata.asset_id |
metadata.asset_idwird bei Eingang eines Tag-Datenpunkts automatisch befüllt. Fehlt es in der Nachricht, können Sie den Präfix-Teil der Tag-ID (z. B.MOTOR-001.TEMP→MOTOR-001) auch per Skript extrahieren.
Schritt 5 — Arbeitsauftrag ausstellen
Erstellt automatisch einen dringenden Wartungsauftrag.
flow_create_work_orderaus der Kategorie Aktion (Action) — Domain CRUD ziehen- Wire vom
SUCCESS-Ausgang des Transformationsnodes verbinden - Inspektor:
| Option | Wert |
|---|---|
| Anzeigename | 긴급 정비 작업지시 생성 |
asset_id_field | originator.id |
order_name_field | (statischer Wert) 긴급 점검 — 모터 과열 |
master_id_field | (optional) data.master_id (falls nicht angegeben, automatisch erzeugt) |
description_field | (statischer Wert) 자동 발행: 임계 온도 초과로 긴급 점검 필요 |
default_priority | HIGH |
Schritt 6 — E-Mail-Benachrichtigung (Erfolgszweig)
Bei erfolgreicher Ausstellung des Arbeitsauftrags wird der Verantwortliche benachrichtigt.
flow_send_emailaus der Kategorie Externe Anbindung (External) ziehen- Wire vom
SUCCESS-Ausgang des Arbeitsauftrag-Nodes verbinden - Inspektor:
| Option | Wert |
|---|---|
| Anzeigename | 정비 담당자 이메일 |
to | ops@example.com |
subject_template | [과열 정비] ${originator.id} 작업지시 ${data.work_order_id} |
body_template | 자산 ${originator.id} 의 온도가 ${data.value}°C 로 상승하여 자동으로 긴급 정비가 발행되었습니다.\n작업지시 ID: ${data.work_order_id} |
Schritt 7 — Fehlerzweig behandeln
Auch das Ausstellen des Arbeitsauftrags selbst kann fehlschlagen (z. B. Anlage nicht mehr vorhanden oder Berechtigungsproblem). Sende sofort eine Push-Benachrichtigung an den Operator.
flow_send_pushunter Externe Anbindung ziehen- Wire vom
FAILURE-Ausgang des Arbeitsauftrag-Nodes verbinden - Inspektor:
| Option | Wert |
|---|---|
title | 자동화 실패 |
body_template | ${originator.id} 정비 자동 발행 실패: ${data.error} |
Schritt 8 — Speichern und Testlauf
- Auf die Schaltfläche Speichern oben rechts klicken. Ein automatischer Snapshot wird angelegt, sodass später zurückgerollt werden kann.
- Auf die Schaltfläche Testlauf oben rechts klicken → im JSON-Editor Folgendes eingeben → Veröffentlichen
{
  "type": "POST_TELEMETRY",
  "originator": { "entity_type": "Tag", "id": "MOTOR-001.TEMP" },
  "data":     { "value": 92.5 },
  "metadata": { "ts": 1746247200000, "tag_id": "MOTOR-001.TEMP", "asset_id": "MOTOR-001" }
}
Unten im Dialog wird ✓ JSON OK (type=POST_TELEMETRY) angezeigt → auf Veröffentlichen klicken.
- Im Live-Debug-Panel Folgendes prüfen:
- Trigger-Node leuchtet grün → Nachricht durchlaufen
- Filter-Node: da
92.5 > 80, Verzweigung nachTRUE - Transformations-Node: Originator wird zu Asset/MOTOR-001 geändert
- Arbeitsauftrag-Node: SUCCESS,
data.work_order_idautomatisch vergeben - E-Mail-Node: Sendeversuch
Schritt 9 — Verifizierung und Bereitstellung
- Im Arbeitsauftrag-Bildschirm prüfen, ob ein neuer Arbeitsauftrag registriert wurde
- Prüfen, ob die E-Mail ordnungsgemäß angekommen ist (Testumgebungs-Postfach)
- Nochmals mit einer Nachricht unter 80 °C testen (sollte am Filter blockiert werden):
{ "type": "POST_TELEMETRY", "originator": {"entity_type":"Tag","id":"MOTOR-001.TEMP"},
  "data": {"value": 70}, "metadata": {"asset_id":"MOTOR-001"} }
Die Verzweigung am Filter-Node ist FALSE, nachfolgende Nodes grau — korrekt.
- Nach Verifizierung aller Zweige mit Alle Zähler zurücksetzen das Statistikfenster zurücksetzen
- Schalter Bereitstellen oben aktivieren
Ab jetzt wird in der tatsächlichen Produktionsumgebung sofort bei Motortemperaturen über 80 °C automatisch ein Wartungsauftrag ausgestellt und der Verantwortliche per E-Mail benachrichtigt.
Schritt 10 — Betriebsüberwachung
Es ist sicher, in den ersten 5–10 Minuten nach der Bereitstellung Folgendes zu prüfen.
| Ort | Prüfpunkt |
|---|---|
| Listenbildschirm | Ob die Ausführungsanzahl der betreffenden Flow-Zeile im normalen Bereich zunimmt (nicht ausufernd) |
| Live-Debug-Panel | Ob keine Node-Fehler vorliegen |
| Ausführungshistorie-Bildschirm | Bei fehlgeschlagenen Nachrichten die Ursache in NODE_ERROR prüfen |
| Empfangene E-Mail | Ob Benachrichtigungen nicht unbeabsichtigt häufig eingehen |
Nächste Schritte
Um diesen Flow weiterzuentwickeln:
- Retry-Verdrahtung hinzufügen — bei Fehlschlag von E-Mail-/Push-Versand mit Backoff wiederholen (siehe Beispiel 8)
- Automatische Bandanpassung — Schwellenwert automatisch anhand 6-Stunden-Mittelwert ± 3σ korrigieren (siehe Beispiel 6)
- Downtime kumulieren — Überhitzungshistorie in Anlagen-Attribut kumulieren (siehe Beispiel 14)
- Isolierung der Qualitätslinie — bei wiederholter Überhitzung Linie automatisch stoppen (siehe Beispiel 15)
Bildschirmaufbau
Flow besteht aus folgenden drei Bildschirmen.
| Bildschirm | Verwendung |
|---|---|
| Liste | Übersicht·Suche·Massenbereitstellung·Import registrierter Flows |
| Bearbeitung | Nodes über visuelle Canvas platzieren·verbinden·konfigurieren |
| Ausführungshistorie | Node-bezogene Ausführungsprotokolle·Timeline abrufen |
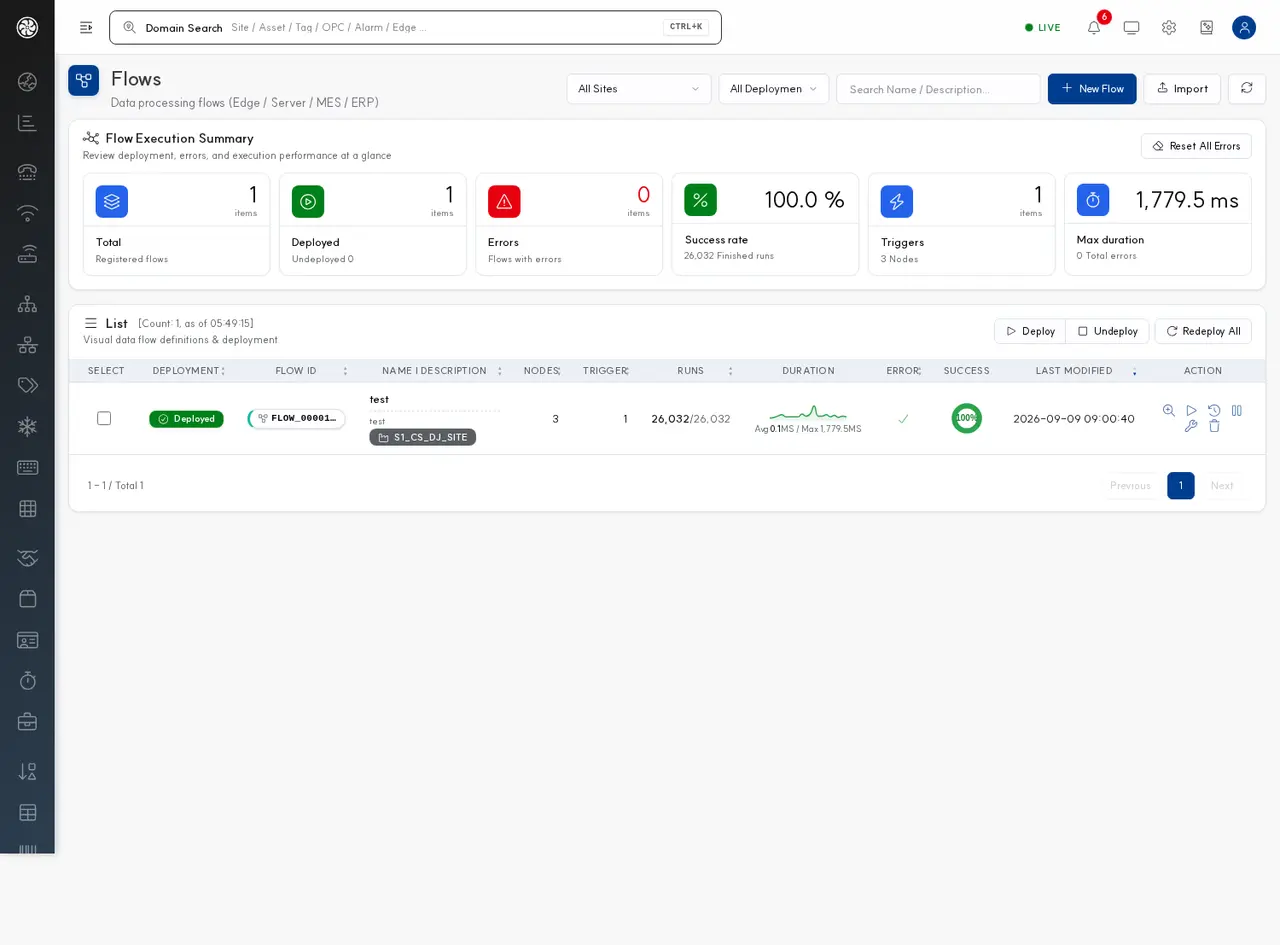
Listenbildschirm
Besteht aus dem oberen Such-/Erstellungsbereich und der Flow-Übersichtstabelle.
Werkzeuge oben
| Element | Beschreibung |
|---|---|
| Statusfilter | 전체 / 배포 / 해제 |
| Namens-/Beschreibungssuche | Flows nach Stichwort filtern |
| Neuer Flow | Leeren Flow erstellen (Name·Beschreibung eingeben) |
| Importieren | Über Export erhaltene JSON hochladen, um einen Flow wiederherzustellen |
| Alle neu bereitstellen | Alle aktivierten Flows auf einmal erneut laden |
| Aktualisieren | Liste erneut abrufen |
Übersichtstabelle
Die Listentabelle ist mit 25 Zeilen pro Seite paginiert; jede Zeile zeigt eine Verarbeitungstrend-Sparkline und ein Fehlerquote-Donut-Diagramm. Der Diagrammstatus bleibt beim Seitenwechsel erhalten.
| Spalte | Beschreibung |
|---|---|
| Auswahl | Checkbox für Massenbereitstellung·-aufhebung |
| Status | Badge 배포 / 해제 |
| Flow-ID | Sequenz-ID im Format FLOW_NNNNN |
| Name | Beschreibung | Vom Operator festgelegte Metainformationen |
| Nodes | Anzahl enthaltener Nodes |
| Trigger | Anzahl der Trigger-Nodes |
| Ausführungsanzahl | Kumulierte Nachrichtenverarbeitungszahl |
| Verarbeitungszeit | Durchschnittliche/letzte Node-Verarbeitungszeit |
| Fehler | Kumulierte Fehleranzahl |
| Letzte Änderung | Zeitpunkt der letzten Graph-Speicherung |
| Aktion | Schaltflächen 편집 / 삭제 |
Massenbereitstellung·-aufhebung
Ausgewählte Flows werden gemeinsam bereitgestellt (aktiviert) oder aufgehoben (deaktiviert). Nur bereitgestellte Flows empfangen Trigger-Ereignisse.
Alle neu bereitstellen
Die Schaltfläche Alle neu bereitstellen oben lädt alle aktivierten Flows erneut. Verwenden Sie sie in folgenden Situationen.
- Direkt nach dem Massenimport von Graphen von außen
- Wenn Sie Trigger mit eigenem Scheduler (Schedule·externes MQTT-Abonnement·externes DB-Polling) erneut registrieren möchten
- Bei Verdacht auf Cache-Konsistenzprobleme während des Betriebs
Bearbeitungsbildschirm (visuelle Canvas)
Ziehen Sie Nodes aus der linken Palette der Canvas, und verbinden Sie den Ausgangsport eines Nodes durch Klicken & Ziehen mit dem nächsten Node.
Obere Werkzeugleiste
| Schaltfläche | Aktion |
|---|---|
| Name·Beschreibung | Flow-Metainformationen bearbeiten |
| Bereitstellen/Aufheben | Den aktuellen Flow sofort aktivieren/deaktivieren |
| Exportieren | Den gesamten Graphen als JSON-Datei herunterladen |
| Testlauf | Eine beliebige JSON-Nachricht einmalig einspeisen und das Ergebnis prüfen (siehe Verwendung des Testlaufs unten) |
| Speichern | Den aktuellen Graphen auf dem Server speichern. Beim Speichern wird ein automatischer Snapshot angelegt, sodass später zurückgerollt werden kann |
Wenn Sie versuchen, einen Graphen ohne Trigger zu speichern, wird die Warnung „Wird nur über manuellen Testlauf gestartet“ angezeigt. Sie können den Trigger absichtlich weglassen und den Flow ausschließlich für manuelle Ausführung nutzen.
Verwendung des Testlaufs
Beim Klick auf die Schaltfläche 테스트 실행 öffnet sich ein JSON-Bearbeitungsdialog. Der Operator kann selbst eine Nachricht schreiben und einmalig veröffentlichen, um das Verhalten des Graphen zu prüfen, ohne auf ein Trigger-Ereignis zu warten.
| Element | Beschreibung |
|---|---|
| Editor | JSON-Editor mit Zeilennummern·Syntaxhervorhebung. Der Nachrichteninhalt kann frei geschrieben werden |
| Validierungsanzeige | Bei vorhandenen Pflichtfeldern type wird ✓ JSON OK (type=X) angezeigt, bei fehlenden Feldern ⚠ type 필수 |
| Veröffentlichen | Über die Schaltfläche 발행 wird die Nachricht in den Dispatcher eingespeist. Das Ergebnis ist im Live-Debug-Panel und in der Ausführungshistorie einsehbar |
Beispiel für Standardvorlage
{
  "type": "POST_TELEMETRY",
  "originator": { "entity_type": "Asset", "id": "MOTOR-001" },
  "data":     { "speed": 1500, "temp": 75.3 },
  "metadata": { "ts": 1746247200000, "site_id": "SITE-01" }
}
Wenn Sie ungespeicherte Änderungen haben und den Testlauf ausführen, erscheint der Hinweis „Der Server führt die gespeicherte Version aus“. Um Änderungen zu prüfen, speichern Sie zuerst.
Links — Node-Palette
Kann kategorieweise auf-/zugeklappt werden; über das Suchfeld kann sofort gefiltert werden.
| Kategorie | Farbe | Anzahl Nodes |
|---|---|---|
| Trigger (Trigger) | Grau | 22 |
| Filter (Filter) | Blau | 6 |
| Transformation (Transform) | Grün | 8 |
| Aktion (Action) — Integration·Speicherung·Anlagen-Ereignis-Veröffentlichung·Befehlsaufruf | Orange | 7 |
| Aktion (Action) — Domain CRUD | Orange | 34 |
| Externe Anbindung (External) | Violett | 9 |
| Ablaufsteuerung (Control) | Grau | 7 |
| Edge (Edge) | Cyan | 22 |
Mitte — Canvas
| Werkzeug | Tastenkürzel/Bedienung | Aktion |
|---|---|---|
| Zoomen | Ctrl/⌘ + / Ctrl/⌘ - · Mausrad | Canvas zoomen |
| 100% | Ctrl/⌘ 0 | Zoom zurücksetzen |
| An Ansicht anpassen | Ctrl/⌘ 1 | Automatisch anpassen, damit alle Nodes sichtbar sind |
| Ausgewählten Node löschen | Del / Backspace | Ausgewählten Node/Wire löschen |
| Canvas verschieben (Panning) | Linksklick auf leeren Bereich, dann ziehen | Wenn Sie den leeren Canvas-Hintergrund (nicht auf einen Node) klicken und ziehen, bewegt sich die gesamte Canvas mit |
Unten rechts auf der Canvas wird eine Minimap angezeigt; ein Klick auf die Minimap springt sofort zur entsprechenden Position.
💡 Tipp zum Panning: Ziehen auf einem Node bewegt den Node — um die Canvas zu verschieben, greifen Sie unbedingt den leeren Hintergrundbereich ohne Node/Wire. Bei großen Flows ist Panning schneller als die Minimap.
Rechts — Node-Konfiguration
Wenn Sie einen Node auf der Canvas anklicken, wird im rechten Inspektor das Konfigurationsformular des betreffenden Nodes angezeigt. Die Eingabefelder werden je nach Node-Typ automatisch erzeugt.
| Eingabeart | Beschreibung |
|---|---|
| Statischer Wert | Verwendet den direkt im Formular eingegebenen Wert unverändert |
*_field dynamischer Wert | Extrahiert den Wert aus einem Pfad in der Nachrichten-Payload (z. B. data.tag_id, metadata.site_id). Fehlt der Wert, wird auf den statischen Wert zurückgegriffen |
Script-Nodes (Filter·Transformation·Switch) können direkt im Inspektor per Code-Editor bearbeitet werden und lassen sich auch in einem separaten Dialog erweitern, um auf einem größeren Bildschirm zu schreiben.
Die Code-Editor-Schriftart wird als lesbarkeitsoptimierter Monospace-Font-Stack (Priorität: Cascadia Code · JetBrains Mono · Consolas · Menlo) angezeigt, wobei auch koreanische Kommentare stabil ausgerichtet werden.
Zähler zurücksetzen
Oben rechts im Node-Konfigurationspanel werden zwei Reset-Schaltflächen als Icons angezeigt. Beim Überfahren mit der Maus zeigt jede Schaltfläche einen Tooltip.
| Icon-Schaltfläche | Aktion |
|---|---|
| 🩹 (Pflaster) — Fehlerzähler zurücksetzen | Setzt nur den kumulierten Fehlerzähler aller Nodes in diesem Flow auf 0 zurück |
| 🔄 (Drehpfeil) — Alle Zähler zurücksetzen | Setzt Verarbeitung·Fehler·Verarbeitungszeit sowie alle Flow-bezogenen Statistiken auf 0 zurück. Verwenden Sie dies nach Abschluss der Betriebsverifizierung, um mit neuen Statistiken zu beginnen |
Beide Schaltflächen wirken sofort ohne Bestätigungsdialog — nur die Statistik wird zurückgesetzt, das Node-Verhalten bzw. die Nachrichtenverarbeitung sind nicht betroffen.
Rechts — Live-Debug
Das Live-Debug-Panel wird unter dem Inspektor angezeigt.
| Element | Beschreibung |
|---|---|
| Aktualisierungsintervall | 2 Sekunden |
| Level-Farbe | Am linken Rand INFO (Blau)/WARN (Gelb)/ERROR (Rot) |
| Angezeigte Informationen | Node-Anzeigename · Verarbeitungszeit (ms) · Nachrichtenvorschau |
| Pause | Aktualisierung über Schalter oben rechts im Panel pausieren |
| Leeren | Kumulierte Debug-Einträge nur auf dem Bildschirm leeren |
Oben rechts an jedem Node auf der Canvas wird eine kleine Leuchtanzeige angezeigt.
| Farbe | Bedeutung |
|---|---|
| Grau | Wartend — noch keine Nachricht empfangen |
| Grün | Nachricht durchläuft gerade |
| Rot | Fehler während der Verarbeitung aufgetreten |
Unten rechts am Node wird die Verarbeitungszeit im Format 평균 X · 최근 Y angezeigt.
Nachrichtenstruktur
Die im Flow fließende Nachricht besteht aus folgenden 4 Bereichen.
{
  "type": "POST_TELEMETRY",
  "originator": {
    "entity_type": "Asset",
    "id": "MOTOR-001"
  },
  "data": { "speed": 1500, "temp": 75.3 },
  "metadata": {
    "ts": 1746247200000,
    "site_id": "SITE-01",
    "shift": "DAY",
    "tag_id": "MOTOR-001.SPEED"
  }
}
| Bereich | Bedeutung |
|---|---|
type | Nachrichtenklassifizierung. Verzweigungskriterium des Filter-Nodes |
originator | Subjekt-Entität der Nachricht (auf welche Anlage/Tag/Bestellung sie sich bezieht) |
data | Payload-Inhalt |
metadata | Kontext (Zeit·Standort·Schicht·Tag-ID usw.) |
Nachrichtentypen
| Typ | Auslösender Einstiegspunkt |
|---|---|
POST_TELEMETRY / TAG_POINT | Eingang eines Tag-Datenpunkts |
POST_ATTRIBUTES | Aktualisierung der Tag-/Anlagen-Metadaten |
TAG_ALARM | Alarm auf Tag-Ebene |
ENTITY_CREATED / UPDATED / DELETED | Lebenszyklus-Ereignisse einer Entität |
ASSET_DATA / ASSET_EVENT / ASSET_ALARM / ASSET_COMMAND / ASSET_AGGREGATION / ASSET_CONTEXT | Anlagen-Domain-Ereignisse |
ASSET_HEALTH_STATUS / ASSET_CONNECTION_STATUS | Periodische Anlagenbewertung (Health-/Verbindungsstatus) |
OEE_EVENT / RAM_EVENT / EMS_EVENT | ISO-Analyseergebnis-Ereignisse |
OPC_STATUS / EDGE_STATUS | OPC/Edge-Gerätestatus |
DIAGNOSTIC / DOMAIN_CHANGED | Diagnose·Domänenänderung |
ALARM | Alarmauslösung |
WEBHOOK | Empfang von HTTP-Webhooks |
KAFKA_INBOUND / MQTT_INBOUND | Empfang externer Topics |
TIMER | Schedule-Auslösung |
Payload-Beispiele nach Trigger
Bei der Erstellung von Script-Nodes müssen Sie genau wissen, auf welche Felder zugegriffen werden kann. Nachfolgend finden Sie reale JSON-Nachrichtenbeispiele, die jeder Trigger erzeugt. Alle Trigger-Nachrichten enthalten gemeinsam type, originator, data, metadata.
flow_on_tag_point — Eingang eines Tag-Datenpunkts
Wird jedes Mal ausgelöst, wenn ein Wert für ein Tag eingeht. Der häufigste Trigger.
{
  "type": "POST_TELEMETRY",
  "originator": { "entity_type": "Tag", "id": "MOTOR-001.SPEED" },
  "data": {
    "value": 1500.7,
    "quality": "GOOD",
    "ts": 1746247200123
  },
  "metadata": {
    "tag_id":      "MOTOR-001.SPEED",
    "site_id":    "SITE-01",
    "area_id":    "AREA-A",
    "line_id":    "LINE-1",
    "asset_id":   "MOTOR-001",
    "opc_id":     "OPC-LINE-1",
    "java_type":  "Float",
    "unit":       "rpm",
    "shift":      "DAY"
  }
}
| Feld | Bedeutung | Skriptzugriff |
|---|---|---|
data.value | Empfangener Wert (numerisch/String/boolesch) | msg.data.value |
data.quality | OPC-Qualität (GOOD/BAD/UNCERTAIN) | msg.data.quality |
data.ts | Empfangszeitpunkt (epoch ms) | msg.data.ts |
metadata.tag_id | Tag-ID | msg.metadata.tag_id |
flow_on_tag_alarm — Auftreten eines Tag-Alarms
Wird ausgelöst, sobald das Tag ein Alarmband (hi/lo/...) überschreitet.
{
  "type": "TAG_ALARM",
  "originator": { "entity_type": "Tag", "id": "MOTOR-001.TEMP" },
  "data": {
    "alarm_band": "HI_HI",
    "value":      95.3,
    "threshold":  90.0,
    "priority":   "ERROR",
    "band_message": "온도 위험"
  },
  "metadata": {
    "tag_id": "MOTOR-001.TEMP",
    "asset_id": "MOTOR-001",
    "site_id": "SITE-01",
    "ts": 1746247200123
  }
}
data.alarm_band-Wert | Bedeutung |
|---|---|
NORMAL / HI / LO / HI_HI / LO_LO / TRIP_HI / TRIP_LO | Numerische Alarmstufen |
BOOL_TRUE / BOOL_FALSE | Boolesche Alarme |
flow_on_asset_data / flow_on_asset_event — Anlagen-Ereignis
Wird ausgelöst, wenn auf Anlagenebene aggregierte Ereignisse (CEP-Verarbeitungsergebnis·Plugin-Bewertungsergebnis usw.) auftreten.
{
  "type": "ASSET_EVENT",
  "originator": { "entity_type": "Asset", "id": "MOTOR-001" },
  "data": {
    "event_type":  "STARTUP",
    "details":     { "rpm_target": 1500 }
  },
  "metadata": {
    "asset_id": "MOTOR-001",
    "site_id": "SITE-01",
    "ts": 1746247200123
  }
}
flow_on_asset_data übermittelt Zeitreihendaten auf Anlagenebene (data.values als Schlüssel-Wert-Map), flow_on_asset_aggregation übermittelt Aggregatwerte auf Minuten-/Stundenbasis.
flow_on_asset_health_status / flow_on_asset_connection_status — Periodische Bewertung
Die Plattform bewertet im Minutentakt den Health-/Verbindungsstatus auf Anlagenebene.
{
  "type": "ASSET_HEALTH_STATUS",
  "originator": { "entity_type": "Asset", "id": "MOTOR-001" },
  "data": {
    "status":       "WARN",
    "info_count":   12,
    "warn_count":   3,
    "error_count":  0,
    "prev_status":  "OK"
  },
  "metadata": { "asset_id": "MOTOR-001", "ts": 1746247200123 }
}
data.status-Wert | Bedeutung |
|---|---|
OK / WARN / ERROR / UNKNOWN | Health-Stufen |
CONNECTED / LATENT / ERROR / DISCONNECTED / UNKNOWN | Verbindungsstufen (connection_status) |
Ein oft verwendetes Muster ist, im Vergleich mit prev_status nur beim Zeitpunkt des Statuswechsels eine Folgeaktion auszulösen.
flow_on_oee_event / flow_on_ram_event / flow_on_ems_event — Plugin-Ereignisse
Wird ausgelöst, wenn OEE/RAM/EMS-Bewertungsergebnisse auf Arbeitsauftragsebene aktualisiert werden. Absender (originator) ist die Anlage, das Berechnungsergebnis steht in data.payload.
{
  "type": "OEE_EVENT",
  "originator": { "entity_type": "Asset", "id": "ASSET_DJ_M_0001" },
  "data": {
    "event_type":     "OEE_CALCULATED",
    "plugin":         "OEE",
    "statement_type": "RESULT",
    "asset_id":       "ASSET_DJ_M_0001",
    "timestamp":      1746247200123,
    "payload": {
      "oee":            0.78,
      "availability":   0.95,
      "performance":    0.85,
      "quality":        0.97,
      "good_quantity":  { "quantity_string": "1560", "data_type": "integer", "unit_of_measure": "EA" },
      "scrap_quantity":  { "quantity_string": "42",   "data_type": "integer", "unit_of_measure": "EA" },
      "rework_quantity": { "quantity_string": "6",    "data_type": "integer", "unit_of_measure": "EA" },
      "run_time_ms":    25200000,
      "order_id":       "ORDER_000001"
    }
  }
}
good_quantity,scrap_quantityundrework_quantitysind Quantity-Objekte in der Einheit des Arbeitsauftrags (ISA-95 / B2MML). Der Wert ist ein Dezimal-String; um im Skript damit zu rechnen, wandeln Sie ihn um, z. B.Number(data.payload.good_quantity.quantity_string), und prüfen die Einheit inunit_of_measure. Die alten Feldergood_countundbad_countgibt es nicht mehr. Feldregeln: Order-Dienst — Menge.scrap_quantityist nur Ausschuss, Nacharbeit istrework_quantity. Wird die Summe der Schlechtteile benötigt, addieren Sie beide (Gut + Ausschuss + Nacharbeit = Produktion).- Ein nicht berechnetes Verhältnis («nicht angewendet») und eine fehlende Menge sind null, nicht 0.
flow_on_opc_status / flow_on_edge_status — OPC/Edge-Status
{
  "type": "OPC_STATUS",
  "originator": { "entity_type": "OPC", "id": "OPC-LINE-1" },
  "data": {
    "connection_status": "CONNECTED",
    "scan_status":       "START",
    "prev_status":       "DISCONNECTED"
  },
  "metadata": { "opc_id": "OPC-LINE-1", "edge_id": "EDGE-A", "ts": 1746247200123 }
}
flow_on_diagnostic — Systemdiagnosenachricht
Wird ausgelöst, wenn eine Diagnosemeldung von einem Servermodul eingeht.
{
  "type": "DIAGNOSTIC",
  "originator": { "entity_type": "Module", "id": "cep-engine" },
  "data": {
    "level":   "WARN",
    "code":    "PATTERN_LAG",
    "summary": "EQL 패턴 평가 지연 1.2s",
    "module":  "cep-engine"
  },
  "metadata": { "ts": 1746247200123 }
}
data.level | Bedeutung |
|---|---|
INFO / WARN / ERROR | Diagnoseschweregrad |
flow_on_domain_changed — Domänenänderungsereignis
Wird ausgelöst, wenn Domänenentitäten wie Anlage·Tag·Standort·Arbeitsauftrag per CRUD verändert werden.
{
  "type": "DOMAIN_CHANGED",
  "originator": { "entity_type": "Asset", "id": "MOTOR-001" },
  "data": {
    "action":      "UPDATED",
    "before":      { "asset_name": "Motor1" },
    "after":       { "asset_name": "Motor 01 - Renamed" },
    "changed_by":  "admin"
  },
  "metadata": { "ts": 1746247200123 }
}
flow_on_entity_event — Entitäts-Lebenszyklus
Ausgelöst als drei zusammengefasste Typen: ENTITY_CREATED / ENTITY_UPDATED / ENTITY_DELETED. Ein einziger Node empfängt alle drei Lebenszyklen.
{
  "type": "ENTITY_CREATED",
  "originator": { "entity_type": "Customer", "id": "CUST-9001" },
  "data": { "customer_name": "신규 고객", "external_id": "ERP-CUST-9001" },
  "metadata": { "ts": 1746247200123 }
}
flow_on_webhook — Externer HTTP-Push
Eine von einem externen System an POST /webhook/flow/{flow_id} gesendete Payload wird unverändert in eine Nachricht umgewandelt. Authentifizierung über {flow_id} im URL-Pfad und Header X-API-Key.
/flow/webhook/{flow_id} liefert 410 Gone zurückDieser Pfad wurde deaktiviert, da er ohne Authentifizierung beliebige Flows über flow_id auslösen konnte
(FlowController liefert 410). Der neue Einstiegspunkt /webhook/flow/{flow_id} wird von
WebhookController per API-Key·HMAC validiert. Der Pfad ist vertauscht und dadurch leicht zu übersehen —
es ist nicht flow/webhook, sondern webhook/flow.
{
  "type": "WEBHOOK",
  "originator": { "entity_type": "External", "id": "ERP" },
  "data": {
    "order_no":  "PO-20260512-001",
    "customer":  "ACME",
    "quantity":  1000
  },
  "metadata": {
    "http_method": "POST",
    "remote_addr": "10.20.0.55",
    "request_id":  "req-7c0a...",
    "ts": 1746247200123
  }
}
Der komplette von einem externen System gesendete JSON-Body wird unverändert in
dataeingesetzt. Die HTTP-Header werden nur teilweise (remote_addr/method/request_id) inmetadataangezeigt.
flow_on_mqtt_subscribe — Abonnement eines MQTT-Topics
{
  "type": "MQTT_INBOUND",
  "originator": { "entity_type": "Topic", "id": "factory/line1/events" },
  "data": { "event": "STARTUP", "rpm": 1500 },
  "metadata": {
    "topic":   "factory/line1/events",
    "qos":     1,
    "broker":  "tcp://mqtt.example.com:1883",
    "ts": 1746247200123
  }
}
flow_jdbc_poll — Periodisches Polling einer externen DB
Führt die konfigurierte SELECT-Query periodisch aus und löst für jede Zeile eine Nachricht aus.
{
  "type": "KAFKA_INBOUND",
  "originator": { "entity_type": "DB", "id": "mes_db" },
  "data": {
    "PO_NO":    "PO-20260512-001",
    "CUSTOMER": "ACME",
    "QTY":      1000,
    "DUE_DATE": "2026-05-20"
  },
  "metadata": {
    "datasource": "mes_db",
    "query":      "SELECT * FROM po WHERE status='NEW'",
    "row_index":  0,
    "ts": 1746247200123
  }
}
Bei 100 Zeilen werden 100 Nachrichten der Reihe nach ausgelöst. Um zu verhindern, dass dieselbe Zeile wiederholt verarbeitet wird, aktualisieren Sie ein Verarbeitungsflag innerhalb der SELECT-Query oder fügen Sie eine Vergleichsbedingung für die Spalte
processed_athinzu.
flow_schedule — Zeitbasierte Auslösung
Wird per Cron-Ausdruck oder festem Intervall ausgelöst. Die Payload ist leer, nur metadata.ts wird befüllt.
{
  "type": "TIMER",
  "originator": { "entity_type": "Schedule", "id": "daily-report" },
  "data": {},
  "metadata": {
    "cron":      "0 0 8 * * ?",
    "fired_at":  1746247200000,
    "ts":        1746247200000
  }
}
Hinweise bei der Payload-Transformation
originator.idist die Domänen-ID — wenn sie mit dem Nodeflow_change_originatorgeändert wird, arbeiten nachfolgende Aktions-Nodes wieflow_save_attributes·flow_publish_asset_*ab dann mit dem neuen Originator.- Beim Ersetzen von
data/metadataper Skript wird eine direkte Zuweisung statt einer flachen Kopie (Object.assign) empfohlen — Änderungen am Original können andere Flows beeinflussen, die denselben Trigger abonnieren. - Alle epoch-Zeitfelder sind in Millisekunden (ms) angegeben. Falls Sekunden benötigt werden:
Math.floor(msg.metadata.ts / 1000).
Node-Katalog
Detaillierte Node-IDs und Optionen finden Sie im Inspektor des Bearbeitungsbildschirms.
Trigger (22 Typen)
Der Startpunkt jedes Flows ist ein Trigger-Node. Es gibt keine separaten Einstiegs-/Endpunktknoten.
Automatischer Domain-Empfang — interne Systemereignisse werden automatisch dispatcht.
| Kategorie | Trigger-Node |
|---|---|
| Tag | flow_on_tag_point (Telemetrie), flow_on_tag_alarm |
| Anlage | flow_on_asset_data, flow_on_asset_event, flow_on_asset_alarm, flow_on_asset_command, flow_on_asset_aggregation, flow_on_asset_context, flow_on_asset_health_status, flow_on_asset_connection_status |
| Plugin | flow_on_oee_event, flow_on_ram_event, flow_on_ems_event |
| OPC/Edge | flow_on_opc_status, flow_on_edge_status |
| Diagnose·Domain | flow_on_diagnostic, flow_on_domain_changed |
| Entität | flow_on_entity_event |
flow_on_alarmAlarm-Trigger sind je nach Ziel zweigeteilt — Tag-Alarme sind flow_on_tag_alarm,
Anlagen-Alarme sind flow_on_asset_alarm. Ein älteres Beispiel verwendete
flow_on_alarm, das jedoch nicht in der Palette vorhanden ist — folgen Sie diesem Namen nicht, sonst finden Sie den Node nicht.
Alle Trigger-Nodes können über die Option
*_pattern(Glob:*,?) eine Vorabfilterung pro Nachricht vornehmen. Nicht übereinstimmende Nachrichten werden nicht an Folgenodes weitergegeben und erhöhen auch den Ausführungszähler nicht (Behandlung als SKIPPED). Es wird empfohlen, Filterung bereits auf Trigger-Ebene vorzunehmen, um die Betriebslast zu minimieren.
Externer Eingang
| Node | Aktion |
|---|---|
flow_on_webhook | Empfang von per HTTP von externen Systemen gepushten Payloads |
flow_on_mqtt_subscribe | Abonnement eines Topics eines externen MQTT-Brokers |
flow_jdbc_poll | Periodisches Lesen des SELECT-Ergebnisses einer externen Datenbank, Auslösung pro Zeile |
Zeitbasiert
| Node | Aktion |
|---|---|
flow_schedule | Cron-/Intervall-Schedule — löst Nachricht TIMER aus |
Filter (6 Typen)
| Node | Beschreibung |
|---|---|
flow_msg_type_filter | Wenn type in der angegebenen Liste enthalten ist, TRUE |
flow_originator_type_filter | Wenn originator.entity_type in der angegebenen Liste enthalten ist, TRUE |
flow_script_filter | Boolesche Auswertung per Skript |
flow_check_existence_field | Existenzprüfung bestimmter Felder data/metadata |
flow_switch | Mehrfache Case-Verzweigung (unterschiedliche Relation je Case) |
flow_check_relation | Verzweigung nach der Relation der vorherigen Stufe |
Transformation (8 Typen)
| Node | Anzeigename | Beschreibung |
|---|---|---|
flow_script_transform | Skripttransformation | data/metadata per Skript transformieren |
flow_change_originator | Absender ändern | originator in eine andere Entität ändern |
flow_rename_keys | Schlüsselnamen ändern | Feldnamen von data pauschal umbenennen |
flow_template | Vorlage | ${path} Substitutionstext erzeugen |
flow_split | Aufteilen | Falls data ein Array ist, in eine Nachricht pro Element aufteilen |
flow_merge | Zusammenführen | Mehrere Nachrichten über ein Zeitfenster zusammenführen — das Gegenteil von flow_split |
flow_flatten | Abflachen | Kindschlüssel eines verschachtelten Objekts auf die oberste Ebene heben (data.data_map.x → data.x) |
flow_to_email | E-Mail-Umwandlung | Nachricht in E-Mail-Format umwandeln |
flow_flattenwird verwendet, wenn Sie Nachrichten, bei denen der Wert wie bei einem Tag-Datenpunkt zusätzlich indata_mapverschachtelt ist, im nachfolgenden Node direkt über${data.x}referenzieren möchten.
Aktion — Integration/Speicherung (2 Typen)
| Node | Beschreibung |
|---|---|
flow_save_tag_point | Speicherung eines Tag-Datenpunkts (identisch mit dem normalen Ingest-Pfad) |
flow_save_attributes | Teilweise Aktualisierung von Tag-/Anlagen-Metadaten |
Wenn Sie
flow_dds_publish(freies Publizieren in den internen Nachrichtenkanal) suchen, finden Sie es nicht hier, sondern in der Palettengruppe Externe Anbindung.
Aktion — Anlagen-Ereignis-Veröffentlichung (4 Typen)
Veröffentlicht Anlagen-Ereignisse über denselben Verarbeitungspfad wie CEP (EQL) (persistente Speicherung + Cache + Timeline + Plugin + konsistente Verarbeitung im Nachrichtenkanal).
| Node | Kanal |
|---|---|
flow_publish_asset_event | Anlagen-Ereignis |
flow_publish_asset_context | Anlagenkontext |
flow_publish_asset_aggregation | Anlagenaggregation |
flow_publish_asset_command | Anlagenbefehl |
flow_asset_command_invoke — Ausführung statt Veröffentlichung
| Node | Anzeigename | Was es tut |
|---|---|---|
flow_asset_command_invoke | Anlagenbefehl-Aufruf | Führt einen an der Anlage definierten Befehl synchron aus und wartet auf das Ergebnis |
flow_publish_asset_commandflow_publish_asset_command— veröffentlicht ein Anlagenbefehls-Ereignis im Kanal. Damit ist es abgeschlossen.flow_asset_command_invoke— führt tatsächlich einen an der Anlage definierten Befehl aus und wartet auf das Ergebnis.
Wenn Sie einen Befehl tatsächlich ausführen wollten, aber den Veröffentlichungsnode verwenden, scheint nichts zu passieren.
Aktion — Domain CRUD (34 Typen)
Alle Domänen-Operationen werden an denselben Domänenservice delegiert, wodurch Audit·Konsistenz gewahrt bleiben. Mit der dynamischen Option *_field können Werte aus der Nachrichten-Payload extrahiert werden.
| Domäne | Create | Update | Delete |
|---|---|---|---|
| Anlage (Asset) | flow_create_asset | flow_update_asset | flow_delete_asset |
| Tag (Tag) | flow_create_tag | flow_update_tag | flow_delete_tag |
| Standort/Bereich/Linie | flow_create_site | flow_update_site | flow_delete_site |
| Arbeitsauftrag (WorkOrder) | flow_create_work_order | flow_update_work_order | flow_delete_work_order |
| Alarmeinstellung (EQL) | flow_create_alarm_config | flow_update_alarm_config | flow_delete_alarm_config |
| Kunde (Customer) | flow_create_customer | flow_update_customer | flow_delete_customer |
| Produkt (Product) | flow_create_product | flow_update_product | flow_delete_product |
| Mitarbeiter (Employee) | flow_create_employee | flow_update_employee | flow_delete_employee |
| Kalender (Schicht) | flow_create_calendar | flow_update_calendar | flow_delete_calendar |
Teilweise Aktualisierung des Tag-Alarmbands (2 Typen)
| Node | Beschreibung |
|---|---|
flow_update_tag_alarm_band_numeric | Aktualisiert nur die eingegebenen Felder des numerischen Alarmbands (hi/lo/hi_hi/lo_lo/trip_hi/trip_lo/band_message/use_alarm) |
flow_update_tag_alarm_band_boolean | Aktualisiert nur die eingegebenen Felder des booleschen Alarmbands (bool_true/bool_false/Priorität/Nachricht/use_alarm) |
Zustandsübergänge des Arbeitsauftrags (WorkOrder) (5 Typen)
Da statt direkter Aktualisierung numerischer Spalten die Zustandsübergangsmethoden des Domänenservices aufgerufen werden, bleibt die OEE/RAM/EMS-Sichtbarkeit erhalten.
| Node | Übergang |
|---|---|
flow_start_work_order | WAIT → START |
flow_pause_work_order | START → PAUSED |
flow_resume_work_order | PAUSED → START |
flow_end_work_order | START oder PAUSED → END |
flow_abort_work_order | START oder PAUSED → ABORTED (Optionen abort_code, notes) |
Automatische NOT-NULL-Ergänzung — Create-Nodes befüllen NOT-NULL-Spalten automatisch mit Default-Werten. Beispiel: Arbeitsauftrag
status="WAIT"/master_idals MES-Master-ID (falls nicht vorhanden, automatisches Backfill), Kundenmanagerinformationen"admin"/"admin@example.com", Mitarbeiterorg_idmit Fallback aufsite_id,insert_user_id="flow"für alle Zeilen. Bei FK-Spalten (z. B.customer_id/product_id) wird ein leerer String in NULL umgewandelt.
Update-Node — Teilweise Aktualisierung — Die Update-Nodes für Customer/Product/Employee/Calendar und das Alarmband rufen zunächst den bestehenden Datensatz ab und speichern dann nur die eingegebenen Felder als Merge. Leere Strings·Null-Werte werden ignoriert und der bestehende Wert bleibt erhalten. Für vollständiges Überschreiben verwenden Sie die Kombination Delete + Create.
Der Node zur direkten Alarmauslösung wurde bewusst ausgeschlossen. Alarme sollten nur über den
flow_create_alarm_config-Pfad entstehen, damit die Konsistenz der Alarmhistorie gewahrt bleibt.
Edge (Edge, 22 Typen)
Automatisiert die Registrierung von OPC-Servern·Tag-CRUD·Abfrage von Tag-Werten (Lesen/Schreiben)·Steuerung von Docker-Apps durch Aufruf der REST-API des Edge-Geräts (OPC Agent). Alle Nodes teilen semantisch dieselbe Aktion, wobei sich nur die zugrunde liegende HTTP-Methode (GET/POST/PUT/DELETE) unterscheidet.
| Gruppe | Node |
|---|---|
| OPC-Server-Verwaltung | flow_edge_opc_create, flow_edge_opc_update, flow_edge_opc_delete, flow_edge_opc_start, flow_edge_opc_stop, flow_edge_opc_list |
| Tag-Verwaltung | flow_edge_tag_create, flow_edge_tag_update, flow_edge_tag_delete, flow_edge_tag_read, flow_edge_tag_write, flow_edge_tag_list |
| Abfrage | flow_edge_monitoring, flow_edge_info, flow_edge_transfer |
| Docker-App-Steuerung | flow_edge_app_list, flow_edge_app_inspect, flow_edge_app_start, flow_edge_app_stop, flow_edge_app_restart, flow_edge_app_logs, flow_edge_app_stats |
Abfrage (3 Typen)
| Node | Anzeigename | Was es tut |
|---|---|---|
flow_edge_monitoring | Monitoring | Abfrage der Edge-Monitoring-Kennzahlen |
flow_edge_info | Edge-Info | Abfrage von Edge-ID · Version · Uptime |
flow_edge_transfer | Übertragungs-Health | MQTT/Sparkplug-Übertragungsstatus |
| Node | Anzeigename | Was es tut |
|---|---|---|
flow_edge_opc_list | OPC-Liste | Abfrage der OPC-Serverliste des Edge |
flow_edge_tag_list | Tag-Liste | Abfrage der OPC-Tag-Liste |
Docker-App-Steuerung (7 Typen)
Automatisiert per Flow, was manuell im Docker-Panel des Edge-Detailbildschirms erledigt wird.
| Node | Anzeigename | Was es tut |
|---|---|---|
flow_edge_app_list | App-Liste | Liste der Docker-Container des Edge |
flow_edge_app_inspect | App-Details | Container-Details (inspect) |
flow_edge_app_start | App starten | Container starten |
flow_edge_app_stop | App stoppen | Container stoppen |
flow_edge_app_restart | App neu starten | Container neu starten |
flow_edge_app_logs | App-Log | Container-Log (line=N) |
flow_edge_app_stats | App-Statistiken | Container CPU / Speicher / I/O |
app_stop · app_restart stoppen und starten den tatsächlich auf dem Vor-Ort-Edge laufenden Container.
Wenn Sie diese an einen Trigger anbinden, um sie automatisch auszuführen, setzen Sie enge Bedingungen —
wenn Sie app_restart an einen flappenden Alarm anschließen, startet der Container wiederholt neu.
Gemeinsame Konfiguration
| Option | Beschreibung |
|---|---|
url | Edge-REST-Endpunkt. Unterstützt ${data.x}/${metadata.y}-Vorlagensubstitution |
method | HTTP-Methode (bei fehlender Angabe Node-spezifischer Standardwert — z. B. create=POST, update=PUT, delete=DELETE, read/monitoring=GET) |
headers | JSON-Header (z. B. {"Authorization":"Bearer ${TOKEN}"}) |
body_template | Request-Body (bei fehlender Angabe wird data unverändert gesendet, GET/DELETE senden keinen Body) |
timeout_ms | Timeout (Standard 5000) |
Antwort·Verzweigung
data.response_status— HTTP-Statuscodedata.response— Response-Body (String)data.error— Fehlermeldung (bei Fehlschlag)SUCCESS(200–399) /FAILURE(sonst oder Ausnahme)
Externe Anbindung (9 Typen)
Alle externen Nodes unterstützen die dynamische Option *_field.
| Node | Dynamische Option |
|---|---|
flow_dds_publish | Freies Publizieren in den internen Nachrichtenkanal (kein externer Aufruf, aber in dieser Gruppe enthalten) |
flow_http_request | url_field / method_field / body_field |
flow_kafka_publish | topic_field / key_field |
flow_mqtt_publish | topic_field |
flow_webhook_callback | url_field |
flow_send_email | to_field / cc_field / subject_field / body_field |
flow_send_sms | to_field / text_field |
flow_send_push | title_field / body_field |
flow_jdbc_query | SQL statisch (SELECT/INSERT/UPDATE/DELETE) |
Ablaufsteuerung (7 Typen)
| Node | Beschreibung |
|---|---|
flow_log | Debug-Log (level / prefix) |
flow_noop | Durchleiten |
flow_delay | Nach delay_ms Weiterleitung an den nächsten Node |
flow_throttle | Begrenzung von max_msgs / window_ms (bei Überschreitung Relation THROTTLED) |
flow_debounce | Nach Stabilisierung über window_ms nur die letzte Nachricht auslösen |
flow_merge | Eingaben über window_ms kumulieren und einmalig als data.merged-Array emittieren |
flow_subflow | target_flow_id — Aufruf eines anderen Flows |
flow_retry | max_attempts (Standard 3) / backoff_ms (Standard 1000) / backoff_multiplier (Standard 2.0). Nach Backoff-Wartezeit Weiterleitung der Nachricht über SUCCESS-Zweig, bei Erreichen der Maximalversuche Zweig EXHAUSTED. Automatische Aktualisierung von metadata.retry_count / metadata.retry_exhausted |
Empfohlenes Retry-Verdrahtungsmuster
[risky_node] ─[FAILURE]─▶ [flow_retry] ─[SUCCESS]─▶ (다시 risky_node 로 루프 연결)
                                       └[EXHAUSTED]─▶ [에러 핸들러 / 알림]
Detaillierte Node-Optionsreferenz
Erläutert die Optionen komplexer Nodes nicht nur zeilenweise, sondern detailliert bis hin zu Standardwerten·Beispielen·Fehlerbehandlung pro Option.
flow_script_filter — Skriptfilter
| Option | Typ | Standardwert | Beschreibung |
|---|---|---|---|
script | text | (erforderlich) | Auswertungsausdruck — gibt boolean zurück. true → Zweig TRUE / false → Zweig FALSE |
script_type | enum | javascript | javascript / eql |
on_error | enum | FALSE | Bei Skriptausnahme — Zweig TRUE / FALSE / FAILURE |
Skriptkontext
| Variable | Bedeutung |
|---|---|
msg.type | Nachrichtentyp (POST_TELEMETRY usw.) |
msg.data | Payload (änderbar, aber im Filter ohne Bedeutung) |
msg.metadata | Kontext |
msg.originator | Originator-Objekt |
Beispiel
// 온도가 임계 초과 + 야간 시프트만
msg.data.value > 80 && msg.metadata.shift === 'NIGHT'
// 사이트별 임계 분기
var th = {'SITE-A': 80, 'SITE-B': 90, 'SITE-C': 75};
msg.data.value > (th[msg.metadata.site_id] || 100);
flow_script_transform — Skripttransformation
| Option | Typ | Standardwert | Beschreibung |
|---|---|---|---|
script | text | (erforderlich) | Transformationsausdruck — ändert das msg-Objekt oder gibt ein neues Objekt zurück |
script_type | enum | javascript | javascript / eql |
mode | enum | mutate | mutate (in-place) / return (Rückgabewert verwenden) |
Beispiel
// data 에 계산 필드 추가
msg.data.fahrenheit = msg.data.value * 9/5 + 32;
msg.metadata.processed_at = Date.now();
// 페이로드 통째로 교체 (mode=return)
return {
  type: 'WEBHOOK',
  originator: msg.originator,
  data: { temp: msg.data.value, level: msg.data.value > 80 ? 'HIGH' : 'OK' },
  metadata: msg.metadata
};
Im Modus
mutatewird einereturn-Anweisung ignoriert, selbst wenn vorhanden. Um durch ein neues Objekt zu ersetzen, mussmode=returneingestellt werden.
flow_switch — Mehrfachverzweigung
| Option | Typ | Standardwert | Beschreibung |
|---|---|---|---|
cases | array | (erforderlich) | Array [{expression, relation}] — Auswertung von oben nach unten, erste Übereinstimmung wird übernommen |
default_relation | string | DEFAULT | Falls kein Case übereinstimmt |
script_type | enum | javascript | — |
Beispiel
// cases 설정
[
  { "expression": "msg.data.value > 90", "relation": "CRITICAL" },
  { "expression": "msg.data.value > 80", "relation": "WARN" },
  { "expression": "msg.data.value > 70", "relation": "INFO" }
]
// default_relation: "NORMAL"
Im nachfolgenden Node ist mit 4 Verzweigungslabels (CRITICAL/WARN/INFO/NORMAL) jeweils eine unterschiedliche Verarbeitung möglich.
flow_retry — Automatischer Retry
Automatische Wiederherstellung von vorübergehenden Fehlern eines externen IO-Nodes.
| Option | Typ | Standardwert | Beschreibung |
|---|---|---|---|
max_attempts | int | 3 | Maximale Versuchsanzahl (bei Überschreitung EXHAUSTED) |
backoff_ms | long | 1000 | Erste Wartezeit (ms) |
backoff_multiplier | double | 2.0 | Exponentieller Backoff-Multiplikator — 1. Versuch 1 s → 2. Versuch 2 s → 3. Versuch 4 s |
max_backoff_ms | long | 30000 | Obergrenze einer einzelnen Wartezeit |
jitter_pct | int | 0 | Zufälliges Schwanken von ±N% beim Backoff (zur Vermeidung von Thundering Herd) |
Automatische Ergänzung von metadata
| Feld | Bedeutung |
|---|---|
metadata.retry_count | Bisherige Anzahl der Versuche |
metadata.retry_exhausted | Bei true wird der EXHAUSTED-Zweig betreten |
metadata.retry_last_error | Ursache des letzten Fehlschlags |
Wenn die Summe des Backoffs 60 Sekunden übersteigt, kann die Verarbeitungswarteschlange des Triggers blockiert werden. Bei durchgängig langsamer Antwort des externen Systems begrenzen Sie zuerst die Eingangsrate mit
flow_throttle.
flow_on_webhook — HTTP-Trigger
| Option | Typ | Standardwert | Beschreibung |
|---|---|---|---|
auth_required | boolean | true | Pflichtangabe des X-API-Key-Headers — wenn deaktiviert, kann jeder den Trigger aufrufen |
allowed_origins | csv | * | Whitelist der CORS-Origins |
max_body_kb | int | 256 | Obergrenze der Body-Größe (bei Überschreitung Antwort 413) |
payload_pattern | glob | * | Glob zur Vorabfilterung von Nachrichten |
Aufrufmethode
curl -X POST \
  https://platform.example.com/webhook/flow/{flow_id} \
  -H "X-API-Key: {edge_or_token_key}" \
  -H "Content-Type: application/json" \
  -d '{"order_no":"PO-001","customer":"ACME","quantity":1000}'
{flow_id}im Pfad kann im Listenbildschirm kopiert werdenX-API-Keyist ein im Bildschirm API Key des Edge oder API-Authentifizierungstoken ausgestelltes Token- Antwort:
200 OK(in Nachrichtenwarteschlange eingereiht) /401(Authentifizierung fehlgeschlagen) /404(Flow nicht vorhanden oder nicht bereitgestellt) /413(Body überschritten)
flow_http_request — Externer HTTP-Aufruf
| Option | Typ | Standardwert | Beschreibung |
|---|---|---|---|
url | string | (erforderlich) | Aufzurufende URL. Unterstützt ${data.x}-Vorlagensubstitution |
url_field | string | — | Bei dynamischer Abrufung der URL aus der Payload — z. B. data.endpoint |
method | enum | GET | GET / POST / PUT / DELETE / PATCH |
method_field | string | — | Methode dynamisch aus der Payload |
headers | json | {} | Form von {"Authorization": "Bearer ${TOKEN}"} |
body | text | — | Statischer Body (unterstützt Vorlagensubstitution) |
body_field | string | — | Bei Abruf des Bodys aus der Payload — meist data |
timeout_ms | int | 5000 | Obergrenze der Antwortwartezeit |
follow_redirect | boolean | true | Automatisches Folgen von 3xx-Redirects |
verify_ssl | boolean | true | TLS-Zertifikatsprüfung (nur zu Testzwecken deaktivieren) |
Ergänzung der Antwort-Payload
| Feld | Bedeutung |
|---|---|
data.response_status | HTTP-Statuscode (200 / 404 / 500 ...) |
data.response_body | Response-Body (bei JSON automatisch parsen) |
data.response_headers | Response-Header-Objekt |
Verzweigung
SUCCESS— 2xx/3xxFAILURE— 4xx/5xx oder Ausnahme/Timeout
flow_send_email — E-Mail senden
| Option | Typ | Standardwert | Beschreibung |
|---|---|---|---|
to | string | — | Statischer Empfänger (durch Komma getrennt) |
to_field | string | — | Empfänger aus Payload extrahieren — z. B. data.recipient |
cc / cc_field | string | — | Cc |
bcc / bcc_field | string | — | Bcc |
subject / subject_field | string | (mind. 1 erforderlich) | Betreff — mit Vorlagensubstitution |
body / body_field | text | (mind. 1 erforderlich) | Inhalt (HTML zulässig) |
is_html | boolean | true | Bei reiner Text-E-Mail deaktivieren |
attachments | json | [] | [{"url":"...","filename":"..."}] |
Die SMTP-Einstellung wird vom Operator vorab in System → Einstellungen unter Mail-Einstellungen registriert. Vor der Registrierung fallen alle E-Mail-Nodes in den
FAILURE-Zweig.
flow_jdbc_poll — Polling einer externen DB
| Option | Typ | Standardwert | Beschreibung |
|---|---|---|---|
datasource_id | string | (erforderlich) | In System → Einstellungen registrierter externer DB-Bezeichner |
query | sql | (erforderlich) | SELECT-Query — liefert maximal 1.000 Zeilen pro Ausführung |
poll_interval_ms | int | 60000 | Polling-Intervall (Standard 1 Minute) |
marker_column | string | — | Spalte „letzter Verarbeitungszeitpunkt“ — SELECT nur der Zeilen nach dem Marker |
marker_initial | string | 1970-01-01 00:00:00 | Startwert des Markers beim ersten Polling |
row_limit | int | 1000 | Maximale Zeilen pro Polling (auch bei Überschreitung sicher) |
on_error_continue | boolean | true | Bei DB-Fehler nur Diagnose protokollieren und mit dem nächsten Polling fortfahren |
Beispiel für die Verwendung von marker_column
SELECT po_no, customer, qty, created_at
FROM po
WHERE created_at > :marker
ORDER BY created_at
→ In :marker wird automatisch der beim letzten Polling erhaltene Maximalwert created_at eingesetzt.
flow_kafka_publish / flow_mqtt_publish — Externe Veröffentlichung
| Option | Typ | Standardwert | Beschreibung |
|---|---|---|---|
broker | string | (erforderlich) | kafka:9092 oder tcp://mqtt:1883 |
topic | string | — | Statisches Topic — Substitution mit ${data.x} möglich |
topic_field | string | — | Topic aus Payload extrahieren (z. B. data.target_topic) |
key / key_field | string | — | (nur Kafka) Nachrichtenschlüssel |
body / body_field | json/text | (mind. 1 erforderlich) | Veröffentlichter Inhalt — bei fehlender Angabe wird data unverändert verwendet |
qos | int | 1 | (nur MQTT) 0/1/2 |
retain | boolean | false | (nur MQTT) Retained-Flag |
flow_publish_asset_* — Anlagen-Ereignis-Veröffentlichung
Anlagen-Ereignisse (Ereignis/Kontext/Aggregation/Befehl) werden über einen integrierten Kanal veröffentlicht, der von CEP/Plugin/Timeline gleichzeitig erkannt wird. Gemeinsame Optionen der 4 Nodes:
| Option | Typ | Standardwert | Beschreibung |
|---|---|---|---|
asset_id | string | — | Statische Anlagen-ID |
asset_id_field | string | — | Anlagen-ID aus Payload extrahieren (meist metadata.asset_id) |
event_type | string | — | Klassifizierung des Anlagen-Ereignisses (z. B. STARTUP, SHUTDOWN, MAINTENANCE) |
event_type_field | string | — | Klassifizierung aus Payload extrahieren |
payload | json | ${data} | Zu veröffentlichender Inhalt — bei fehlender Angabe wird data unverändert verwendet |
Bei
flow_publish_asset_commandwird die Nachricht sofort an das Befehlsempfangs-Topic der Anlage (asset_id/cmd/{event_type}) übermittelt und erreicht den Edge.
flow_create_* / flow_update_* — Domain CRUD
Alle Create/Update-Nodes teilen folgendes Optionsmuster.
| Option | Typ | Beschreibung |
|---|---|---|
{컬럼명} | string | Statischer Wert (falls nicht eingegeben, NULL/Default) |
{컬럼명}_field | string | Wert aus Payload extrahieren (data.foo / metadata.bar) |
id_strategy | enum | auto (systemseitig vergeben) / field (aus {도메인}_id_field extrahiert) |
on_duplicate | enum | error (Standard) / skip / update — nur Create-Node |
Automatische NOT-NULL-Ergänzung
Create-Nodes befüllen NOT-NULL-Spalten automatisch mit Default-Werten.
| Domäne | Automatisch befüllte Spalten |
|---|---|
| Arbeitsauftrag | status="WAIT" / master_id (falls nicht vorhanden, automatisches Backfill) / insert_user_id="flow" |
| Kunde | Managerinformationen "admin" / "admin@example.com" (falls nicht registriert) |
| Mitarbeiter | org_id=site_id (Fallback) |
| Gemeinsam | insert_date=now() / insert_user_id="flow" |
Behandlung leerer Strings bei FK
Wenn in eine FK-Spalte (z. B. customer_id/product_id) ein leerer String "" eingeht, wird dieser automatisch in NULL umgewandelt. In JS ist msg.data.customer_id = '' sicherer als delete msg.data.customer_id.
flow_edge_* — Edge-REST-Aufruf
Die 22 Nodes, die REST-Endpunkte des Edge-Geräts aufrufen, teilen gemeinsame Optionen.
| Option | Typ | Standardwert | Beschreibung |
|---|---|---|---|
edge_id | string | — | Statische Edge-ID |
edge_id_field | string | — | Edge-ID aus Payload extrahieren |
path | string | (Node-spezifischer Standard) | Edge-REST-Pfad (z. B. /api/v1/opc, /api/v1/app/grafana/start) |
body_template | text | — | Request-Body — bei fehlender Angabe wird data unverändert gesendet |
timeout_ms | int | 5000 | — |
Automatische Authentifizierung
Beim Aufruf schlägt der Edge-Node automatisch den api_key des betreffenden Edge in der Master-Tabelle mm_edge nach und fügt ihn als X-API-Key-Header hinzu. Der Operator muss keine separate Konfiguration vornehmen.
Antwort-Payload
| Feld | Bedeutung |
|---|---|
data.edge_response_status | Edge-Antwortcode |
data.edge_response | Response-Body |
data.edge_id | Ziel-Edge-ID (zur Bestätigung) |
Die Verzweigung ist identisch mit flow_http_request (SUCCESS / FAILURE).
Script-Node-Erstellung
Die Nodes flow_script_filter / flow_script_transform / flow_switch unterstützen zwei Arten von Ausdrücken.
JavaScript (Standard empfohlen)
Standard-ECMAScript-Syntax. Unterstützt mehrzeilig·var/let/const·Funktionen·Objektliteralen alle gleichermaßen.
Bindungen
| Variable | Beschreibung |
|---|---|
msg | Gesamte Nachricht. Direkter Zugriff auf msg.data.x, msg.metadata.topic, msg.type, msg.originator.id |
data | Kurzalias für msg.data |
metadata | Kurzalias für msg.metadata |
Filter-Beispiel
data.temp > 80
Transformationsbeispiel
data.temp_f = data.temp * 1.8 + 32;
data.alert = data.temp > 80 ? 'HIGH' : 'OK';
msg
Switch-Beispiel (Boolean je Case)
data.t > 100 // case "Critical"
Häufig verwendetes Transformationsmuster
// 1) 단위 변환 (섭씨 → 화씨) + 라벨링
data.temp_f = data.temp * 1.8 + 32;
data.alert  = data.temp > 80 ? 'HIGH' : 'OK';
msg

// 2) 메타데이터 보강 — 시간대·시프트 자동 부여
const h = new Date(metadata.ts).getHours();
metadata.shift = (h >= 6 && h < 18) ? 'DAY' : 'NIGHT';
msg

// 3) 외부 페이로드를 도메인 모델로 매핑 (MES PO → WorkOrder)
const po = data;
data = {
  master_id: 'WO-MES-' + po.po_no,
  asset_id:  po.line_id || 'UNASSIGNED',
  title:     po.product_name + ' (' + po.qty + ')',
  due_date:  po.delivery_date,
  qty:       po.qty
};
msg

// 4) 실패 분기로 명시적 라우팅 (필수 필드 누락 시)
if (!data.tag_id || data.value == null) throw new Error('필수 필드 누락');
msg

// 5) 배열 분할 후 데이터 정제 — split 노드 후에 사용
data.value     = parseFloat(data.raw);
data.threshold = data.value > 100;
msg
Häufig verwendetes Filtermuster
// 우선순위 화이트리스트
['ERROR', 'CRITICAL'].includes(data.priority)

// 시간대 기반 필터 (주간만 허용)
new Date(metadata.ts).getHours() >= 8 && new Date(metadata.ts).getHours() < 20

// 자산 ID 패턴 매칭
/^MOTOR-.*$/.test(originator.id)

// 임계값 + 안정성 (값이 5번 이상 누적된 경우)
data.value > data.threshold && data.consecutive_count >= 5
Benutzerskripte werden in einer sicheren Sandbox ausgeführt; Datei-, Netzwerk-, Thread- und beliebiger Klassenzugriff sind vollständig gesperrt. Wenn externe Systemaufrufe erforderlich sind, verdrahten Sie separat einen externen Anbindungs-Node wie
flow_http_request.
EQL-Ausdruck
Kompatibilitätsmodus für bestehende EQL-Nutzer. Unterstützt nur einen einzelnen Ausdruck (keine mehrzeilige Ausführung, keine Trennung durch Semikolon), es können nur Muster mit Seiteneffekten verwendet werden.
#msg.getData().getInt('temp') > 80
Bei Bedarf mehrerer Aktionen verwenden Sie JavaScript.
JavaScript-Ausführungsumgebungsspezifikation
Skripte werden in einer isolierten Sandbox ausgeführt. Sie müssen genau wissen, welche Funktionen möglich/nicht möglich sind, um stabile Skripte zu schreiben.
Verfügbar (✅)
| Funktion | Anmerkung |
|---|---|
| Standard-ECMAScript | var/let/const·Funktionen·Klassen·Destrukturierung·Spread·?.·?? usw. |
| Objektliteral | { key: value, ... } |
| Array-Methoden | map / filter / reduce / forEach / find / some / every / flat / slice |
| String-Methoden | split / replace / includes / match / padStart / repeat |
| Mathematische Funktionen | Vollständiges Math.* |
| JSON | JSON.parse / JSON.stringify (kein erneutes stringify nötig, wenn data bereits ein Objekt ist) |
| Date | new Date() / Date.now() / getHours() / toISOString() usw. |
| Reguläre Ausdrücke | Literal /pattern/ + Konstruktor RegExp |
| Error throw | throw new Error('...') — automatische Verzweigung in den FAILURE-Zweig |
| try/catch/finally | Ausnahmebehandlung |
Nicht verfügbar (❌)
| Funktion | Grund / Alternative |
|---|---|
Netzwerkaufruf (fetch / XMLHttpRequest) | Sandbox-gesperrt — separaten flow_http_request-Node verdrahten |
Dateisystem (require('fs')) | Sandbox-gesperrt |
Threads (setTimeout / setInterval / Worker) | Nur synchrone Ausführung erlaubt — bei Verzögerungsbedarf Node flow_delay |
require / import | Laden externer Module nicht möglich — benötigte Funktionen im selben Skript definieren |
eval / new Function(string) | Aus Sicherheitsgründen gesperrt |
| Beliebige Java-Klassen | Auch im EQL-Kompatibilitätsmodus dem Benutzercode nicht zugänglich |
process / global / window | Nicht definiert |
| WebSocket / EventSource | Gesperrt — Nachrichtenempfang erfolgt über Trigger-Nodes |
Ausführungsbeschränkung — es gibt keine
Ein älteres Dokument listete eine Tabelle mit Ausführungszeit 500 ms · Speicher 16 MB · Stack 1024 · Ausgabe 2 MB, aber keine von diesen vier wird angewendet.
- In der Node-Konfiguration scheint
timeout_msverwendbar zu sein, aber der Script-Node liest diesen Wert nicht. (ScriptTransformNode·ScriptFilterNodelesen nurscriptundlanguage.) - Auch der JS-Ausführungskontext hat keine Zeit-, Anweisungszahl- oder Speicherbeschränkung.
Daher belegt ein Skript wie while (true) {} den Worker-Thread ununterbrochen.
Das flow-weite Limit von 30 Sekunden (flow_timeout_ms) wird geprüft, wenn die Ausführungsschleife die nächste Aufgabe entnimmt, sodass eine Endlosschleife innerhalb des Skripts diese Prüfung nie erreicht.
Verwenden Sie ausschließlich Skripte, die selbst enden. Vermeiden Sie Endlosschleifen·gigantische Wiederholungen·Anhäufung großer Strings und setzen Sie in Schleifen immer eine Obergrenze.
Was tatsächlich gesperrt ist — die Sicherheitssandbox
Statt Zeit·Speicher wird das Berühren der Außenwelt eindeutig gesperrt.
| Element | Status |
|---|---|
Zugriff auf Java-Klassen (z. B. Java.type) | Gesperrt |
| Datei·Netzwerk-IO | Gesperrt |
| Thread-Erzeugung | Gesperrt |
| Native Zugriffe | Gesperrt |
| Experimentelle Optionen | Gesperrt |
| Zugriff auf Host-Objekte | Nur solche in der Whitelist |
Bei externen Aufrufen tun Sie dies nicht im Skript, sondern trennen Sie es in einen dedizierten Node wie
flow_http_request— im Skript funktioniert es sowieso nicht, und beim dedizierten Node gilttimeout_mstatsächlich.
Verteilen Sie aufwändige Verarbeitung auf mehrere Nodes statt auf ein einzelnes Skript zu konzentrieren.
Rückgaberegel von msg
// flow_script_transform 의 두 가지 모드
// 1) mutate 모드 (기본) — msg 객체를 직접 수정, 마지막에 msg 또는 아무 값 반환
data.foo = 'bar';
msg

// 2) return 모드 — 완전히 새 객체로 교체
return {
  type: msg.type,
  originator: msg.originator,
  data: { ...data, foo: 'bar' },
  metadata: msg.metadata
};
Standardzeit·Locale
| Element | Verhalten |
|---|---|
| Server-Systemzeitzone | UTC (direkte Verwendung von epoch ms empfohlen) |
| Anzeige koreanischer Zeit | toLocaleString('ko-KR', { timeZone: 'Asia/Seoul' }) |
| Zeitberechnung koreanischer Zeit | new Date(ts + 9*3600000).getUTCHours() oder obige Locale |
| Timestamp-Einheit 0 Sekunden | Math.floor(Date.now() / 1000) * 1000 |
Speichersichere Erstellungsmuster
Script-Nodes haben ein Speicherlimit von 16 MB, aber wenn sich in häufig aufgerufenen Nodes kleine Speicherlecks ansammeln, steigt die GC-Belastung der Engine erheblich. Vermeiden Sie folgende Muster.
Anti-Pattern 1 — Closure hält große Daten fest
// ❌ 나쁜 예 — 큰 배열을 변환 함수에 캡쳐
const heavy = data.records || [];          // 1만 건
const summarize = (item) => heavy.find(r => r.id === item.id);
data.matched = data.targets.map(summarize);
msg
// ✅ 좋은 예 — 인덱스 미리 만들고 함수 안에서만 사용
const index = {};
(data.records || []).forEach(r => { index[r.id] = r; });
data.matched = data.targets.map(t => index[t.id]);
data.records = undefined;     // 변환 후 큰 원본 제거
msg
Anti-Pattern 2 — Übergabe großer Arrays im Original
// ❌ data.records 가 10,000 건이면 모든 후속 노드에서 메모리 차지
msg
// ✅ 필요한 통계만 남기고 원본 제거
data.summary = {
  count: (data.records || []).length,
  total: (data.records || []).reduce((s, r) => s + r.value, 0)
};
delete data.records;
msg
Anti-Pattern 3 — Tiefe Objektkopie
// ❌ JSON.parse(JSON.stringify(obj)) 는 큰 객체에서 매우 느림
data.copy = JSON.parse(JSON.stringify(data.original));
// ✅ 얕은 복사 또는 필요한 필드만 직접 선택
data.summary = { id: data.original.id, name: data.original.name };
Anti-Pattern 4 — Regex-Explosion (Catastrophic Backtracking)
// ❌ (a+)+b 형태의 중첩 그룹은 입력에 따라 지수 시간
const re = /^(a+)+b$/;
if (re.test(data.text)) ...
// ✅ 비포획 그룹 + atomic 그룹 패턴 또는 단순 매칭
const re = /^a+b$/;
if (re.test(data.text)) ...
Anti-Pattern 5 — Kumulationsvariable let außerhalb der Funktion
// ❌ 함수 밖 let 은 매 노드 호출마다 0으로 리셋되지만, 의도와 다르게 동작 가능
let counter = 0;
data.items.forEach(() => counter++);
data.counter = counter;
// ✅ 명시적으로 함수 안에서 선언
data.counter = data.items.length;     // 같은 결과, 더 명확
Anti-Pattern 6 — Verschachteltes try/catch mit unbegrenzten Versuchen
// ❌ 실패해도 다시 던지지 않으면 그래프가 잘못된 분기로 이동
try {
  riskyCall();
} catch (e) { /* 무시 */ }
msg
// ✅ 실패 의도면 throw, 정상 의도면 명시적으로 기록
try {
  riskyCall();
  data.status = 'OK';
} catch (e) {
  data.status = 'ERROR';
  data.error_msg = e.message;
}
msg
Eine im Skript geworfene (
throw) Ausnahme geht in den ZweigFAILUREund die Nachricht bleibt erhalten. Externe IO-Nodes haben ihre eigene separate Verzweigung, umhüllen Sie diese also nicht mit try/catch.
Diagnose von Speicherdruck
NODE_SCRIPT_OOMEin älteres Dokument nannte NODE_SCRIPT_OOM · FLOW_MSG_TRIMMED · ENGINE_GC_PRESSURE als Signale für Speicherdruck,
aber das Produkt erzeugt solchen Code nicht. Es gibt weder ein Skript-Speicherlimit noch eine automatische Kürzung der Payload.
Beurteilen Sie Speicherdruck nicht anhand von Code, sondern anhand von Metriken und Symptomen.
| Zu Beobachtendes | Drucksignal |
|---|---|
FLOW_EXECUTOR_DROPPED_COUNT | Beginnt bei 0 anzusteigen — der Verarbeitungspool ist gesättigt und verwirft Nachrichten |
FLOW_EXECUTOR_QUEUE_SIZE | Steigt kontinuierlich ohne abzunehmen |
FLOW_EXECUTION_TIME | Maximalwert springt auf ein Vielfaches des Normalwerts |
| Server-Logs | Warnungen work_queue full ... task dropped, FlowExecutor timeout |
| JVM | Steigende GC-Zeit · steigende Heap-Nutzung |
Wenn diese Signale auftreten, prüfen Sie zuerst Flows, die große Payloads verarbeiten, und stellen Sie sicher, dass im Skript keine großen String-Arrays angesammelt werden.
Mobiler Push-Benachrichtigungskanal
Mit dem flow_send_push-Node werden Push-Benachrichtigungen an die mobile App des Operators gesendet.
Node-Optionen
| Option | Typ | Standardwert | Beschreibung |
|---|---|---|---|
to / to_field | string | (mind. 1 erforderlich) | Empfänger-Benutzer-ID (durch Komma getrennt) oder Payload-Pfad |
title / title_field | string | (mind. 1 erforderlich) | Benachrichtigungstitel (max. 50 Zeichen empfohlen) |
body / body_field | text | (mind. 1 erforderlich) | Inhalt (max. 120 Zeichen empfohlen) |
priority | enum | NORMAL | NORMAL / HIGH — HIGH wird auch auf dem Sperrbildschirm angezeigt |
sound | enum | default | default / silent / benutzerdefinierter Ton |
data | json | {} | Zusatzdaten, die die App verarbeiten soll (Payload-Limit 4 KB) |
deep_link | string | — | Bildschirm, der bei Tippen auf die Benachrichtigung geöffnet wird (z. B. pp://asset/MOTOR-001) |
ttl_sec | int | 86400 | Aufbewahrungsdauer bei Nicht-Empfang (Sekunden) — bei Ablauf automatisch gelöscht |
Automatische Weiterleitung nutzerspezifischer Tokens
Wenn sich ein Operator zum ersten Mal in der mobilen App anmeldet, wird der Gerätetoken automatisch in Sicherheit → API-Authentifizierungstoken registriert. Im Flow müssen Sie das Token nicht direkt verwalten — geben Sie nur die Benutzer-ID an.
- Wenn sowohl iOS- als auch Android-Token registriert sind, wird an beide Geräte gesendet
- Ist ein Token ungültig (z. B. App gelöscht), wird die Registrierung automatisch aufgehoben
Einfaches Sendebeispiel
[flow_on_asset_alarm]
  ↓ where priority='ERROR'
[flow_send_push]
   to_field:    "metadata.responsible_user"
   title:       "🚨 ${metadata.asset_id} 알람"
   body_field:  "data.band_message"
   priority:    HIGH
   deep_link:   "pp://alarm/view/${data.alarm_id}"
Mehrsprachiger Push
// flow_script_transform — 사용자 로케일에 따라 본문 분기
const locale = metadata.user_locale || 'ko-KR';
const templates = {
  'ko-KR': { title: '🚨 ${asset} 위험 알람',           body: '값 ${value}, 즉시 점검 바랍니다.' },
  'en-US': { title: '🚨 ${asset} Critical Alarm',     body: 'Value ${value}, please inspect immediately.' },
  'ja-JP': { title: '🚨 ${asset} 危険警報',            body: '値 ${value}, 即時点検が必要です。' }
};
const tpl = templates[locale] || templates['ko-KR'];
data.push_title = tpl.title.replace('${asset}', metadata.asset_id).replace('${value}', data.value);
data.push_body  = tpl.body.replace('${value}', data.value);
msg
Danach über flow_send_push mit title_field=data.push_title / body_field=data.push_body verwenden.
Zusammengefasste Gruppenbenachrichtigung (Inbox-Stil)
Mehrere Alarme in einer Benachrichtigung zusammenfassen (im 5-Minuten-Takt):
[flow_on_asset_alarm]
   ↓
[flow_merge window=300s]
   ↓ (data.merged 배열)
[flow_script_transform — 요약 만들기]
   ↓ data.push_body="알람 N건: A자산, B자산, ..."
[flow_send_push]
Automatische Eskalation bei Abwesenheit des Benutzers
30 Minuten nach nicht bestätigter Push-Benachrichtigung automatische Eskalation per SMS oder E-Mail.
[flow_on_asset_alarm priority=ERROR]
   ↓
[flow_send_push]
   ↓ SUCCESS
   ↓ data.alert_id = response_id
[flow_delay 1800s (30분)]
   ↓
[flow_http_request GET /api/alert/${alert_id}/status]
   ↓ (response_body.read=false 면)
[flow_script_filter (data.response_body.read === false)]
   ↓ TRUE
[flow_send_sms]
   to_field: "metadata.responsible_phone"
   text:     "푸시 미확인 30분 경과: ${data.title}"
Empfohlene Begrenzung der Sendefrequenz
| Priorität | Empfohlene Häufigkeit |
|---|---|
| HIGH (Sperrbildschirmanzeige) | max. 5 pro Benutzer und Stunde — zur Vermeidung von Alarmmüdigkeit |
| NORMAL | max. 20 pro Benutzer und Stunde |
Verdrahten Sie den Node flow_throttle vor dem Versand, oder stabilisieren Sie Alarme derselben Anlage mit flow_debounce vor dem Versand.
Automatische Aktualisierung externer Authentifizierungstoken
Muster zur automatischen Erneuerung ablaufender Tokens wie OAuth2 beim Aufruf externer Systeme.
Einfache Erneuerung — zeitbasiert (cron)
[flow_schedule cron='0 */50 * * * ?']    ← 50분마다 (만료 1시간 전)
   ↓
[flow_http_request]
   url:    "https://auth.example.com/oauth2/token"
   method: POST
   body:   "grant_type=client_credentials&client_id=${creds.client_id}&client_secret=${creds.client_secret}"
   ↓
[flow_script_transform]
   ↓ data.access_token = data.response_body.access_token
[flow_save_attributes]    ← 자격 증명 저장소에 저장
   target_id:   "creds:erp_api"
   attributes:  {"access_token": "${data.access_token}", "expires_at": ${data.response_body.expires_in * 1000 + ts}}
Anschließend in flow_http_request eines anderen Flows:
Headers: Authorization: Bearer ${creds:erp_api.access_token}
Proaktive Erneuerung — bei Empfang von 401
[main flow]
   ↓
[flow_http_request]
   ↓ SUCCESS → 정상 처리
   ↓ FAILURE
[flow_script_filter (response_status === 401)]
   ↓ TRUE
[flow_subflow target_flow_id="refresh-token"]    ← 토큰 갱신
   ↓
[원래 노드로 루프]    ← 갱신된 토큰으로 재시도
Verwendung des Refresh Tokens
[flow_http_request]
   url:    "https://auth.example.com/oauth2/token"
   method: POST
   body:   "grant_type=refresh_token&refresh_token=${creds.refresh_token}"
   ↓
[flow_script_transform]
   // 새 access_token + 새 refresh_token (rotation)
   data.access_token  = data.response_body.access_token;
   data.refresh_token = data.response_body.refresh_token;
   data.expires_at    = Date.now() + data.response_body.expires_in * 1000;
   msg
   ↓
[flow_save_attributes]
Automatischer Alarm bei Erreichen des Token-Ablaufschwellenwerts
[flow_schedule cron='0 0 * * * ?']    ← 매시
   ↓
[flow_jdbc_query]
   sql: "SELECT id, expires_at FROM credentials WHERE expires_at < NOW() + INTERVAL '1 day'"
   ↓
[flow_split]
   ↓
[flow_send_email]
   subject: "API 토큰 만료 임박: ${data.id}"
   body:    "${data.id} 토큰이 ${data.expires_at} 만료 예정입니다."
Empfohlener Speicherort für Anmeldedaten
| Art | Empfohlener Speicherort |
|---|---|
| Statisch (kaum Änderungen) | Speicher für Anmeldedaten unter System → Einstellungen |
| Dynamisch (automatische Erneuerung) | Speicherung in Anlagen-Metadaten mit obigem Muster über flow_save_attributes |
| Nutzerspezifisches OAuth | Bildschirm Sicherheit → API-Authentifizierungstoken |
Belassen Sie Anmeldedaten nicht im Klartext im Graphen, sondern schreiben Sie unbedingt in Form einer Referenz auf einen externen Speicher (
${creds.x}). Auch bei Export/Import sind Klartext-Tokens nicht im JSON enthalten.
Wählen Sie über die Option language aus, welche Sprache verwendet werden soll (JS oder EQL).
Ausführungshistorie-Bildschirm
Node-bezogene Ausführungsereignisse können in chronologischer Reihenfolge abgerufen werden.
Suchbedingungen
| Element | Beschreibung |
|---|---|
| Zeit | Abfragezeitraum angeben |
| Level | 전체 / INFO / WARN / ERROR |
| Flow-ID | Filter auf einen bestimmten Flow |
| Nachrichten-ID | zur Verfolgung einer einzelnen Nachricht |
| Anzahl | letzte 200/500/1.000 Einträge |
Schnelle Zeitbereiche
Über die Schaltflächen oben im Timeline-Panel sofort wechseln: 10분전 / 30분전 / 1시간전 / 6시간전 / 12시간전 / 전체기간.
Ergebnisspalten
| Spalte | Beschreibung |
|---|---|
| Level | INFO / WARN / ERROR |
| Zeit | Zeitpunkt des Ereignisses |
| Ereignis | FLOW_START / NODE_IN / NODE_OUT / NODE_ERROR / FLOW_END |
| Flow-ID | um welchen Flow es sich handelt |
| Node | Node-Anzeigename |
| Node-Typ | z. B. flow_script_transform |
| Beziehung | SUCCESS / FAILURE / TRUE / FALSE / MATCH / NO_MATCH / DEFAULT / THROTTLED / EXHAUSTED (alle in Großbuchstaben) |
| Nachricht | Zusammenfassung von Nachrichtentyp · Subjekt · Beziehung · Verarbeitungszeit · Datenvorschau |
Mit der Schaltfläche CSV herunterladen können Sie das aktuelle Abfrageergebnis exportieren.
Die Aufbewahrungsdauer der Ausführungshistorie beträgt 7 Tage. Falls Langzeitspeicherung benötigt wird, laden Sie in ein externes Log-System.
Allgemeiner Workflow
- Neuen Flow erstellen — Schaltfläche
새 플로우im Listenbildschirm → Name·Beschreibung eingeben - Bearbeitungsbildschirm aufrufen — leere Canvas öffnet sich automatisch
- Trigger-Node platzieren — Trigger-Node aus der linken Palette ziehen
- Verarbeitungsnodes hinzufügen — in der Reihenfolge Filter → Transformation → Aktion platzieren und über Wires verbinden
- Node konfigurieren — jeden Node anklicken und Optionen im rechten Inspektor eingeben
- Speichern — Schaltfläche
저장oben rechts (automatischer Snapshot wird angelegt) - Testlauf — Ergebnis durch Einspeisen einer beliebigen Nachricht prüfen
- Bereitstellen — Über den Schalter
배포aktivieren → automatische Ausführung bei eingehendem Trigger-Ereignis - Überwachung — Prüfung über das Live-Debug-Panel und den Ausführungshistorie-Bildschirm
Beispiel-Flows
Jedes Beispiel besteht aus Node-Verdrahtungsdiagramm + zentraler Node-Konfiguration + Verhaltensbeschreibung. Die Node-Konfiguration im JSON-Format entspricht 1:1 den Werten, die Sie im rechten Inspektor eingeben.
Beispiel 1: Automatische Erstellung von MES-Arbeitsaufträgen
Pollt minütlich neue POs vom MES und wandelt sie in Arbeitsaufträge um.
[flow_schedule: 매분]
   │
   ▼ TIMER
[flow_http_request: MES /api/po/list?status=NEW]
   │
   ▼ SUCCESS
[flow_split: data → 각 PO별 메시지]
   │
   ▼
[flow_script_transform: PO → WorkOrder 매핑]
   │
   ▼
[flow_create_work_order]
   │
   ├── SUCCESS → [flow_log: 워크오더 생성됨]
   └── FAILURE → [flow_send_email: 실패 알림]
Node-Konfiguration
| Node | Zentrale Konfiguration |
|---|---|
flow_schedule | cron: 0 * * * * ? (jede Minute Sekunde 0) |
flow_http_request | method: GET, url: https://mes.example.com/api/po/list?status=NEW, headers: {"Authorization":"Bearer ${MES_TOKEN}"} |
flow_split | path: data (in Array aufteilen) |
flow_script_transform | language: JS, siehe Skript unten |
flow_create_work_order | master_id_field: data.master_id, asset_id_field: data.asset_id, order_name_field: data.order_name, planned_quantity_field: data.planned_quantity, unit_of_measure_field: data.unit_of_measure, external_system_field: data.external_system, external_id_field: data.external_id |
flow_send_email | to_field: metadata.alert_to, subject: [MES 동기화 실패] ${data.po} |
Script-Transform-Beispiel
data.master_id = 'WO-MES-' + data.po;
data.order_name = data.product_name + ' (' + data.qty + ' ' + data.uom + ')';
data.asset_id  = data.line_id || 'UNASSIGNED';
data.planned_quantity  = String(data.qty);   // Planmenge - eine Dezimalzahl größer 0
data.unit_of_measure   = data.uom;           // UN/ECE-Rec-20-Code (EA, KGM, LTR ...) - Pflicht, kein Standardwert
data.external_system   = 'MES';              // ein externer Arbeitsauftrag wird über das Paar (System, Nummer) identifiziert
data.external_id       = data.po;
data.due_date  = data.delivery_date;
metadata.alert_to = 'ops@example.com';
msg
Beispiel 2: Anlagenbefehl-Veröffentlichung über externen Webhook
Validiert eine von einem externen System per HTTP gesendete Payload und wandelt sie in einen internen Anlagenbefehl um.
[flow_on_webhook]
   │
   ▼ WEBHOOK
[flow_script_filter: payload 검증]
   │
   ├── TRUE
   ▼
[flow_publish_asset_command]
   │
   ├── SUCCESS → [flow_log]
   └── FAILURE → [flow_webhook_callback: 외부에 실패 통보]
Aufrufmethode: Senden Sie den JSON-Body an POST /webhook/flow/{flow_id}, dann wird der Trigger unverändert mit dem Inhalt in data ausgelöst (der alte /flow/webhook/… liefert 410).
Script-Filter-Beispiel
// 인증 토큰 일치 + 필수 필드 존재 검사
if (data.token !== 'EXPECTED_TOKEN') return false;
if (!data.asset_id || !data.cmd_key) return false;
true
Beispiel 3: Automatische Ausstellung dringender Arbeitsaufträge bei Alarm → Arbeitsauftrag
Bei einem Alarm der Stufe ERROR oder höher wird für die übergeordnete Anlage automatisch eine dringende Wartungsauftrag-Order ausgestellt.
[flow_on_tag_alarm]
   │
   ▼ ALARM
[flow_script_filter: priority = ERROR/CRITICAL]
   │
   ├── TRUE
   ▼
[flow_change_originator: Tag → 상위 Asset]
   │
   ▼
[flow_create_work_order: 긴급 정비]
   │
   └── SUCCESS → [flow_send_email: 정비 담당자]
Script-Filter-Beispiel
['ERROR', 'CRITICAL'].includes(data.priority)
Beispiel 4: Externe DB-Synchronisation — Massenregistrierung von Anlagen
Pollt neue Anlagenzeilen aus einer Legacy-DB und registriert sie automatisch als Anlagen.
[flow_jdbc_poll: SELECT * FROM legacy_assets WHERE sync_status='NEW']
   │
   ▼
[flow_script_transform: 컬럼 매핑]
   │
   ▼
[flow_create_asset]
   │
   ├── SUCCESS → [flow_jdbc_query: UPDATE legacy_assets SET sync_status='OK' WHERE id=?]
   └── FAILURE → [flow_log: ERROR + flow_send_push]
Node-Konfiguration
| Node | Zentrale Konfiguration |
|---|---|
flow_jdbc_poll | dsn: externe DB-Verbindung, sql: SELECT * FROM legacy_assets WHERE sync_status='NEW' LIMIT 100, interval_ms: 60000 |
flow_create_asset | asset_id_field: data.legacy_id, asset_name_field: data.name, site_id_field: data.plant_code |
flow_jdbc_query | sql: UPDATE legacy_assets SET sync_status='OK' WHERE id=?, params_field: data.legacy_id |
Beispiel 5: Automatischer Zustandsübergang des Arbeitsauftrags
Automatischer Zustandsübergang eines Arbeitsauftrags anhand von Betriebs-/Stoppereignissen einer Anlage.
[flow_on_asset_event]
   │
   ▼ ASSET_EVENT
[flow_switch: data.event_type 기준]
   │
   ├── case "RUN"   ─▶ [flow_start_work_order] ─▶ [flow_log]
   ├── case "STOP"  ─▶ [flow_pause_work_order] ─▶ [flow_log]
   ├── case "DONE"  ─▶ [flow_end_work_order]   ─▶ [flow_log]
   └── DEFAULT      ─▶ [flow_noop]
Beispiel für Switch-Node-Cases
RUN:data.event_type === 'RUN'STOP:data.event_type === 'STOP'DONE:data.event_type === 'DONE' && data.qty_done >= data.qty_planned
Fehlgeschlagene Zustandsübergänge (falscher aktueller Zustand) werden automatisch an
FAILUREgeroutet, sodass die Verdrahtung sicher ohne separaten Filter erfolgen kann.
Beispiel 6: Automatische Anpassung des Alarmbands
Passt die oberen/unteren Alarmgrenzen des Tags dynamisch anhand der Anlagenaggregation (z. B. 6-Stunden-Durchschnittswert) an.
[flow_on_asset_aggregation]
   │
   ▼ ASSET_AGGREGATION
[flow_script_transform: 통계 → 임계값 산출]
   │
   ▼
[flow_update_tag_alarm_band_numeric]
   │
   ├── SUCCESS → [flow_log]
   └── FAILURE → [flow_send_email: 운영자 알림]
Script-Transform-Beispiel
// 6h 평균 ± 3σ 를 임계값으로 사용
const mean   = data.mean;
const stddev = data.stddev || 1;
data.tag_id  = originator.id + '.TEMP';
data.hi      = mean + 3 * stddev;
data.lo      = mean - 3 * stddev;
data.hi_hi   = mean + 4 * stddev;
data.lo_lo   = mean - 4 * stddev;
data.use_alarm = true;
msg
Beispiel 7: Automatische Registrierung von Edge-Geräten
Registriert neue OPC-Server-Informationen beim Empfang im Batch am Edge-Gerät.
[flow_on_webhook] (POST 본문에 OPC + 태그 목록)
   │
   ▼
[flow_edge_opc_create]
   │
   ▼ SUCCESS
[flow_split: data.tags 배열]
   │
   ▼
[flow_edge_tag_create]
   │
   ▼ SUCCESS (모든 태그 등록 완료 후)
[flow_edge_opc_start]
   │
   └── SUCCESS → [flow_log: 엣지 디바이스 가동]
Beispiel für Aufrufkörper
{
  "type": "WEBHOOK",
  "data": {
    "opc_id":   "OPC-LINE-A",
    "endpoint": "opc.tcp://line-a.local:4840",
    "tags": [
      { "tag_id": "MOTOR-001.SPEED", "address": "ns=2;s=Motor1.Speed" },
      { "tag_id": "MOTOR-001.TEMP",  "address": "ns=2;s=Motor1.Temp"  }
    ]
  }
}
Beispiel 8: Erhöhung der Zuverlässigkeit externer APIs (Retry)
Wendet Backoff-Retry auf gelegentlich fehlschlagende externe API-Aufrufe an und benachrichtigt den Operator, wenn die maximale Versuchszahl überschritten wird.
[flow_on_asset_event]
   │
   ▼
[flow_http_request: 외부 ERP API]
   │
   ├── SUCCESS  → [flow_log]
   └── FAILURE  ─▶ [flow_retry]
                       │
                       ├── SUCCESS    ─▶ (다시 flow_http_request 로 루프 결선)
                       └── EXHAUSTED  ─▶ [flow_send_email: 'ERP 동기화 N회 실패']
Retry-Node-Konfiguration
max_attempts:5backoff_ms:2000backoff_multiplier:2.0→ Intervalle von 2, 4, 8, 16, 32 Sekunden
Beispiel 9: Routing von Plugin-Ereignissen (Benachrichtigung bei niedriger OEE)
Sendet eine Push-Benachrichtigung an den Linienmanager, wenn der OEE-Wert unter den Schwellenwert fällt.
[flow_on_oee_event]
   │
   ▼
[flow_script_filter: data.availability * data.performance * data.quality < 0.6]
   │
   ├── TRUE
   ▼
[flow_template: '라인 ${originator.id} OEE ${data.oee_pct}%']
   │
   ▼
[flow_send_push: 라인 매니저]
Template-Beispiel
body:라인 ${originator.id} OEE ${data.oee_pct}% (목표 60% 미달, 주요 손실: ${data.top_loss})
Beispiel 10: Nachrichtenaufbereitungspipeline (Throttle + Debounce)
Begrenzt hochfrequente Tag-Änderungen auf 1 Auslösung pro Minute und lässt zusätzlich nur bei 5 Sekunden ohne Änderung den Folgenode auslösen.
[flow_on_tag_point]
   │
   ▼
[flow_throttle: max_msgs=1, window_ms=60000]
   │
   ├── SUCCESS    → [flow_debounce: window_ms=5000]
   │                                │
   │                                ▼
   │                          [flow_save_attributes]
   └── THROTTLED  → [flow_log: 차단됨]
Beispiel 11: Aufsummierung mehrerer Trigger (Merge)
Fasst OEE/RAM/EMS-Ereignisse im 30-Sekunden-Takt zusammen und sendet sie als eine Berichtsnachricht.
[flow_on_oee_event]  ─┐
[flow_on_ram_event]  ─┼─▶ [flow_merge: window_ms=30000]
[flow_on_ems_event]  ─┘                │
                                       ▼
                              [flow_script_transform: 요약 메시지 생성]
                                       │
                                       ▼
                              [flow_send_email: 일일 요약]
Wenn Sie mehrere Trigger-Nodes im selben Flow platzieren, werden alle zu Einstiegspunkten. Im
data.merged-Array vonflow_mergewerden alle innerhalb des Zeitfensters eingegangenen Nachrichten kumuliert.
Beispiel 12: Bündelung gemeinsamer Verarbeitung über Subflow
Die gemeinsame Nachrichtenaufbereitungslogik (Duplikatsprüfung + Einheitenumwandlung + Speicherung) wird in einen separaten Flow ausgelagert und von mehreren Triggern aus aufgerufen.
Haupt-Flows (jeweils unabhängig)
[flow_on_tag_point]   ─▶ [flow_subflow: target_flow_id=FLOW_00099]
[flow_on_asset_data]  ─▶ [flow_subflow: target_flow_id=FLOW_00099]
Subflow FLOW_00099
(트리거 없음 — 호출 전용)
[flow_log: 'subflow in']
   │
   ▼
[flow_check_existence_field: data.value 존재]
   │
   ├── TRUE
   ▼
[flow_script_transform: 단위 변환]
   │
   ▼
[flow_save_tag_point]
Ein Subflow kann auch ohne Trigger gespeichert werden und lässt sich ausschließlich für externe Aufrufe verwenden (beim Speichern erscheint eine Warnung).
Beispiel 13: Automatischer Versand eines Tagesberichts bei Schichtwechsel
Sendet täglich zum Ende der Nachtschicht (z. B. 06:00 Uhr) eine E-Mail mit einer Zusammenfassung von Produktion·Qualität·Downtime von gestern bis heute.
[flow_schedule: 0 0 6 * * ?]   (매일 06:00)
   │
   ▼ TIMER
[flow_http_request: 내부 통계 API /api/report/daily]
   │
   ▼ SUCCESS
[flow_script_transform: 본문 마크다운 생성]
   │
   ▼
[flow_send_email]
Script-Transform-Beispiel
const r = data.report;
data.subject = `[${r.site_id}] ${r.date} 일일 운영 요약`;
data.body    =
  `■ 생산: ${r.qty_done}/${r.qty_planned} (${(100*r.qty_done/r.qty_planned).toFixed(1)}%)\n` +
  `■ 가동률: ${r.availability}%\n` +
  `■ 품질률: ${r.quality}%\n` +
  `■ 다운타임 Top3:\n` +
  r.downtimes.slice(0,3).map(d => ` - ${d.code} ${d.minutes}분`).join('\n');
msg
Beispiel 14: Automatische Aggregation der Downtime
Beim Eingang eines Anlagen-STOP-Ereignisses wird die kumulierte Downtime je Schicht aktualisiert und bei Überschreiten des Schwellenwerts eine Benachrichtigung gesendet.
[flow_on_asset_event]
   │
   ▼
[flow_msg_type_filter: type in [ASSET_EVENT]]
   │
   ▼ TRUE
[flow_script_filter: data.event_type === 'STOP']
   │
   ▼ TRUE
[flow_script_transform: 다운타임 분 단위 계산]
   │
   ▼
[flow_save_attributes: 자산 누적 다운타임 갱신]
   │
   ▼ SUCCESS
[flow_script_filter: data.shift_downtime_min > 30]
   │
   ▼ TRUE
[flow_send_push: '시프트 다운타임 30분 초과']
Beispiel 15: Automatische Isolierung einer Linie bei Qualitätsmängeln
Wenn bei einer Qualitätsprüfung 5 oder mehr aufeinanderfolgende Mängel gemeldet werden, wird an die Linien-Anlage ein Stoppbefehl ausgegeben und der Arbeitsauftrag unterbrochen.
[flow_on_asset_event]   (event_type=QUALITY_FAIL)
   │
   ▼
[flow_script_transform: data.consecutive_fail = (... + 1)]
   │
   ▼
[flow_save_attributes]
   │
   ▼ SUCCESS
[flow_script_filter: data.consecutive_fail >= 5]
   │
   ▼ TRUE
[flow_publish_asset_command: cmd_key='STOP']
   │
   ▼
[flow_abort_work_order: abort_code='QUALITY']
   │
   └── SUCCESS → [flow_send_email: 품질 매니저 + 라인 매니저]
Beispiel 16: Überschreitung des Energieschwellenwerts — Empfehlung zur vorübergehenden Stilllegung der Linie
Wenn der stündliche Energieverbrauch der Linie das Budget überschreitet, wird dem Operator per SMS eine Empfehlungsnachricht gesendet.
[flow_on_ems_event]
   │
   ▼
[flow_script_filter: data.power_kwh > data.budget_kwh * 1.2]
   │
   ▼ TRUE
[flow_template: '${originator.id} 시간당 ${data.power_kwh}kWh (예산 ${data.budget_kwh}kWh 초과)']
   │
   ▼
[flow_send_sms]
   │
   └── SUCCESS → [flow_save_attributes: 자산에 마지막 경고 시각 기록]
Beispiel 17: Bidirektionale Synchronisation externer Systeme — Spiegelung des Arbeitsauftragsstatus
Synchronisiert den vom externen ERP eingehenden Status bidirektional mit dem internen Arbeitsauftragsstatus.
Abwärts (ERP → intern)
[flow_on_mqtt_subscribe: erp/work-order/status]
   │
   ▼
[flow_script_transform: 메시지 → 도메인 매핑]
   │
   ▼
[flow_switch: data.status]
   │
   ├── case "STARTED" ─▶ [flow_start_work_order]
   ├── case "PAUSED"  ─▶ [flow_pause_work_order]
   ├── case "DONE"    ─▶ [flow_end_work_order]
   └── DEFAULT        ─▶ [flow_log: WARN]
Aufwärts (intern → ERP)
[flow_on_entity_event]   (originator.entity_type=Order)
   │
   ▼
[flow_msg_type_filter: type in [ENTITY_UPDATED]]
   │
   ▼ TRUE
[flow_template: ERP 형식으로 변환]
   │
   ▼
[flow_mqtt_publish: erp/work-order/status]
Um bei bidirektionaler Synchronisation eine Endlosschleife zu vermeiden, markieren Sie die Nachrichtenquelle mit einem Schlüssel wie
metadata.sourceund filtern Sie selbst veröffentlichte Nachrichten in der Trigger-Stufe heraus.
Import/Export
Sie können Flow-Definitionen als JSON serialisieren, um sie in andere Umgebungen zu übertragen oder zu sichern.
| Aktion | Ort | Beschreibung |
|---|---|---|
| Exportieren | Schaltfläche 내보내기 oben im Bearbeitungsbildschirm | Herunterladen des gesamten Graphen + Nodes + Wires + Node-Konfiguration als JSON |
| Importieren | Schaltfläche 가져오기 oben im Listenbildschirm | JSON-Text einfügen oder hochladen |
| Automatischer Snapshot | Automatisch beim Speichern | Beim Graph-Speichern versionsweise angelegt (für Rollback) |
Import-Verhalten
- Es wird immer eine neue Flow-ID ausgestellt (Verhinderung des Überschreibens bestehender IDs)
- Auch Node-IDs werden neu vergeben, die Wire-Links werden automatisch neu zugeordnet
- Der Flow direkt nach dem Import wird im Zustand aufgehoben angelegt; der Operator muss ihn nach Prüfung selbst bereitstellen
Fehlerbehandlung
Node-Ebene
- Tritt während der Node-Verarbeitung eine Ausnahme auf, wird automatisch in die Relation
FAILUREgeroutet. - Ist kein Node an den
FAILURE-Ausgang angeschlossen, wird die Nachricht verworfen (drop) und nur der Fehlerprotokolleintrag bleibt. - Nicht mit
*_patternübereinstimmende Nachrichten des Trigger-Nodes werden alsSKIPPEDbehandelt, nicht an Folgenodes weitergegeben und auch nicht in den Verarbeitungs-/Fehlerzähler aufgenommen. - Alle Fehler werden im Live-Debug-Panel und im Ausführungshistorie-Bildschirm angezeigt.
Flow-Ebene
| Element | Standardwert | Beschreibung |
|---|---|---|
| max_depth | 100 | Begrenzung der kumulierten Node-Besuche während der Verarbeitung einer Nachricht |
| max_revisit | 3 | Begrenzung der Wiederbesuche desselben Nodes (Vermeidung von Zyklus-Endlosschleifen) |
| flow_timeout_ms | 30.000 | Erzwungene Beendigung bei Überschreitung der Verarbeitungszeit |
Retry externer IO-Nodes
Externe IO-Nodes wie HTTP·Kafka·externe DB können über die Optionen retry_count / retry_delay_ms intern innerhalb des Nodes sofort erneut versuchen; bei Fehlschlag aller Versuche wird in die Relation FAILURE geroutet. Bei Bedarf an präziserem Backoff oder EXHAUSTED-Zweigbehandlung verwenden Sie separat den flow_retry-Node.
Betriebsdiagnose
Administratoren können im Systemmenü den Status der Dispatch-Warteschlange der Flow-Engine einsehen (Workerbetrieb, Größe der Warteschlange, kumulierte Verarbeitungs-/Fehlschlags-/Drop-Anzahl, letzter Fehler).
Der Server prüft periodisch im Hintergrund die Last des Flow-Worker-Pools und protokolliert bei anhaltend hoher Last für eine bestimmte Zeit eine Zeile mit der Statusänderung (HEALTHY → DEGRADED → CRITICAL) im Betriebsprotokoll. Bei Erholung wird ein weiterer Erholungslog-Eintrag hinzugefügt.
Berechtigungen
Für Flow wird kein separates Berechtigungsmodell eingeführt, sondern die bestehende Systemauthentifizierung/-berechtigung unverändert genutzt.
| Funktion | Erforderliche Berechtigung |
|---|---|
| Listenabfrage / Ausführungshistorienabfrage | Alle authentifizierten Benutzer |
| Erstellen·Bearbeiten·Bereitstellen·Löschen von Flows | ADMIN |
| Import/Export / Alle neu bereitstellen | ADMIN |
Betriebsmuster (Recipes)
Eine Bibliothek häufig verwendeter Verdrahtungsformen. Jedes Muster können Sie unverändert kopieren und als Ausgangspunkt für einen neuen Flow verwenden.
Muster 1 — Verarbeitung + Benachrichtigungszweig
Doppelte Verzweigung: SUCCESS wird gespeichert, FAILURE wird zur Benachrichtigung.
[Action Node]
   ├── SUCCESS → [flow_log] / [flow_save_attributes] / ...
   └── FAILURE → [flow_send_email] / [flow_send_push]
Muster 2 — Sicherer Retry
Konfiguration mit Backoff + EXHAUSTED-Handler, damit externe IO robust gegen vorübergehende Fehler ist.
[risky_node] ─[FAILURE]→ [flow_retry] ─[SUCCESS]→  (risky_node 로 루프)
                                       └[EXHAUSTED]→ [에러 핸들러]
Muster 3 — Lastblockierung durch Vorabfilter
Reduziert den nachfolgenden Durchsatz durch vorheriges Filtern von Nachrichten mit *_pattern auf Trigger-Ebene. Nicht übereinstimmende Muster werden als SKIPPED behandelt und nicht in den Zähler aufgenommen.
[flow_on_tag_point]    (옵션 tag_id_pattern: "MOTOR-*.SPEED")
   │
   ▼
[필터/변환/액션 ...]
Muster 4 — Mehrfache Case-Verzweigung
Verzweigung in mehrere Zweige je nach Status/Typ.
[flow_switch]   (case별 boolean 표현식)
   ├── case A → [...]
   ├── case B → [...]
   └── DEFAULT → [...]
Muster 5 — Fensterakkumulierung + einmaliges Emit
Sammelt hochfrequente Eingaben über einen bestimmten Zeitraum und wandelt sie in eine Nachricht um.
[High-rate Trigger]
   │
   ▼
[flow_merge: window_ms=10000]   → data.merged 배열에 누적
   │
   ▼
[flow_script_transform: 요약]
   │
   ▼
[Action / 외부 발송]
Muster 6 — Retry + Umleitung nach Erreichen des Wiederholungslimits
Wenn Retry beendet ist, Umleitung auf einen Backup-Pfad (andere API, Benachrichtigung, DB-Speicherung).
[Primary HTTP] ─[FAILURE]→ [flow_retry]
                            ├─[SUCCESS]    → (Primary HTTP)
                            └─[EXHAUSTED]  → [Backup HTTP] ─[FAILURE]→ [flow_log/Email]
Muster 7 — Folgeaktion nach Domänenänderung
Transformiert einen Tag-bezogenen Alarm auf die übergeordnete Anlagenebene und delegiert die Verarbeitung an die Anlage.
[flow_on_tag_alarm]
   │
   ▼
[flow_change_originator: Tag → Asset]
   │
   ▼
[자산 단위 액션 (Create Work Order / Publish Asset Event 등)]
Muster 8 — Kombination von Throttle + Debounce
Throttle auf max. 1× pro Minute + Verarbeitung nur bei 5 Sekunden ohne Änderung.
[High-rate Trigger]
   │
   ▼
[flow_throttle: max_msgs=1, window_ms=60000]
   │
   ▼ SUCCESS
[flow_debounce: window_ms=5000]
   │
   ▼
[Action]
Muster 9 — Modularisierung gemeinsamer Logik über Subflow
Wenn mehrere Einstiegspunkte dieselbe Folgeverarbeitung (Validierung·Aufbereitung·Speicherung) teilen müssen, Auslagerung in einen Subflow.
메인1: [Trigger A] → [flow_subflow: target=FLOW_99]
메인2: [Trigger B] → [flow_subflow: target=FLOW_99]

서브 (FLOW_99): (트리거 없음)
[검증] → [정제] → [적재]
Muster 10 — Umleitung über direkten Trigger
Um das Ergebnis eines anderen Flows als Eingabe eines nächsten Flows fließen zu lassen, mit flow_dds_publish im Domänenkanal veröffentlichen; der andere Flow empfängt denselben Nachrichtentyp als Trigger.
플로우 A: [...] → [flow_dds_publish: type=ASSET_EVENT, originator=...]
플로우 B: [flow_on_asset_event] → [...]
Anwendungsbeispiele (auf einen Blick)
| Szenario | Aufbau |
|---|---|
| MES-Anbindung | flow_schedule → flow_http_request → flow_script_transform → flow_create_work_order |
| Externe Weiterleitung von Ereignissen | flow_on_asset_event → flow_msg_type_filter → flow_mqtt_publish |
| Datenaufbereitung·Speicherung | flow_on_tag_point → flow_script_transform → flow_save_tag_point |
| Alarmautomatisierung | flow_on_tag_alarm → flow_script_filter → flow_send_email + flow_create_work_order |
| Externe DB-Synchronisation | flow_jdbc_poll → flow_script_transform → flow_create_asset |
| Webhook-Empfang | flow_on_webhook → flow_script_filter → flow_publish_asset_command |
| Automatische Anpassung des Alarmbands | flow_on_asset_aggregation → flow_script_transform → flow_update_tag_alarm_band_numeric |
| Automatisierung des Arbeitsauftragsstatus | flow_on_asset_event → flow_switch → flow_start/end/pause/resume_work_order |
| Verbesserung der API-Zuverlässigkeit | flow_http_request ─FAILURE→ flow_retry ─SUCCESS→ Schleife / EXHAUSTED→ Benachrichtigung |
| Benachrichtigung bei niedriger OEE | flow_on_oee_event → flow_script_filter → flow_template → flow_send_push |
| Massenregistrierung von Edges | flow_on_webhook → flow_edge_opc_create → flow_split → flow_edge_tag_create → flow_edge_opc_start |
| Hochfrequente Aufbereitung | flow_throttle → flow_debounce → Folge |
| Aufsummierung mehrerer Ereignisse | Mehrfach-Trigger → flow_merge → Zusammenfassungstransformation → Versand |
Schrittweiser Debugging-Leitfaden
Ein Standardverfahren, dem Sie folgen sollten, wenn ein Flow nicht wie beabsichtigt funktioniert.
Schritt 1 — Auslösestatus prüfen
Prüfen Sie im Listenbildschirm, ob die Ausführungsanzahl des betreffenden Flows zunimmt.
| Beobachtung | Bedeutung·nächste Maßnahme |
|---|---|
| Zähler bei 0 | Trigger löst nicht aus. Prüfen Sie den Bereitstellungsstatus des Flows + die Trigger-Node-Verdrahtung + die Option *_pattern |
| Zähler steigt, aber auch Fehler steigt | Fehlschlag im Aktions-Node. Weiter zu Schritt 2 |
| Zähler steigt, aber Folgeverarbeitung fehlt | Verzweigungsverdrahtung fehlt. Alle Ausgänge wie FAILURE/THROTTLED/EXHAUSTED prüfen |
Schritt 2 — Node-bezogenen Ablauf über Live-Debug prüfen
Öffnen Sie den Bearbeitungsbildschirm und aktivieren Sie das Live-Debug-Panel (Aktualisierung alle 2 Sekunden).
| Beobachtung | Bedeutung |
|---|---|
| Leuchtanzeige eines bestimmten Nodes bleibt grau | Nachricht kommt nicht an — im vorherigen Node in Zweig FAILURE oder vom Filter blockiert |
| Leuchtanzeige rot + ERROR-Zeile | Ausnahme während der Node-Verarbeitung. Feld data.error der Nachricht und NODE_ERROR-Ereignis in /flow/log prüfen |
| Leuchtanzeige grün, aber nächster Node grau | Relation-Label der Ausgabe stimmt nicht überein. Prüfen, ob das Wire-Label exakt mit der Ausgangs-Relation des Nodes (SUCCESS/TRUE usw.) übereinstimmt |
Schritt 3 — Nachrichten über den Ausführungshistorie-Bildschirm verfolgen
Verfolgen Sie im Bildschirm /flow/log anhand der Nachrichten-ID den gesamten Ablauf einer einzelnen Nachricht.
- Im Nachrichten-ID-Filter die im Live-Debug beobachtete
msg_ideingeben - Sortierung chronologisch in der Reihenfolge
FLOW_START→NODE_IN→NODE_OUT→FLOW_END - Bei sichtbarem
NODE_ERRORliegt die Ursache imerror_messagedieses Nodes
Schritt 4 — Node-Konfiguration prüfen
Häufige Fehler:
| Fehler | Prüfung |
|---|---|
Tippfehler im Pfad *_field | Stimmt data.tag_id? Ist es metadata.tag_id? Tatsächlichen Schlüssel über die Nachrichtenvorschau des Live-Debug prüfen |
Vorlagenvariable ${...} nicht substituiert | Prüfen, ob der Variablenpfad in der Nachricht existiert, keine Tippfehler |
| Timeout bei externer IO | timeout_ms erhöhen. Antwortzeit des externen Systems selbst |
| Berechtigung·Authentifizierungsheader | Prüfen, ob das JSON-Format von headers korrekt ist und das Token noch gültig ist |
Schritt 5 — Isolierter Test
Verschieben Sie den problematischen Node isoliert in einen neuen temporären Flow und lösen Sie mit Testlauf genau eine Nachricht aus, um das Ergebnis isoliert zu verifizieren. Funktioniert er normal, liegt der Verdacht bei der Verdrahtung des ursprünglichen Flows bzw. der Form der Nachricht aus der vorherigen Stufe.
Schritt 6 — Reproduktion nach Zählerreset
Wenn Sie nach dem Zurücksetzen aller Zähler genau eine Nachricht auslösen, um mit einer sauberen Statistik zu reproduzieren, wird das Problem klarer erkennbar.
Häufig auftretende Probleme
| Symptom | Ursache·Maßnahme |
|---|---|
| Trigger löst nicht aus | Prüfen, ob der Flow im Zustand Bereitstellen ist und ob *_pattern des Trigger-Nodes nicht zu eng ist. Bei Schedule-/externen Abo-Nodes erneut versuchen nach Alle neu bereitstellen |
| Live-Debug ist leer | Prüfen, ob der Nachrichtenzähler nicht steigt — nicht übereinstimmende Trigger-Muster (SKIPPED) werden nicht im Zähler gezählt. Auch prüfen, ob der Pausenschalter oben im Panel aktiviert ist |
| Zählerwerte akkumulieren sich anormal | Mit der Schaltfläche Alle Zähler zurücksetzen oben rechts in der Node-Konfiguration das Statistikfenster zurücksetzen |
| Dieselbe Nachricht wird wiederholt verarbeitet | Zyklus vermuten. Wiederbesuch desselben Nodes ist nur innerhalb von max_revisit (Standard 3-mal) erlaubt. Mit flow_subflow trennen und Eingabemenge über flow_throttle/flow_debounce anpassen |
| Externer Systemaufruf schlägt gelegentlich fehl | Backoff-Retry über die Optionen retry_count/retry_delay_ms oder den Node flow_retry verdrahten |
| Schedule funktioniert nach Import nicht | Alle neu bereitstellen oben im Listenbildschirm ausführen |
| Nach Update-Node-Ausführung bleiben manche Felder unverändert | Beabsichtigtes Verhalten. Der Update-Node aktualisiert nur die eingegebenen Felder und behält den Rest bei. Vollständige Aktualisierung: Kombination Delete + Create |
| Create-Node schlägt mit NOT-NULL-Fehler fehl | Prüfen, ob der Pfad der dynamischen Option *_field in der Node-Konfiguration tatsächlich in der Nachricht existiert. Manche NOT-NULL-Spalten werden automatisch ergänzt, aber Kern-IDs (asset_id, tag_id usw.) müssen Sie selbst befüllen |
flow_kafka_publish / flow_mqtt_publish wird nicht veröffentlicht | Verbindungsinformationen zum externen Broker (bootstrap_servers/broker_url) und Topic-Berechtigung prüfen. Mit flow_log daneben verdrahten, um zu prüfen, ob die Nachricht kurz vor der Veröffentlichung ankommt |
flow_http_request erhält keine Antwort | timeout_ms (Standard 5000) erhöhen und den Body direkt im Format ${msg.data.x} in body_template angeben. Die Antwort wird in data.response_status / data.response abgelegt |
flow_retry wird nicht erneut versucht | Fall einer fehlerhaften Verdrahtung. Der SUCCESS-Ausgang von flow_retry muss wieder zum ursprünglichen fehlgeschlagenen Node zurückgeführt werden, damit ein Retry erfolgt (siehe Muster 2 unten) |
Eine Zeile wie flow_jdbc_poll kommt jedes Mal erneut herein | Die Bedingung WHERE der Polling-SQL muss die Statusaktualisierung nach der Verarbeitung enthalten (z. B. WHERE sync_status='NEW' + am Ende desselben Flows UPDATE ... sync_status='OK' mit flow_jdbc_query) |
| Der Node zur direkten Alarmauslösung ist nicht auffindbar | Beabsichtigter Ausschluss. Alarme sollten nur über den flow_create_alarm_config-Pfad entstehen, damit die Konsistenz der Alarmhistorie gewahrt bleibt |
Script-Node schlägt mit Zugriffsfehler auf Java class fehl | In der Skript-Sandbox gesperrt. Verdrahten Sie für externe Aufrufe einen separaten externen Anbindungs-Node |
Beim Zustandsübergangsnode des Arbeitsauftrags kommt nur FAILURE heraus | Der aktuelle Zustand ist nicht der Ausgangszustand, von dem ein Übergang möglich ist. Beispiel: flow_pause_work_order funktioniert nur im Zustand START. Vorher mit flow_check_existence_field / flow_script_filter den Zustand prüfen |
| Testlauf hat funktioniert, aber der Graph blieb geändert | Der Testlauf löst immer die gespeicherte Version aus. Um Änderungen zu prüfen, zuerst speichern → dann Testlauf |
| Importierter Flow ist inaktiv | Beabsichtigtes Verhalten. Nach Prüfung selbst den Schalter Bereitstellen aktivieren |
Häufig gestellte Fragen (FAQ)
Häufig gestellte Fragen von Operatoren bei der erstmaligen Nutzung von Flow.
F. Kann ein Flow mehrere Trigger haben?
A. Ja. Wenn Sie im selben Flow mehrere Trigger-Nodes platzieren, werden alle zu Einstiegspunkten und lösen unabhängig aus. In Kombination mit flow_merge können Sie mehrere Ereignistypen in eine gemeinsame Folgeverarbeitung zusammenführen.
F. Kann ich auch einen Flow ohne Trigger erstellen?
A. Ja. Beim Speichern erscheint eine Warnung, aber gespeichert wird trotzdem. Sie können ihn als „Bibliothek“ verwenden, die nur über Testlauf oder den flow_subflow-Aufruf eines anderen Flows ausgelöst wird.
F. Kann eine Nachricht mehrere Nodes gleichzeitig durchlaufen? A. Ja. Wenn Sie mehrere Wires am Ausgangsport eines Nodes verbinden, wird dieselbe Nachricht gleichzeitig verzweigt und an alle Folgenodes weitergeleitet.
F. Kann ich im Transformationsnode selbst eine Nachricht erzeugen und in eine andere umwandeln?
A. Ja. In flow_script_transform können Sie msg.type, msg.originator, msg.data, msg.metadata alle frei ändern. Auch wenn die Nachricht selbst so aussieht, als sei sie ein anderer Triggertyp, ruft sie dadurch keinen anderen Flow automatisch auf (die ursprüngliche Trigger-Zuordnung bleibt erhalten). Um einen anderen Flow aufzurufen, verwenden Sie flow_subflow oder flow_dds_publish.
F. Wie viele automatische Snapshots werden aufbewahrt? Kann ich selbst wiederherstellen?
A. Bei jedem Graph-Speichern wird automatisch ein Snapshot angelegt; die Aufbewahrungsrichtlinie folgt der Konfiguration der Betriebsumgebung. Eine UI zur direkten Wiederherstellung im Bildschirm wird nicht angeboten; bei Bedarf können Sie den Administrator bitten, auf eine bestimmte Version zurückzusetzen. Am sichersten ist es, vor Änderungen die JSON-Datei per 내보내기 extern aufzubewahren.
F. Wie lange wird die Ausführungshistorie aufbewahrt?
A. Standardmäßig 7 Tage. Falls Langzeitspeicherung nötig ist, laden Sie über flow_kafka_publish oder flow_jdbc_query in ein externes Log-System.
F. Ich möchte nur die Statistik eines Flows separat zurücksetzen. A. Verwenden Sie oben rechts in der Node-Konfiguration des Bearbeitungsbildschirms Fehlerzähler zurücksetzen (nur Fehler) oder Alle Zähler zurücksetzen (alles). Andere Flows sind davon nicht betroffen.
F. Ich möchte einen Flow in eine andere Umgebung (Entwicklung/Staging/Produktion) verschieben.
A. Laden Sie das JSON über 내보내기 im Bearbeitungsbildschirm herunter und laden Sie es über 가져오기 im Listenbildschirm der Zielumgebung hoch. Ein importierter Flow wird immer mit neuer ID + im Zustand aufgehoben angelegt, sodass der Operator ihn nach Prüfung selbst bereitstellen kann.
F. Dieselbe Payload wird zweimal verarbeitet. Wie kann ich das verhindern?
A. Engen Sie den Trigger mit *_pattern ein oder begrenzen Sie die Frequenz mit flow_throttle/flow_debounce. Bei externen Eingaben (Webhook·MQTT) können Sie auf der Senderseite einen Idempotenz-Schlüssel setzen und Duplikate über flow_check_existence_field oder einen nachrichten-ID-basierten Filter herausfiltern.
F. Ist eine Zyklus-(Schleifen-)Verdrahtung sicher?
A. Ein beabsichtigter Zyklus wie flow_retry ist sicher. Andere Zyklen werden automatisch durch max_revisit (Standard 3-mal) blockiert. Während des Betriebs empfiehlt es sich jedoch, den Ablauf mit flow_log zu visualisieren, um unbeabsichtigte Zyklen frühzeitig zu erkennen.
F. Werden Flow-Änderungen in Echtzeit wirksam? A. Beim Graph-Speichern sofort wirksam. Allerdings müssen Trigger mit eigenem Scheduler wie Schedule·externes Abonnement·externes DB-Polling über Alle neu bereitstellen oder durch Aufheben→Bereitstellen erneut registriert werden.
F. Kann ich die ID eines bereits registrierten Nodes ändern? A. Die Node-ID wird vom System automatisch vergeben. Der Anzeigename kann im Node-Konfigurationsformular geändert werden; im Live-Debug·in der Ausführungshistorie wird der Anzeigename verwendet.
F. Kann ein Benutzer ohne Berechtigung versehentlich einen Flow ändern? A. Erstellen·Bearbeiten·Bereitstellen·Löschen von Flows benötigt ADMIN-Berechtigung. Normale Benutzer können nur die Liste und die Ausführungshistorie einsehen.
Best Practices für den Betrieb
Grundsätze, die Sie beim sicheren Betrieb von Flows in der Produktion beachten sollten.
Lastmanagement
- Filtern Sie in der Trigger-Stufe mit
*_patternvorab, um den Folgeverarbeitungsaufwand zu reduzieren. Tag-Datenpunkte mit mehreren zehntausend Eingängen pro Minute sind der teuerste Einstiegspunkt. - Kombinieren Sie Aufrufe externer Systeme (
flow_http_request/flow_jdbc_queryusw.) mitflow_throttle/flow_debounce, um die externe Last zu steuern. - Wenn mehrere Folgenodes an dieselbe Eingabe hängen sollen, trennen Sie diese mit
flow_subflow, um die Gesamtzahl der Nodes im Graphen zu senken. Je mehr Nodes, desto höher auch die Polling-Kosten des Live-Debug. - Aktivieren Sie den Debug-Modus nur während der Betriebsverifizierung. Je mehr geladen wird, desto schneller füllt sich das 7-Tage-Fenster der Ausführungshistorie.
Sichere Erstellung
- Verdrahten Sie bei allen Aktions-Nodes unbedingt die
FAILURE-Verzweigung (mindestensflow_log). IstFAILUREleer, wird die Nachricht still verworfen, was die Vorfallverfolgung erschwert. - Kombinieren Sie externe IO-Nodes, wenn möglich, mit
flow_retry, um vorübergehende Störungen abzufangen. - Update-Nodes aktualisieren nur die eingegebenen Felder (Teilaktualisierung). Für vollständiges Überschreiben verwenden Sie die Kombination Delete + Create.
- Graphen ohne Trigger-Node sind nur für manuellen Testlauf. Prüfen Sie die Warnung beim Speichern, um nicht versehentlich den Trigger zu vergessen.
- Erstellen Sie Zyklen (Verdrahtung zurück zum gleichen Node) nur bewusst in Form wie
flow_retry; in anderen Fällen schütztmax_revisit, aber visualisieren Sie verdächtige Graphen mitflow_log.
Änderungsverfahren (Change Management)
Empfohlene Reihenfolge bei der Änderung eines produktiven Flows.
- Backup — Aktuellen Graphen über
내보내기im Bearbeitungsbildschirm als JSON-Datei herunterladen und aufbewahren (auch wenn automatische Snapshots angelegt werden, ist externe Aufbewahrung sicherer). - In Kopie oder neuem Flow arbeiten — Bearbeiten und verifizieren Sie Änderungen eher in einem neuen Flow (oder einer per Import erstellten Kopie) als am laufenden Flow direkt.
- Testlauf — Injizieren Sie direkt JSON-Nachrichten, um jede Verzweigung (SUCCESS/FAILURE/EXHAUSTED usw.) einmal auszulösen und das Ergebnis in der Ausführungshistorie zu prüfen.
- In Produktion übernehmen — Verifiziertes Graph-JSON über
내보내기→ in der Produktionsumgebung über가져오기→ nach Prüfung durch den Operator den Bereitstellen-Schalter aktivieren. - Rollback bei Problemen — Sofort mit dem Aufheben-Schalter deaktivieren. Da automatische Snapshots angelegt sind, kann der Entwickler bei Bedarf auf eine vorherige Version zurücksetzen.
Nutzung von Zählern·Statistik
- Falls die Verarbeitungstrend-Sparkline im Listenbildschirm plötzlich flach wird, prüfen Sie auf nicht ausgelösten Trigger oder mögliche SKIPPED-Behandlung.
- Ist das Fehlerquote-Donut-Diagramm anormal, vermuten Sie den
*_field-Pfad in der Node-Konfiguration. Fehlt der Schlüssel in der Nachrichten-Payload, schlägt es häufig fehl. - Nach der Betriebsverifizierung setzen Sie mit Alle Zähler zurücksetzen das Statistikfenster zurück, um die normale Baseline neu zu messen.
Notfallreaktionsverfahren
Schrittweises Verfahren, das Sie bei einem Problem im Betrieb schnell anwenden sollten.
Szenario 1 — Ein bestimmter Flow läuft Amok (Nachrichtenexplosion)
Symptom: Die Ausführungszahl eines Flows steigt um das Zehn- bis Hundertfache gegenüber dem Normalwert, begleitet von zunehmenden Fehlern
Maßnahme
- Sofort den betreffenden Flow über den Aufheben-Schalter deaktivieren (1 Sekunde im Listenbildschirm)
- Im Live-Debug-Panel·in der Ausführungshistorie prüfen, welcher Trigger die Explosion verursacht hat
- Die Option
*_patterndes Trigger-Nodes einengen oder direkt danachflow_throttle/flow_debounceverdrahten - Falls nötig, den Nachrichtentyp mit
flow_check_existence_fieldoderflow_msg_type_filtereingrenzen - Nach der Korrektur mit Testlauf reproduzieren → nach normaler Bestätigung Bereitstellen wieder aufnehmen
Szenario 2 — Massenausfall durch Störung eines externen Systems
Symptom: Gleichzeitige Fehleranhäufung bei externen IO-Nodes wie HTTP/Kafka/externer DB
Maßnahme
- Bei breiter Auswirkung die betroffenen Flows in Masse aufheben (Massenauswahl im Listenbildschirm, dann Massenaufhebung)
- Wiederherstellung des externen Systems bestätigen
- Bei externen IO-Nodes ohne
flow_retry-Verdrahtung eine solche hinzufügen - Bei verlangsamter Antwort des externen Systems
timeout_msanpassen - Je nach Betriebsumgebung nach Alle neu bereitstellen die Bereitstellung wieder aufnehmen
Szenario 3 — Endlosschleife durch Zyklus
Symptom: Eine einzelne Nachricht durchläuft ständig denselben Node, akkumulierte Verarbeitungszeit
Maßnahme
- Der
max_revisit-Schutz blockiert automatisch nach maximal 3 Wiederbesuchen, aber zur Betriebssicherheit aufheben und prüfen - Zyklus im Graphen visuell verfolgen (im Bearbeitungsbildschirm den Wires folgen)
- Bei beabsichtigter Schleife (
flow_retry) prüfen, obmax_attemptsangemessen ist - Bei unbeabsichtigtem Zyklus Verdrahtung entfernen oder Verzweigung mit
flow_check_relationhinzufügen - Nach der Korrektur Alle Zähler zurücksetzen → erneut bereitstellen
Szenario 4 — Verdacht auf Datenbeschädigung (fehlerhafte automatische Aktualisierung)
Symptom: Domänendaten wurden durch Automatisierung entgegen der Absicht aktualisiert
Maßnahme
- Sofort den betreffenden Flow aufheben
- Externes JSON-Backup des vorherigen Graphen oder vorherige Version aus dem automatischen Snapshot prüfen (mit Unterstützung des Administrators)
- Graph analysieren: unbeabsichtigte Update-Node-Verdrahtung·fehlerhaften
*_field-Pfad·Skript-Transformationsfehler prüfen - Betroffene Domänendaten separat über das Backoffice-Verfahren korrigieren
- Den korrigierten Graphen mit Testlauf verifizieren und erneut bereitstellen
Szenario 5 — Stopp während Systeminspektion·Wartung
Symptom: Externe IO-Aufrufe sollen während der Wartungszeit des externen Systems vorübergehend gestoppt werden
Maßnahme
- Betroffene Flows in Masse aufheben (Mehrfachauswahl in der Liste)
- Nach Ende der Wartung Bereitstellung wieder aufnehmen
- Bei Triggern mit eigenem Scheduler (Schedule·externes MQTT-Abonnement·externes DB-Polling) einmal Alle neu bereitstellen ausführen, um die korrekte Registrierung zu bestätigen
Szenario 6 — Live-Debug-Ladewarteschlange voll
Symptom: Die Größe der Ladewarteschlange in der Betriebsdiagnoseseite liegt nahe am Schwellenwert, Drop-Anzahl steigt
Maßnahme
- Reduzieren Sie die Anzahl der Flows mit aktiviertem Debug-Modus und die Ladung (verifizierte Flows: Debug-Modus AUS)
- Reduzieren Sie den Folgeverarbeitungsaufwand selbst mit
*_patternin der Trigger-Stufe - Wenn das System automatisch in den Erholungsmodus wechselt, wird vom Last-Watchdog eine Zeile mit
DEGRADED/CRITICALprotokolliert — teilen Sie diese mit dem Administrator
In allen Szenarien gilt die Reihenfolge sofort aufheben → Ursache klären → korrigieren → verifizieren → erneut bereitstellen. Siehe auch das Änderungssicherheitsverfahren.
Sicherheit·Umgang mit sensiblen Informationen
Da Flow sensible Ein-/Ausgaben wie externe API-Aufrufe·E-Mail-/SMS-Versand·Webhook-Empfang verarbeitet, beachten Sie folgende Grundsätze.
Token·Anmeldedaten
- Geben Sie API-Token·Passwörter nicht im Klartext direkt in die Node-Konfiguration ein. Verwenden Sie die Substitution über Umgebungsvariablen in Form von
${ENV_VAR}, um sie aus dem geheimen Speicher der Betriebsumgebung einzuspeisen. - Trennen Sie die Token-Position im
headersJSON, um Tokens in der Produktionsumgebung möglichst als Umgebungsvariable zu isolieren.
// 권장
{ "Authorization": "Bearer ${MES_TOKEN}" }

// 비권장
{ "Authorization": "Bearer eyJhbGciOi..." }
Schutz des Webhook-Einstiegspunkts
flow_on_webhook ist ein interner Einstiegspunkt, der von authentifizierten Benutzern aufgerufen wird; wenn Sie ihn nach außen exponieren, verdrahten Sie unbedingt einen Payload-Validierungsfilter.
// flow_script_filter — 토큰 + 필수 필드 검사
if (data.token !== '${WEBHOOK_TOKEN}') return false;
if (!data.asset_id || !data.cmd_key)   return false;
true
Maskierung sensibler Daten
Im Live-Debug-Panel und in der Ausführungshistorie wird eine Nachrichtenvorschau angezeigt. Maskieren Sie persönliche Daten (Name·Kontakt·Konto) und Tokens unmittelbar vor der Speicherung.
// 디버그/로그 적재 직전 변환
data.email_masked = data.email
  ? data.email.replace(/(.{2}).+(@.+)/, '$1***$2') : null;
delete data.email;
delete data.token;
msg
Verarbeitung des Response-Bodys externer IO
Bei flow_http_request wird der gesamte data.response-Response-Body geladen. Enthält die Antwort sensible Daten, extrahieren Sie sofort im Folgetransformationsnode nur die benötigten Schlüssel und entfernen Sie das Original.
// 응답에서 필요한 필드만 보존
data = { id: data.response_obj.id, status: data.response_obj.status };
msg
Isolierung von Script-Nodes
Script-Nodes werden in einer sicheren Sandbox ausgeführt, wobei Datei-, Netzwerk- und beliebiger Klassenzugriff gesperrt sind. Verdrahten Sie bei Bedarf externer Aufrufe unbedingt einen separaten externen Anbindungs-Node.
Flow-Metriken und Alarme
Automatisch erfasste Kennzahlen während des Flow-Betriebs, wo Sie sie sehen und wie Sie Alarme darauf setzen.
Flow-bezogene KPIs
In jeder Zeile des Listenbildschirms (/flow/index) werden folgende KPIs angezeigt.
| Kennzahl | Bedeutung | Anormales Signal |
|---|---|---|
| Gesamtausführungsanzahl | Anzahl der Durchläufe durch den Graphen infolge eines Trigger-Auslösens (Summe von Erfolg/Fehlschlag) | Starker Rückgang gegenüber normal → Trigger tot / starker Anstieg → Amoklauf |
| Fehleranzahl | Anzahl der Fälle, die an irgendeinem Node des Graphen in den FAILURE-Zweig gefallen sind | Ab 5 % des Gesamtwerts prüfen |
| Fehlerquote | 에러 / 전체 × 100 | Bei Überschreiten eines bestimmten Schwellenwerts Alarm setzen |
| Letzte Ausführung | Zeitpunkt der jüngsten Auslösung | Nur OK, wenn „mehr als 5 Minuten keine Auslösung“ normal ist |
| Durchschnittliche Verarbeitungszeit | Durchschnittliche ms, die eine Nachricht benötigt, um den ganzen Graphen zu durchlaufen | Ändert sich stark bei Hinzufügen/Entfernen externer IO-Nodes |
| Trend der letzten Verarbeitungszeit | 5-Minuten-Sparkline — Live-Debug-Panel | Bei Spikes Antwortzeit des externen Systems prüfen |
Node-bezogene KPIs
Beim Klick auf einen Node im Bearbeitungsbildschirm wird unten rechts am Node Folgendes angezeigt.
[Node Name]
처리 999 · 에러 3 · 평균 12ms · 최근 18ms
| Position | Anzeige |
|---|---|
| Obere Leuchtanzeige | Grau (wartend) / Grün (in Verarbeitung) / Rot (Fehler) |
| Untere Beschriftung | 처리 N · 에러 M · 평균 Xms · 최근 Yms |
4 Node-Statistiken
| Zähler | Bedeutung |
|---|---|
| Verarbeitung | Anzahl der in diesen Node eingegangenen und über normale Verzweigung ausgegangenen Nachrichten |
| Fehler | Anzahl der FAILURE-Verzweigungen oder Ausnahmen |
| Durchschnittliche Verarbeitungszeit | Eigene Verarbeitungs-ms des Nodes (inkl. externer IO) |
| Letzte Verarbeitungszeit | Verarbeitungs-ms des jeweils letzten Eintrags |
Systemweite Metriken
Die Metriken der gesamten Flow-Engine finden Sie im Bildschirm System → Monitoring.
Die Metriken werden unter der JMX-Domain plantpulse.core.engine als folgende fünf freigegeben.
| Metrik | Art | Bedeutung | Ansicht |
|---|---|---|---|
FLOW_EXECUTOR_QUEUE_SIZE | Gauge | Größe der Warteschlange des Flow-Ausführungspools | Bei kontinuierlicher Anhäufung folgt die Verarbeitung dem Eingang nicht |
FLOW_EXECUTOR_ACTIVE_COUNT | Gauge | Anzahl aktiver Threads des Ausführungspools | Bei Anlehnung an die Poolgröße Sättigung |
FLOW_EXECUTOR_DROPPED_COUNT | Gauge (kumuliert) | Kumulierte Anzahl verworfener Tasks bei Poolsättigung | Ungleich 0 bedeutet Nachrichtenverlust — der zuerst zu prüfende Wert |
FLOW_DEBUG_QUEUE_SIZE | Gauge | Größe der Warteschlange für Debug-Ereignisse | Wird groß, wenn viele Flows mit Debug-Modus aktiviert sind |
FLOW_EXECUTION_TIME | Timer | Verteilung der Verarbeitungszeit pro Flow | Durchschnitt·Maximum verfolgen |
flow.engine.*Ein älteres Dokument listete flow.engine.queue_depth · in_flight · dispatch_lag_ms · exec_p95_ms
failed_per_min · script_timeout_per_min, aber Metriken mit solchen Namen existieren nicht.
Die oben genannten fünf sind alles.
(flow.engine.enabled ist keine Metrik, sondern ein Konfigurationsschlüssel von engine.properties —
das Master-Gate zum Abschalten der gesamten Flow-Engine.)
Muster zur Registrierung von metrikbasierten Alarmen
4 Muster zur Überwachung eigener Flow-Metriken über erweiterte Alarme oder CEP → Trigger.
Muster A — Überschreitung der Fehlerquotenschwelle
context EVERY_1_MINUTES
SELECT flow_id, count(CASE WHEN status='FAILURE' THEN 1 END) * 100.0 / count(*) AS err_pct
FROM   AssetEvent.win:time(5 min)
WHERE  event_type = 'FLOW_EXEC'
GROUP  BY flow_id
HAVING err_pct > 5
Muster B — Auftreten von Backpressure in der Verarbeitungswarteschlange
Alarm, wenn flow.engine.queue_depth > 500 länger als 1 Minute anhält — eine Situation, in der die Trigger-Auslösegeschwindigkeit die Verarbeitungsgeschwindigkeit überschreitet.
Muster C — Unterbrechung der Auslösung eines bestimmten Flows
SELECT * FROM pattern [
  every a = AssetEvent(event_type='FLOW_EXEC', flow_id='my-flow')
        -> ( timer:interval(15 min)
             and not AssetEvent(event_type='FLOW_EXEC', flow_id=a.flow_id) )
]
Alarm, wenn ein Flow, der normalerweise N-mal pro Minute auslöst, für mehr als 15 Minuten schweigt.
Muster D — Explosion der externen IO-Timeouts
context EVERY_5_MINUTES
SELECT flow_id, node_id, count(*) AS timeout_count
FROM   Log.win:time(5 min)
WHERE  module = 'flow-engine' AND code = 'NODE_TIMEOUT'
GROUP  BY flow_id, node_id
HAVING count(*) > 10
Empfehlung für Alarm-Ausgabekanäle
| Alarmart | Empfohlener Kanal |
|---|---|
| Fehlerquote·Auslöseunterbrechung (direkter Betrieb) | E-Mail + Push-Benachrichtigung |
| Warteschlangen-Backpressure·Timeout-Explosion (System) | Slack/Teams-Webhook |
| Automatische Diagnose (Referenz) | Nur Diagnoseprotokoll |
⚠️ Verlassen Sie sich für den Flow, der selbst für Alarme verwendet wird, niemals auf Metriken, die von diesem Alarm abhängen — wenn der Alarm-Flow abstürzt, kommt kein Alarm mehr. Überwachen Sie den Alarm-Flow über den externen Health-Check unter System → Monitoring.
Nachrichtenverarbeitungssemantik und Backpressure
Garantieniveau und Backpressure-Verhalten der Flow-Engine bei der Nachrichtenverarbeitung.
Zustellgarantie — At-Least-Once
Die Flow-Engine garantiert at-least-once-Zustellung.
| Fall | Verhalten |
|---|---|
| Normale Verarbeitung | Einmalige Auslösung → einmaliger Graphdurchlauf → einmaliger Abschluss |
| Neustart der Engine während der Verarbeitung | In der Trigger-Warteschlange verbliebene Nachrichten werden nach dem nächsten Boot erneut verarbeitet |
| Ausnahme auf Node-Ebene | Übergang nur in den FAILURE-Zweig. Die Nachricht verschwindet nicht |
| Timeout bei externer IO | Automatischer Retry über den FAILURE-Zweig + flow_retry möglich |
Duplikationsmöglichkeit — Es handelt sich nicht um exactly-once. Wenn
flow_create_*zwischendurch unterbrochen und erneut versucht wird, kann dieselbe ID zweimal eingehen; verwenden Sie daheron_duplicate=skipoder einen Idempotenz-Schlüssel des externen Systems.
Idempotenzschlüsselmuster
Muster zur Sicherstellung der Idempotenz beim Aufruf externer Systeme aus dem Flow.
// flow_script_transform — 멱등성 키 생성
msg.data.idempotency_key =
  msg.metadata.asset_id + '|' +
  msg.metadata.ts + '|' +
  msg.data.event_type;
Danach beim externen Aufruf im Header anhängen:
"headers": { "Idempotency-Key": "${data.idempotency_key}" }
Verarbeitungsreihenfolge — trigger-bezogenes FIFO
| Nachrichten desselben Originators | Anderer Originator |
|---|---|
| Trigger-bezogenes FIFO (in Ankunftsreihenfolge) | Parallele Verarbeitung (unabhängig von der Reihenfolge) |
Selbst wenn zwei Ereignisse der Anlage A fast gleichzeitig auftreten, werden die Ereignisse von A in der Auftrittsreihenfolge verarbeitet. Die Ereignisse von Anlage A und Anlage B können jedoch parallel von unterschiedlichen Workern verarbeitet werden.
Backpressure
Verhalten, wenn die Verarbeitungsgeschwindigkeit der Auslösegeschwindigkeit nicht folgen kann.
| Situation | Verhalten |
|---|---|
| Warteschlangentiefe < 80 % | Normal — neuer Trigger wird sofort eingereiht |
| Warteschlangentiefe 80–100 % | Diagnose-WARN-Log tritt auf — Warteschlange nimmt weiterhin auf |
| Warteschlangentiefe = 100 % (voll) | Neuer Trigger wird verworfen (drop) + Diagnose-ERROR-Log |
Was der Operator tun sollte, wenn die Warteschlange voll ist
- Unter System → Monitoring
flow.engine.queue_depthprüfen - Im Listenbildschirm den Flow identifizieren, dessen Ausführungsanzahl explodiert ist
- Den Vorabfilter des Triggers (
*_pattern) dieses Flows einengen, um die Last zu senken - Oder die Bereitstellung dieses Flows vorübergehend aufheben, um im Notfall zu handeln
Circuit Breaker (externe IO)
Externe IO-Nodes (HTTP/Kafka/MQTT/E-Mail) werden für 30 Sekunden pauschal gesperrt, sobald folgende Bedingungen erfüllt sind.
| Bedingung | Schwelle |
|---|---|
| Aufeinanderfolgende Fehlschläge innerhalb der letzten Minute | ≥ 10 |
| Durchschnittliche Antwortzeit | ≥ 10 Sekunden |
Während der Sperrung wird jede in diesen Node eingehende Nachricht sofort in FAILURE verzweigt. Erholt sich das externe System, wird die Sperrung automatisch aufgehoben. Dieses Verhalten isoliert einen externen Ausfall, sodass er nicht die gesamte Flow-Engine lähmt.
Der Zeitpunkt der Öffnung des Circuits wird im Diagnoselog als
code = CIRCUIT_OPENEDprotokolliert. Hat sich das externe System schnell erholt, können Sie immetadata.retry_countder Ausführungshistorie fehlende Nachrichten manuell erneut ausführen.
Vermeidung von Zyklen (Schleifen)
Wenn im Flow ein Zyklus wie der folgende entsteht, kann eine Endlosschleife auftreten.
A → B → C → A (잘못된 결선)
Die Flow-Engine blockiert Zyklen mit zwei Verteidigungslinien.
| Verteidigungslinie | Verhalten |
|---|---|
max_depth=100 | Erzwungene Beendigung nach 100 durchlaufenen Nodes |
max_revisit=3 | Nachricht wird beim 4. Besuch desselben Nodes verworfen + Diagnose-ERROR |
Die Schleife SUCCESS-Zweig von
flow_retry→ zurück zum ursprünglichen Node ist ein beabsichtigter Zyklus, und dametadata.retry_countzusammen ansteigt, endet er normal, bevor max_revisit ausgelöst wird.
Was in der Ausführungshistorie zu sehen ist
Codes wie NODE_SCRIPT_TIMEOUT · FLOW_TIMEOUT · FLOW_MAX_DEPTH · TRIGGER_QUEUE_FULL
WEBHOOK_AUTH_FAIL · DOMAIN_DUP_KEY waren in einer Tabelle aufgeführt, aber das Produkt erzeugt diese Strings nirgendwo.
Eine Log-Suche nach diesem Code ergibt für immer 0 Treffer.
Was die Flow-Engine tatsächlich aufzeichnet, sind die folgenden 5 Ereignistypen.
Im Flow-Ausführungshistorie (mm_flow_log, linkes Menü Automation > Flow-Ausführungshistorie) werden
fünf Ereignisarten geladen.
| Ereignistyp | Wann | Ladebedingung |
|---|---|---|
FLOW_START | Beim Flow-Eintritt | Immer |
FLOW_END | Ende der Flow-Verarbeitung (Erfolg·Timeout gleichermaßen) | Immer |
NODE_IN | Wenn der Node eine Nachricht empfängt | Nur im Debug-Modus |
NODE_OUT | Wenn der Node eine Nachricht ausgibt | Nur im Debug-Modus |
NODE_ERROR | Ausnahme während der Node-Verarbeitung | Immer |
Felder, die jede Zeile gemeinsam hat.
| Feld | Inhalt |
|---|---|
level | INFO / WARN / ERROR |
flow_id · flow_node_id · node_name · node_type | welcher Flow, welcher Node |
msg_id | zur nachrichten-bezogenen Verfolgung — um den Ablauf einer Nachricht zu verfolgen, gruppieren Sie nach diesem Wert |
message · error_message | für Menschen lesbare Beschreibung, Ausnahmenachricht |
duration_ns | Node-Ausführungszeit (Nanosekunden) — nur bei NODE_OUT · NODE_ERROR aussagekräftig |
NODE_IN · NODE_OUT werden nur im Debug-Modus geladen. Dass in der normalen Ausführungshistorie
nur FLOW_START · FLOW_END sichtbar sind, ist normal. Um jeden Node nachzuvollziehen,
aktivieren Sie den Debug-Modus des betreffenden Flows — dies erhöht jedoch die Log-Menge erheblich.
Nach Symptom suchen
Statt nach Codes gehen Sie vom Symptom aus.
| Symptom | Zuerst zu prüfen |
|---|---|
| Trigger löst aus, aber es scheint kein Node zu laufen | Ist der Flow bereitgestellt (Schalter ON) · filtert *_pattern des Triggers die Nachricht nicht heraus |
| Verarbeitung wird mittendrin unterbrochen | 30-Sekunden-Überschreitung (flow_timeout_ms) pro Nachricht. Prüfen Sie über die WARN-Warnung FlowExecutor timeout im Serverlog |
| Dieselbe Nachricht wird wiederholt verarbeitet | Zyklus. Wird automatisch durch max_revisit (3-mal) blockiert, prüfen Sie aber die Verdrahtung |
| Graph ist zu lang und endet nicht | Überschreitung von max_depth (100). In Subflows aufteilen |
| Node wirft eine Ausnahme | error_message der NODE_ERROR-Zeile in der Ausführungshistorie prüfen |
| Externer Aufruf schlägt fehl | data.response_status · data.error des betreffenden Nodes im Folgenode prüfen |
Die Grenzwerte (100 · 3 · 30.000 ms) sind die Standardwerte von
ExecutionState.
Cluster·Hochverfügbarkeit(HA)-Verhalten
Bei einer Plattform-Installation in einer Clusterumgebung arbeitet die Flow-Engine verteilt nach folgenden Regeln.
Trennung der Node-Rollen
| Rolle | Verhalten |
|---|---|
| Leader (Leader) | Einzelner Node, der Flow-Graph-Änderungen (Speichern/Bereitstellen/Aufheben) seriell verarbeitet |
| Worker (Worker) | Allgemeiner Node, der Trigger-Auslösung·Nachrichtenverarbeitung parallel ausführt (alle Nodes fungieren auch als Worker) |
| Scheduler (Scheduler) | Verantwortlich für die Auswertung des flow_schedule-Crons — derselbe Node wie der Leader |
Der Leader-Node wird beim Plattform-Boot automatisch gewählt; fällt der Leader aus, wird automatisch einer der anderen Nodes zum Leader befördert. Der Operator muss ihn nicht selbst bestimmen.
Nachrichtenverteilung — Anlagen-bezogenes konsistentes Routing
| Verteilungsschlüssel | Verhalten |
|---|---|
originator.id (Anlage/Tag/Bestellungs-ID) | Nachrichten derselben Anlage werden immer zum selben Worker geroutet — Sequenzgarantie |
Externer Eingang (flow_on_webhook usw.) | Round-Robin-Verteilung |
Diese Regel verhindert, dass die Reihenfolge der Ereignisse der Anlage A durcheinandergerät, weil sie gleichzeitig von mehreren Workern verarbeitet werden. Im Ergebnis gilt anlagenbezogen Garantie der Verarbeitung durch einen einzelnen Worker, zwischen Anlagen parallele Verarbeitung gleichzeitig.
Verhalten bei Leader-Ausfall — Failover
[Leader 다운 t=0]
        ↓
[다른 노드가 리더 승격 시도 t=0~3s]
        ↓
[새 리더 확정 t=3~5s]  ← cron 스케줄·플로우 배포 변경 재개
        ↓
[기존 워커들은 정상 동작 유지 — 트리거 처리 영향 없음]
| Phase | Auswirkung |
|---|---|
| 0–3 Sekunden | Cron-Auslösung flow_schedule vorübergehend pausiert / Trigger-Verarbeitung nicht betroffen |
| 3–5 Sekunden | Neuer Leader bestätigt, Schedule wird wieder aufgenommen |
| Nach 5 Sekunden | Normal |
Cron-Auslösungen führen nach der
misfire-Richtlinie einmal versäumte Auslösungen sofort erneut aus. Bei laufendem Betrieb kann bei einer Auswertungseinheit vonflow_scheduleunter 5 Sekunden ein kurzfristiges Versäumnis sichtbar werden.
Persistenz der Trigger-Warteschlange
| Element | Verhalten |
|---|---|
| Position der Trigger-Warteschlange | In-Memory-Warteschlange + permanenter Speicher (Transaktionsprotokoll) |
| Bei Node-Neustart | Unverarbeitete, in der Warteschlange verbliebene Nachrichten werden nach dem nächsten Boot erneut dispatcht |
| Node-Ausfall während der Verarbeitung | Diese Nachricht wird erneut verarbeitet, aber aufgrund der at-least-once-Garantie benötigt das externe System einen Idempotenzschlüssel |
Checkliste für den Operator bei Cluster-Bereitstellung
- Zeitsynchronisation aller Nodes (NTP) — Trigger-Auslösezeit muss zwischen den Nodes übereinstimmen
- Externe Systeme (MQTT-/Kafka-Broker) an einer Netzwerkposition platzieren, die alle Nodes erreichen können
- SMTP-Einstellungen des
flow_send_emailnur einmal in der Systemeinstellung registrieren — alle Nodes teilen sie sich - Worker-Poolgröße (
flow.engine.workers) je nach Anzahl der CPU-Kerne pro Node anpassen
Einzelknoten-Modus (Entwicklung·Kleinbetrieb)
- Leader·Worker·Scheduler laufen alle in einem einzigen Prozess
- Kein Failover — fällt der Node aus, wird der Flow selbst gestoppt
- Die Trigger-Warteschlange ist durch In-Memory + Disk gesichert und wird nach Neustart wiederherstellt
End-to-End-Trace
Methode zur nachträglichen Verfolgung, wie eine Nachricht den gesamten Graphen durchlaufen hat.
Automatische Vergabe der Korrelations-ID
Die Flow-Engine vergibt automatisch eine Korrelations-ID (correlation ID) an alle durch Trigger ausgelösten Nachrichten.
{
  "type": "POST_TELEMETRY",
  ...,
  "metadata": {
    "trace_id":   "tr-a1b2c3d4-e5f6-7890-...",
    "span_id":    "sp-01",
    "parent_id":  null,
    ...
  }
}
| Feld | Bedeutung |
|---|---|
metadata.trace_id | Eine für den gesamten Trigger-Durchlauf eindeutige ID — alle den Graphen durchlaufenden Nachrichten teilen sie |
metadata.span_id | Node-spezifische eindeutige ID — wird bei jedem Node-Durchlauf aktualisiert |
metadata.parent_id | span_id des unmittelbar vorherigen Nodes |
Suche über trace_id im Ausführungshistorie-Bildschirm
Wenn Sie im Ausführungshistorie-Bildschirm die ID in das Feld trace_id einfügen, werden die chronologischen Logs aller Nodes angezeigt, die diese Nachricht durchlaufen hat.
🔍 trace_id = tr-a1b2c3d4-...

[12:34:56.123] [trg]      flow_on_tag_point      태그=MOTOR.TEMP, value=87
[12:34:56.125] [filter]   flow_script_filter     score>80 → TRUE
[12:34:56.126] [transform] flow_change_originator Tag → Asset
[12:34:56.130] [action]   flow_create_work_order WO-20260513-001 생성
[12:34:56.241] [external] flow_send_email        admin@... 발송 성공
Trace-Weiterleitung beim Subflow-Aufruf
Wenn Sie mit dem Node flow_subflow einen anderen Flow aufrufen, wird dieselbe trace_id unverändert weitergeführt. Das heißt, alle Node-Logs des Haupt-Flows + des aufgerufenen Subflows sind über denselben Trace auffindbar.
Weiterleitung an externe Systeme
Bei einem externen HTTP-Aufruf wird automatisch der X-Trace-Id-Header angehängt.
GET /api/orders HTTP/1.1
Host: erp.example.com
X-Trace-Id: tr-a1b2c3d4-e5f6-...
X-Span-Id:  sp-04
Empfängt das externe System diesen Header und protokolliert ihn ebenfalls, können die Logs beider Systeme über dieselbe ID abgeglichen werden.
Anzeige der trace_id in Alarmen·E-Mails
Wenn Sie im Alarmtext oder E-Mail-Template ${metadata.trace_id} einbeziehen, kann der Operator direkt nach Empfang des Alarms im Historienbildschirm den Vorfall sofort verfolgen.
제목: [긴급] 모터 과열 — ${metadata.asset_id}
본문:
시각: ${metadata.ts}
값: ${data.value}°C
trace: ${metadata.trace_id}
이력 보기: https://platform.example.com/flow/log?trace_id=${metadata.trace_id}
Aufbewahrungsdauer des Trace
| Daten | Aufbewahrungsdauer |
|---|---|
| trace_id und Node-bezogenes Span-Log | 7 Tage (gleich wie Ausführungshistorie) |
| Externe Speicherung (Langzeitaufbewahrung) | Nutzung der externen Systemspiegelung unter Audit·Historien-Tracking |
Wenn die trace_id zu lang ist und die Nachrichtengröße belastet, können Sie mit
flow_script_transformeine Kurzform erzeugen, die nur die letzten 4 Zeichen (z. B.tr-...d4) anzeigt, und diese in Alarmen·E-Mails verwenden. Für die Suche wird jedoch die vollständige ID benötigt.
Katalog der Graph-Muster
10 häufig verwendete Verdrahtungsmuster im Flow-Graphen.
Muster 1 — Pipeline (einfach seriell)
[trigger] → [filter] → [transform] → [action]
| Merkmal | Nachricht durchläuft Nodes in Reihenfolge | | Anwendungsbeispiel | Schwellenwertüberschreitungsalarm → E-Mail-Versand |
Muster 2 — Fan-out (1 zu N)
                     ┌─→ [action 1]
[trigger] → [t] ─────┼─→ [action 2]
                     └─→ [action 3]
| Merkmal | Mehrere Aktionen verarbeiten eine Nachricht gleichzeitig | | Anwendungsbeispiel | Bei Alarmauftreten → E-Mail + SMS + Slack + Arbeitsauftragserstellung |
Kopien derselben Nachricht werden an mehrere Nodes verteilt. Jeder Zweig wird unabhängig verarbeitet, ein Fehlschlag eines Zweigs hat keine Auswirkung auf andere.
Muster 3 — Fan-in (N zu 1) — Merge
[trigger A] ──┐
[trigger B] ──┼─→ [flow_merge] → [aggregator] → [action]
[trigger C] ──┘
| Merkmal | Nachrichten mehrerer Trigger innerhalb eines Zeitfensters gesammelt einmalig verarbeiten | | Anwendungsbeispiel | Alle innerhalb von 5 Minuten aufgetretenen Alarme zu einem Tagesbericht zusammenfassen |
Muster 4 — Scatter-Gather (verteilen → sammeln)
[trigger] → [split] ─┬─→ [process] ──┐
                     ├─→ [process] ──┼─→ [merge] → [action]
                     └─→ [process] ──┘
| Merkmal | Array elementweise aufteilen, verarbeiten und Ergebnisse wieder zusammenführen | | Anwendungsbeispiel | 100 externe Bestellungen parallel validieren und Ergebnisse gesammelt melden |
Muster 5 — Switch (Bedingungsverzweigung)
                            ┌─[CRITICAL]→ [긴급 알람]
[trigger] → [flow_switch] ──┼─[WARN]    → [경고 알람]
                            └─[NORMAL]  → [통과]
| Merkmal | Eine Nachricht je nach Bedingung auf unterschiedlichen Pfaden | | Anwendungsbeispiel | Trennung des Verarbeitungskanals nach Alarmpriorität |
Muster 6 — Retry with Fallback
[risky] ─[FAILURE]─→ [flow_retry] ─[SUCCESS]─→ (다시 risky)
                                  └[EXHAUSTED]→ [fallback action]
| Merkmal | Vorübergehende Störungen automatisch erneut versuchen, dauerhafte Störungen alternativ behandeln | | Anwendungsbeispiel | Bei externem API-Fehlschlag 3-maliger Retry, bei weiterhin fehlgeschlagen Benachrichtigung an Menschen |
Muster 7 — Circuit Breaker (Nutzung der Circuit-Sperrung)
[trigger] → [throttle] → [external_io] ─[SUCCESS]─→ [save]
                                       └[FAILURE]─→ [log only]
| Merkmal | Begrenzung der Aufrufgeschwindigkeit mit flow_throttle + pauschale Sperrung mittels Circuit Breaker |
| Anwendungsbeispiel | Schutz vor Überlastung des externen Systems |
Muster 8 — Dead Letter Queue (DLQ)
[main flow] ─[FAILURE]─→ [flow_save_attributes] → 별도 자산에 적재
                                                  ↑
                              운영자가 주기적 점검 후 수동 재처리
| Merkmal | Dauerhaft fehlgeschlagene Nachrichten in separaten Speicher | | Anwendungsbeispiel | Sammlung fehlgeschlagener Nachrichten der externen ERP-Synchronisation (für manuelle Nachbearbeitung) |
Muster 9 — Sliding Window Aggregation
[trigger] → [flow_throttle 60s] → [transform: 누적] → [action]
                                  (마지막 60건만 유지)
| Merkmal | Entscheidungsfindung anhand des Zustands innerhalb eines Fensters der letzten N Einträge | | Anwendungsbeispiel | Bei über 30 Alarmen in den letzten 5 Minuten Standort in den Notfallmodus versetzen |
Muster 10 — Saga (mehrstufige Transaktion)
[start] → [step1] ─OK→ [step2] ─OK→ [step3] ─OK→ [complete]
              │            │            │
              └─FAIL→[rollback1]        │
                           │            │
                           ┌─FAIL→[rollback1+2]
                                        │
                                        └─FAIL→[rollback1+2+3]
| Merkmal | Teilfehlschläge von Vorgängen über mehrere externe Systeme durch Kompensation behandeln | | Anwendungsbeispiel | Erstellung eines Arbeitsauftrags → Anlagenreservierung → ERP-Synchronisation → Benachrichtigung des Mitarbeiters (bei Fehlschlag einer Stufe werden alle vorherigen Stufen rückgängig gemacht) |
Leitfaden zur Musterauswahl
| Anforderung | Empfohlenes Muster |
|---|---|
| Einfacher Schwellenwertalarm | Pipeline (1) |
| Ein Ereignis → mehrere Kanäle | Fan-out (2) |
| Mehrere Ereignisse → eine Zusammenfassung | Fan-in / Merge (3) |
| Massenverarbeitung von Arrays | Scatter-Gather (4) |
| Verzweigungsverarbeitung | Switch (5) |
| Zuverlässigkeit externer API | Retry (6) |
| Schutz externer Systeme | Circuit (7) |
| Aufbewahrung fehlgeschlagener Nachrichten | DLQ (8) |
| Entscheidungsfindung anhand kumulierter letzter N Einträge | Sliding (9) |
| Konsistenz über mehrere externe Systeme | Saga (10) |
Best Practices für Flow-Tests
Teststrategie zur sicheren Änderung·Bereitstellung von Flows.
3-stufiger Test — Einheit → Integration → Simulation
| Stufe | Werkzeug | Prüfgegenstand |
|---|---|---|
| ① Einheit | Bearbeitungsbildschirm ▶ Testlauf | Eigenständiges Verhalten eines einzelnen Nodes (Skriptausdruck, Antwort externer Aufrufe) |
| ② Integration | derselbe Bildschirm, temporäre Payload + Live-Debug ON | Gesamtsequenz·Verzweigung des Graphen |
| ③ Simulation | Bereitstellung + Warten auf realen Trigger (Staging-Umgebung) | Realer Nachrichtenfluss·Verbindung mit externen Systemen |
Bibliothek von Testlauf-Payloads
Trigger-spezifische Payload-Beispiele, die Sie in den Testlauf-Dialog einfügen können, finden Sie im Abschnitt Payload-Beispiele nach Trigger. Erstellen Sie auch vorab Grenzfälle, die im Betrieb häufig vorkommen.
Beispiele für Grenzfälle
| Fall | Payload |
|---|---|
| null-Feld | {"value": null} — ob das Skript null-sicher ist |
| Leerer String | {"value": ""} — Prüfung, ob ein leerer String als 0 interpretiert wird |
| Negativ | {"value": -1} — ob die Schwellenwertprüfung ±-Vorzeichen wie beabsichtigt behandelt |
| Riesige Zahl | {"value": 1e20} — Überlauf/Genauigkeit |
| Unicode | {"name": "한글-Émoji-🚀"} — Kodierung des externen Systems |
Sicheres Änderungsverfahren
1. 기존 플로우를 [내보내기] (JSON 파일 저장)
2. 새 플로우를 사본으로 만듦 (이름 끝에 `_v2`)
3. 사본의 트리거 패턴을 좁혀 일부 자산만 매칭 (예: TEST-* 사이트만)
4. 신구 동시 배포 — 새 버전 데이터 확인
5. 1주일 안정성 검증 후 신 버전을 전체 트리거 패턴으로 변경
6. 구 버전 해제 + 보관
Aufbewahrung von Regressionstestszenarien
Es wird empfohlen, häufig verwendete Szenarien als Textdatei aufzubewahren und nach jeder Änderung erneut auszuführen.
# regression-tests/alarm-to-workorder.json
{
  "case": "고온 알람 → 워크오더 자동 생성",
  "input": {
    "type": "TAG_ALARM",
    "data": { "alarm_band": "HI_HI", "value": 95.0 }, ...
  },
  "expected": {
    "domain_changes": ["WorkOrder.CREATED"],
    "notifications": ["email:admin@example.com"]
  }
}
Muster für die Simulation (Mock) externer Systeme
Um in der Staging-Umgebung Antworten externer Systeme zu simulieren:
| Methode | Beschreibung |
|---|---|
| url von flow_http_request auf Mock-Server | Produktions-URL von der Staging-URL-Variable getrennt |
| Datasource von flow_jdbc_poll ändern | Nur von Produktions-DB auf Staging-DB ändern |
| to_field von flow_send_email auf fake@example.com | Vermeidung versehentlichen Versands |
Lasttest nach Zählerreset
- Zählerreset (alles) der neuen Flow-Version
- 5 Minuten normale Trigger-Auslösung durchführen
- Verarbeitungs-/Fehlerzähler, durchschnittliche Verarbeitungszeit im Listenbildschirm prüfen
- Steigt die p95-Verarbeitungszeit gegenüber dem bisherigen Wert um mehr als 20 %, Ursachenanalyse und Rollback-Prüfung durchführen
Leistungsgrenzen und Tuning
Verarbeitungsgrenzen und Tuning-Tipps der Flow-Engine.
Standardgrenzen
| Element | Standardwert | Anmerkung |
|---|---|---|
Anzahl der Node-Besuche pro Nachricht (max_depth) | 100 | Erzwungene Beendigung, wenn nach 100 durchlaufenen Nodes nicht beendet |
Anzahl der Wiederbesuche desselben Nodes (max_revisit) | 3 | Vermeidung von Zyklus-Endlosschleifen |
Flow-Verarbeitungszeit (flow_timeout_ms) | 30.000 ms | Erzwungene Beendigung bei Überschreiten von 30 Sekunden pro Nachricht |
| Timeout externer IO-Nodes | 5.000 ms (timeout_ms) | HTTP/Kafka/MQTT usw. |
| Skript-Ausführungstimeout | 500 ms (timeout_ms) | pro Node |
| Aufbewahrung der Ausführungshistorie | 7 Tage | danach automatisch abgelaufen |
Empfohlene, häufig verwendete Fenstergrößen
| Node | Empfohlenes Fenster | Anmerkung |
|---|---|---|
flow_throttle | 1.000–60.000 ms | An das Limit der externen System-API anpassen |
flow_debounce | 500–5.000 ms | Nur bei Wunsch, ausschließlich stabile Werte durchzulassen |
flow_merge | 5.000–60.000 ms | Zu kurz führt zu Fragmentierung, zu lang erhöht die Latenz |
flow_retry-Backoff | Start 1.000 ms × 2-fach | Bei 5 Versuchen 1·2·4·8·16 Sekunden |
Möglichkeiten zur Erhöhung des Durchsatzes
- Trigger-Vorabfilter — mit
*_patternnur benötigte Nachrichten einlassen (am wirksamsten) - Vereinfachung des Graphen durch Subflow — Hauptgraph nur für Verzweigung·Routing, schwere Verarbeitung in Subflow
- Externe IO asynchron verdrahten — Externe API-Last mit
flow_delay/flow_throttleglätten - Debug-Modus nur während der Verifizierungsphase — nach Betriebsstabilisierung Debug-Modus AUS
- Nur benötigte Kategorien verdrahten — schwere Nodes wie Edge·externe Anbindung nicht unbedingt in jeder Verzweigung verdrahten
Nachrichtengröße
data / metadata der Nachricht werden JSON-serialisiert und in der Ausführungshistorie geladen. Extrahieren Sie bei riesigen Payloads (mehrere MB Response-Body usw.) möglichst mit einem Transformationsnode nur die benötigten Schlüssel. Sowohl bei der Aufbewahrung der Historie, der Debug-Anzeige als auch beim Subflow-Aufruf ist der Verarbeitungsaufwand proportional zur Nachrichtengröße.
Audit·Historien-Tracking
Orte, die Sie zur Verfolgung der Änderungs-/Ausführungshistorie eines Flows prüfen sollten.
Historie der Graph-Änderungen
- Automatischer Snapshot — wird bei jedem Graph-Speichern versionsweise geladen. Um auf einen vorherigen Zustand zurückzusetzen, wenden Sie sich an den Administrator.
- Änderer/Änderungszeitpunkt — die Spalte Letzte Änderung im Listenbildschirm zeigt den jüngsten Speicherzeitpunkt. Der Änderer wird auf Basis des systemauthentifizierten Benutzers erfasst.
- Empfohlene Erfassung des Änderungsgrunds — im Feld Beschreibung der Flow-Metadaten gemeinsam Änderungsgrund·Verantwortlichen·zugehörige Ticketnummer zu erfassen, erhöht die Nachvollziehbarkeit.
Verfolgung von Ausführungsereignissen
- Verfolgung per Nachrichten-ID — mit dem Filter Nachrichten-ID im Ausführungshistorie-Bildschirm können Sie den gesamten Ablauf (
FLOW_START→ alleNODE_IN/NODE_OUT→FLOW_END) einer einzelnen Nachricht chronologisch abrufen. - CSV-Export — mit der Schaltfläche CSV herunterladen im Ausführungshistorie-Bildschirm können Sie das aktuelle Abfrageergebnis exportieren und an ein externes Audit-System weiterleiten.
Historie der Domänenänderungen
Domänenänderungen, die von den Aktionsnodes (flow_create_* / flow_update_* / flow_delete_*) des Flows durchgeführt werden, werden alle an denselben Domänenservice delegiert und daher auch in der domänenbezogenen Änderungshistorie des Backoffice-Bildschirms erfasst. Die Bearbeiter-ID wird beispielsweise als insert_user_id="flow" gekennzeichnet, um sie von Änderungen durch normale Benutzer zu unterscheiden.
Langzeitaufbewahrung durch externe Speicherung
Falls eine Langzeitaufbewahrung über die Aufbewahrungsdauer der Ausführungshistorie (7 Tage) hinaus benötigt wird, erstellen Sie einen separaten Flow, um Kernereignisse in ein externes System (Kafka·externe DB usw.) zu laden.
[flow_on_tag_alarm]
   │
   ▼
[flow_kafka_publish: topic=audit.alarm.events]
Checkliste für die Bereitstellung neuer Flows
Zu prüfende Punkte vor der Bereitstellung eines neuen Flows in der Produktionsumgebung.
Graphstruktur
- Ist genau ein Trigger-Node (oder bewusst mehrere) verdrahtet
- Ist der
FAILURE-Ausgang aller Aktionsnodes behandelt (mindestensflow_log) - Falls ein Zyklus vorliegt, ist er beabsichtigt verdrahtet (z. B.
flow_retry) und befindet er sich innerhalb des Schutzesmax_revisit - Sind
retry_count/retry_delay_msoderflow_retrybei externen IO-Nodes verdrahtet
Node-Konfiguration
- Ist der
*_patterndes Triggers nicht zu eng oder zu weit - Existiert der Pfad der dynamischen Option
*_fieldtatsächlich in der Nachricht - Sind alle NOT-NULL-Felder des Create-Nodes befüllt (außer automatischer Ergänzung)
- Ist die Teilaktualisierung beim Update-Node tatsächlich beabsichtigt
Verifizierung·Test
- Mit normaler Payload einmal SUCCESS-Zweig durchlaufen
- Mit abnormaler Payload (fehlendes Pflichtfeld usw.) FAILURE-Zweig durchlaufen
- Mit externem IO-Fehlschlagfall Retry → EXHAUSTED-Zweig durchlaufen (falls zutreffend)
- Stimmt die INFO/ERROR-Anzeige im Live-Debug-Panel mit der Absicht überein
- Werden alle Schritte im Bildschirm
/flow/logaufgezeichnet
Betriebssicherheit
- Ist ein Backup (Graph-JSON-Export) extern aufbewahrt
- Sind Änderungsgrund·Verantwortlicher in der Flow-Beschreibung erfasst
- Wurden Empfänger bei vorhandener Benachrichtigungsverdrahtung (Email/SMS/Push) verifiziert
- Gibt es einen Plan zur Überwachung der Ausführungshistorie für 5–10 Minuten unmittelbar nach der Bereitstellung
Bereitstellungsstrategie — Canary / Blue-Green / A·B-Test
3 Strategien zur sicheren Einführung eines neuen Flows. Alle Strategien lassen sich ausschließlich mit den Basisfunktionen der Plattform (Trigger-Muster·Nachrichten-Dispatch·Live-Debug) implementieren.
Strategie 1 — Canary (schrittweise Anwendung nur auf einige Anlagen)
Wenden Sie den neuen Flow zunächst nur auf einige Anlagen an, beobachten Sie eine Zeit lang und weiten Sie ihn dann auf alle aus.
[1단계 출시]
  새 플로우 v2 — 트리거 패턴: asset_id LIKE 'LINE-1.%'  (1개 라인만)
  기존 플로우 v1 — 트리거 패턴: asset_id LIKE 'LINE-2.%' OR 'LINE-3.%' OR ...

[2단계 확대 (1주일 후 안정 확인)]
  v2 패턴: 'LINE-1.%' OR 'LINE-2.%'
  v1 패턴: 'LINE-3.%' OR 'LINE-4.%'

[3단계 전체 (2주 후)]
  v2 패턴: '%'   ← 모든 자산
  v1 해제·보관
Checkliste für den Canary-Fortschritt
| Zeitraum | Überwachungspunkte |
|---|---|
| Tag 1 | Fehlerquote < 1 % / durchschnittliche Verarbeitungszeit innerhalb ±20 % gegenüber bisher |
| 1 Woche | Externe Systemanbindung 100 % normal / angemessene Alarmauftrittsfrequenz |
| 2 Wochen | Kumulierte Statistik / Nutzerfeedback / Entscheidung über Ausweitung auf die nächste Linie |
Wählen Sie für die Canary-Linie eine Linie mit geringer Auswirkung selbst unter den laufenden Linien (z. B. Linien mit häufiger Wartung oder nur nächtlichem Betrieb).
Strategie 2 — Blue-Green (gleichzeitiger Betrieb alt·neu mit sofortigem Umschalten)
[Blue (현재)]                       [Green (새 버전)]
플로우 v1 — 배포됨                  플로우 v2 — 배포 + 격리된 originator
모든 트리거 처리                    metadata.test_mode=true 인 메시지만 처리

[전환 결정 시점]
   v2 트리거 패턴을 v1 과 동일하게 변경 (1초)
   v1 해제 토글 (1초)
Der Kern von Blue-Green ist der sofortige Wechsel bei gleichzeitiger Bereitstellung beider Versionen — bei Problemen wird v1 sofort wieder bereitgestellt, um zurückzurollen.
Isolierte Verdrahtung von v2
[trigger 모든 메시지]
   ↓
[flow_script_filter — metadata.test_mode === true]
   ↓ TRUE
[새 로직]
Testnachrichten werden über die API /flow/{id}/run mit explizitem metadata.test_mode=true gesendet.
Strategie 3 — A/B-Test (Leistungs-/Ergebnisvergleich)
Zwei Versionen empfangen dieselbe Nachricht und führen jeweils unterschiedliche Aktionen aus, deren Ergebnisse verglichen werden.
[trigger 메시지]
   ↓
[flow_split (메시지 복제)]
   ├ A 경로 → 기존 v1 액션 → [flow_save_attributes target=stats_v1]
   └ B 경로 → 새 v2 액션  → [flow_save_attributes target=stats_v2]
Anschließend im Tagesstatistik-Bildschirm stats_v1 vs stats_v2 die kumulierten Ergebnisse vergleichen.
Automatische Analyse des A/B-Vergleichs
-- EQL 으로 두 버전 비교 (예: 알람 생성 누적)
context EVERY_1_HOURS
SELECT
  count(CASE WHEN metadata.flow_version='v1' THEN 1 END) AS v1_count,
  count(CASE WHEN metadata.flow_version='v2' THEN 1 END) AS v2_count
FROM AssetAlarm.win:time(1 hour)
Leitfaden zur Strategieauswahl
| Situation | Empfohlene Strategie |
|---|---|
| Erste Einführung eines neuen Automatisierungsszenarios | Canary — auf einer Linie verifizieren, dann ausweiten |
| Große Änderung an bestehender Logik (Strukturumbau) | Blue-Green — sofortiges Rollback möglich |
| Messen, welcher von zwei Algorithmen besser ist | A/B-Test |
| Einfache Anpassung eines Optionswerts | Direkte Änderung — nach metadata.audit_diff-Notiz 1 Woche überwachen |
Rollback-Verfahren (gemeinsam)
Bei Problemauftreten sofort zurückrollen:
- Im Listenbildschirm die neue Version über den Aufheben-Schalter deaktivieren
- (Bei Canary/A·B) das Trigger-Muster auf 0 Übereinstimmungen ändern
- 5 Minuten überwachen, ob die bestehende Version allein normal funktioniert
- Diagnoseprotokoll auf
code=FLOW_NOT_DEPLOYEDprüfen - Ursachenanalyse — im Ausführungshistorie fehlgeschlagene Nachrichten über
trace_idverfolgen
Vor-Release-Checkliste (Kurzfassung)
Das Wesentliche der Checkliste für die Bereitstellung neuer Flows auf einer Ansicht:
[ ] 테스트 실행으로 정상·경계·실패 시나리오 모두 통과
[ ] 외부 IO 노드에 timeout_ms / 재시도 정책 설정됨
[ ] 자격 증명은 ${creds.*} 참조 (평문 미포함)
[ ] 트리거 패턴이 의도한 자산만 매칭
[ ] 영향받는 도메인 (자산/태그/주문) 식별됨
[ ] 운영 시간(특히 야간) 영향 검토됨
[ ] 롤백 시점·기준·담당자 결정됨
[ ] [감사 로그](#audithistorien-tracking) 에 변경 의도 메모 작성됨
Schnelle Node-Konfigurationsreferenz
Cheat-Sheet mit den wichtigsten Konfigurationen häufig verwendeter Nodes im Betrieb.
Trigger-Schnellkonfiguration
| Node | Kernoption |
|---|---|
flow_schedule | cron (z. B. 0 */5 * * * ? = alle 5 Minuten), oder interval_ms |
flow_on_webhook | keine Option — Auslösung von außen über POST /webhook/flow/{flow_id} |
flow_on_mqtt_subscribe | broker_url, topic, client_id, username/password |
flow_jdbc_poll | dsn, sql, interval_ms |
flow_on_* (Domain) | *_pattern (Glob — z. B. MOTOR-*, SITE-?) |
Transformation-Schnellkonfiguration
| Node | Kernoption |
|---|---|
flow_script_transform | language (JS/EQL), script, timeout_ms (Standard 500) |
flow_change_originator | entity_type, id_field |
flow_rename_keys | mapping (z. B. {"old":"new"}) |
flow_template | template (${data.x} / ${metadata.y} Substitution) |
flow_split | path (Array-Position, Standard data) |
flow_to_email | subject_template, body_template |
Ablaufsteuerung-Schnellkonfiguration
| Node | Kernoption |
|---|---|
flow_delay | delay_ms |
flow_throttle | max_msgs, window_ms, (Verzweigung: SUCCESS/THROTTLED) |
flow_debounce | window_ms |
flow_merge | window_ms (kumuliert im Array data.merged) |
flow_subflow | target_flow_id |
flow_retry | max_attempts (Standard 3), backoff_ms (Standard 1000), backoff_multiplier (Standard 2.0) |
flow_log | level (INFO/WARN/ERROR), prefix |
flow_noop | (keine Option) |
Externe Anbindung-Schnellkonfiguration
| Node | Statische Option | Dynamische Option (*_field) |
|---|---|---|
flow_http_request | method, url, headers, body_template, timeout_ms, retry_count, retry_delay_ms | url_field, method_field, body_field |
flow_kafka_publish | bootstrap_servers, topic, value_template, headers | topic_field, key_field |
flow_mqtt_publish | broker_url, topic, qos | topic_field |
flow_webhook_callback | url, method, headers | url_field |
flow_send_email | to, cc, subject, body | to_field, cc_field, subject_field, body_field |
flow_send_sms | to, text | to_field, text_field |
flow_send_push | title, body | title_field, body_field |
flow_jdbc_query | dsn, sql, params_field | — |
Aktion — Integration/Speicherung-Schnellkonfiguration
| Node | Kernoption |
|---|---|
flow_save_tag_point | tag_id_field (Standard metadata.tag_id), value_field, timestamp_field |
flow_save_attributes | entity_type_field, id_field, attributes_field |
flow_dds_publish | type, originator_field, payload_field |
flow_publish_asset_event | asset_id_field, event_type_field, severity_field, details_field |
flow_publish_asset_command | asset_id_field, tag_id, cmd_key_field, payload_field |
Domain-CRUD-Schnellkonfiguration
| Node | Kernoption |
|---|---|
flow_create_* | domänenspezifische Felder + dynamische Option *_field. NOT-NULL-Felder teilweise automatisch ergänzt (siehe Tabelle Domain CRUD zu den automatisch ergänzten Feldern) |
flow_update_* | Teilaktualisierung: nur eingegebene Felder werden aktualisiert, leere Werte werden ignoriert. Vollständiges Überschreiben mit Delete + Create Kombination |
flow_delete_* | *_id_field |
flow_start/end/pause/resume_work_order | order_id_field (Standard data.order_id) |
flow_abort_work_order | + abort_code_field, abort_notes_field |
flow_update_tag_alarm_band_numeric | tag_id_field, hi_field usw. (nur Eingabefelder werden aktualisiert) |
Edge-Schnellkonfiguration
Alle Edge-Nodes verwenden dieselben Optionen.
| Option | Beschreibung |
|---|---|
url | Edge-REST-Endpunkt (z. B. http://edge.local:60000/opc/server) |
method | HTTP-Methode (bei fehlender Angabe Node-spezifischer Standardwert) |
headers | JSON-Header (Authentifizierungstoken usw.) |
body_template | Request-Body (bei fehlender Angabe wird data unverändert gesendet) |
timeout_ms | 5000 |
Flow REST API — Flow programmatisch steuern
REST-API zur Verwaltung von Flows als Code über externe Automatisierungstools (Ansible/GitOps/CI-Pipeline), oder wenn ein externes System einen Flow sofort ausführen soll.
Authentifizierung
Alle API-Aufrufe werden mit einem Token authentifiziert, das unter Sicherheit → API-Authentifizierungstoken ausgestellt wurde, als Header angehängt.
Authorization: Bearer {api_token}
Liste der Endpunkte
1) Flow-Liste abrufen
GET /flow/list
curl -H "Authorization: Bearer ${TOKEN}" \
     https://platform.example.com/flow/list
Antwort:
{
  "data": [
    { "flow_id": "flow-abc123", "flow_name": "MES 동기화", "deployed": true,
      "node_count": 12, "exec_count": 9430, "error_count": 2, "last_exec_at": 1746247200000 },
    ...
  ]
}
2) Einzelnen Flow abrufen
GET /flow/get/{flow_id}
Der Response-Body enthält alle Graph-Nodes·Relationen·Optionen. Direkt für Backup/Versionsverwaltung verwendbar.
3) Flow erstellen
POST /flow/create
Content-Type: application/json

{
  "flow_name":        "신규 자동화",
  "description":     "외부 알림 → 워크오더 자동 생성",
  "deployed":         false
}
Verwenden Sie die aus der Antwort empfangene flow_id für nachfolgende Aufrufe.
4) Flow bearbeiten (Metadaten)
POST /flow/update
Content-Type: application/json

{
  "flow_id":     "flow-abc123",
  "flow_name":   "수정된 이름",
  "description": "..."
}
5) Graph speichern (Massenersetzung von Node·Relation)
POST /flow/{flow_id}/graph
Content-Type: application/json

{
  "nodes":     [ { "node_id": "n1", "type": "flow_on_tag_point", "options": {...}, "x": 100, "y": 100 }, ... ],
  "relations": [ { "from_node_id": "n1", "to_node_id": "n2", "relation": "TRUE" }, ... ]
}
Das Speichern des Graphen ist eine Transaktion — bei Validierungsfehlern wird der gesamte Graph zurückgerollt.
6) Bereitstellen / Aufheben
Wenn Sie das Feld deployed der Flow-Metadaten ändern, wird automatisch bereitgestellt·aufgehoben.
# 배포
curl -X POST -H "Authorization: Bearer ${TOKEN}" -H "Content-Type: application/json" \
     -d '{"flow_id":"flow-abc123","deployed":true}' \
     https://platform.example.com/flow/update
7) Sofortige Ausführung (manueller Trigger)
POST /flow/{flow_id}/run
Content-Type: application/json

{
  "type":       "WEBHOOK",
  "originator": { "entity_type": "External", "id": "manual-run" },
  "data":       { "test": true }
}
Wird sofort ab dem ersten Node ausgeführt, ohne den Vorabfilter des Trigger-Nodes zu durchlaufen. Nützlich für manuelle Verifizierung·Debugging.
8) Dispatch (Auslösung unter Umgehung des Triggers)
POST /flow/dispatch
Content-Type: application/json

{
  "type":       "POST_TELEMETRY",
  "originator": { "entity_type": "Tag", "id": "MOTOR-001.SPEED" },
  "data":       { "value": 1500 },
  "metadata":   { "tag_id": "MOTOR-001.SPEED", "ts": 1746247200000 }
}
Die Nachricht wird über den normalen Trigger-Verarbeitungspfad eingespeist — alle Flows, die auf diese Nachricht passen, werden gleichzeitig ausgelöst.
9) Statistik zurücksetzen
POST /flow/{flow_id}/stats/reset-errors        — 에러 카운트만 초기화
POST /flow/{flow_id}/stats/reset-all           — 전체 카운트 초기화
10) Export / Import — Graph-Backup
# Export — JSON 파일로 다운로드
curl -H "Authorization: Bearer ${TOKEN}" \
     https://platform.example.com/flow/${FLOW_ID}/export \
     -o flow-backup.json

# Import — 같은 JSON 을 다른 환경에 등록
curl -X POST -H "Authorization: Bearer ${TOKEN}" -H "Content-Type: application/json" \
     --data @flow-backup.json \
     https://platform.example.com/flow/import
Bei Import mit kollidierender ID wird automatisch eine neue ID ausgestellt. Externe Abhängigkeiten (Anmeldedaten·Anlagen-ID usw.) müssen nach dem Import separat zugeordnet werden.
11) Alle Flows neu bereitstellen
POST /flow/redeploy
Wird nach großflächigen Änderungen oder nach Node-Neustart zur Massensynchronisation verwendet. Gehen Sie mit Aufrufen im Betrieb vorsichtig um — es kann zu vorübergehenden Verarbeitungsverzögerungen kommen.
12) Selbstdiagnose
POST /flow/selftest
Prüft einmal die internen Komponenten der Flow-Engine (Trigger-Warteschlange·Dispatcher·Node-Registry·Skript-Laufzeit) und gibt den Status zurück. Das Ergebnis wird auch im Diagnoseprotokoll erfasst.
13) Node-Katalog abrufen
GET /flow/catalog
Gibt alle aktuell registrierten Node-Typen·Optionsschemata zurück. Wird von der UI zur dynamischen Erstellung des Inspektors verwendet. Auch als Referenz für externe Tools bei der automatischen Graph-Erstellung.
Auslösung von außen über Webhook-Trigger
Flows, die den flow_on_webhook-Trigger enthalten, können über folgende URL direkt von einem externen System ausgelöst werden.
POST /webhook/flow/{flow_id}
Authorization: Bearer {token}    또는    X-API-Key: {token}
Content-Type:  application/json

{
  "order_no":  "PO-001",
  "customer":  "ACME",
  "quantity":  1000
}
Antwort:
{ "status": "ACCEPTED", "trace_id": "tr-..." }
| Antwortcode | Bedeutung |
|---|---|
| 200 | In Nachrichtenwarteschlange eingereiht (tatsächliches Verarbeitungsergebnis asynchron) |
| 401 | Authentifizierungstoken falsch/fehlend |
| 404 | Flow-ID nicht vorhanden oder nicht bereitgestellt |
| 413 | Body überschreitet 256 KB |
| 422 | Trigger-Node ist nicht flow_on_webhook |
| 429 | Aufrufbegrenzung pro Minute überschritten |
Beispiele für die Anbindung externer Automatisierungstools
GitHub Actions — Flow-Bereitstellung bei PR-Merge
- name: 플로우 배포
  run: |
    curl -X POST \
      -H "Authorization: Bearer ${{ secrets.PP_TOKEN }}" \
      -H "Content-Type: application/json" \
      --data @flows/mes-sync.json \
      https://platform.example.com/flow/import
Ansible — Batch-Verwaltung von Flows
- name: 모든 플로우 백업
  uri:
    url: "https://platform.example.com/flow/{{ item }}/export"
    headers:
      Authorization: "Bearer {{ pp_token }}"
    dest: "/backups/{{ item }}.json"
  loop: "{{ pp_flow_ids }}"
Jenkins — Selftest bei jedem neuen Build
stage('PlantPulse Flow Selftest') {
  steps {
    sh """
      curl -X POST -H 'Authorization: Bearer ${PP_TOKEN}' \\
           https://platform.example.com/flow/selftest \\
           --fail-with-body
    """
  }
}
API Rate Limit
| Endpunkt | Limit pro Minute (pro Token) |
|---|---|
GET /flow/list · get · catalog | 600 |
POST /flow/create · update · delete | 60 |
POST /flow/{id}/run · dispatch · webhook/{id} | 1.000 |
POST /flow/redeploy · selftest | 10 |
Bei Überschreitung des Limits Antwort 429 Too Many Requests.
OPC/PLC-Industrieintegrationsmuster
Sammlung von industriespezifischen Integrationsszenarien. Kombinierte Nutzung der 22 Edge-Nodes und der 4 Nodes zur Anlagen-Ereignis-Veröffentlichung.
Muster A — Automatische OPC-Server-Registrierung
Beim Anlauf einer neuen Linie automatische Registrierung eines OPC-Servers am Edge mit von ERP empfangenen Linieninformationen.
[flow_on_webhook]
   ↓ (data = {"line_id":"LINE-7","host":"10.0.7.10","port":4840})
[flow_change_originator]
   ↓ (originator → Edge:EDGE-A)
[flow_edge_opc_create]
   ↓ (path=/api/v1/opc, body={"opc_id":"OPC-${data.line_id}","host":"${data.host}","port":${data.port}})
[flow_edge_opc_start]
   ↓ (수집 시작 명령)
[flow_save_attributes]
   ↓ (등록 이력을 자산 메타에 기록)
Der Edge-Node führt automatisch ein Lookup von
api_keyin der Master-Tabellemm_edgedurch. Der Operator muss keine separate Authentifizierungskonfiguration vornehmen.
Muster B — Automatische Ausgabe von PLC-Befehlen
Bei Auftreten eines Anlagenalarms wird automatisch ein Stoppbefehl an die PLC ausgegeben.
[flow_on_asset_alarm]
   ↓ where priority='ERROR' AND alarm_band='TRIP_HI'
[flow_publish_asset_command]
   ↓ (event_type='STOP', payload={"reason":"trip_high","triggered_by":"flow"})
[flow_log] (감사 로그)
flow_publish_asset_commandwird sofort an das Befehlstopic der Anlage (asset/{id}/cmd/STOP) übermittelt, und der Edge führt den OPC-Write an die PLC aus.
Muster C — Massenregistrierung von OPC-Tags (CSV/Excel-Eingang)
Bei der Einrichtung neuer Anlagen werden 100–1000 Tags aus einer CSV auf einmal registriert.
[flow_jdbc_poll]            ← 외부 DB 에 적재된 CSV 행
   ↓ (한 행 = 한 메시지)
[flow_script_transform]     ← 태그 정의 가공
   ↓
[flow_create_tag]           ← 도메인 등록 (NOT NULL 자동 보강)
   ↓
[flow_edge_tag_create]      ← 엣지에 동기화
   ↓
[flow_log] (성공 카운트)
Bei Registrierung von 1.000 Tags wird empfohlen, mit
flow_throttleauf höchstens 100 pro Minute zu glätten. Der Edge kann vorübergehend langsamer antworten.
Muster D — Automatische Wiederherstellung bei OPC-Verbindungsabbruch
Automatischer Neustart, wenn die OPC-Verbindung abgebrochen war und sich wieder erholt.
[flow_on_opc_status]
   ↓ where prev_status='CONNECTED' AND status='DISCONNECTED'
[flow_delay 30s]            ← 잠시 안정화 대기
   ↓
[flow_edge_opc_start]       ← 수집 재시작 시도
   ↓ SUCCESS: 정상
   └ FAILURE: [flow_retry max=3] → EXHAUSTED: [관리자 알림]
Muster E — Linienstatusprüfung bei Schichtbeginn
Prüft alle Linien eines Standorts zu Beginn jeder Schicht.
[flow_schedule cron='0 0 7,15,23 * * ?']   ← 7시·15시·23시
   ↓
[flow_edge_monitoring]      ← 엣지에서 OPC 상태 전체 조회
   ↓ data.opcs = [...]
[flow_split]                ← 배열을 행별 메시지로
   ↓
[flow_script_filter]        ← status != 'CONNECTED' 만
   ↓
[flow_send_email]           ← 비정상 OPC 만 한 통의 메일에 합쳐 발송
Muster F — Automatische Mitarbeiterzuordnung bei Schichtwechsel
Automatische Zuordnung des Mitarbeiters zum Arbeitsauftrag entsprechend der Änderung des Dienstplans.
[flow_on_entity_event type='ENTITY_UPDATED' Calendar]
   ↓
[flow_script_filter (시프트 시작 시각이 지금인 경우만)]
   ↓
[flow_jdbc_query (그 시프트의 작업자 목록 조회)]
   ↓ data.employees=[...]
[flow_split]
   ↓
[flow_update_work_order (작업자 매핑)]
Muster G — Gleichzeitiger Aufruf mehrerer PLCs (Scatter-Gather)
Gleichzeitiger Aufruf von Daten mehrerer PLCs und anschließende Konsolidierung der Ergebnisse.
[flow_on_webhook]
   ↓ data.targets=['PLC-1','PLC-2','PLC-3']
[flow_split]
   ↓ (3개로 분할)
[flow_edge_tag_read]
   ↓ (병렬 호출)
[flow_merge window=5s]
   ↓ data.merged=[...]
[flow_script_transform (data.summary 만들기)]
   ↓
[flow_publish_asset_aggregation]
Muster H — Automatische Anpassung des Alarmbands
Automatische Anwendung der aus der Vorhersageanalyse gelernten LIMIT_MIN/MAX-Werte auf das Alarmband.
[flow_schedule cron='0 0 4 * * MON']    ← 매주 월요일 4시
   ↓
[flow_jdbc_query (forecast 결과 조회)]
   ↓ data.tags=[{tag_id, limit_min, limit_max}]
[flow_split]
   ↓
[flow_update_tag_alarm_band_numeric]    ← lo=limit_min, hi=limit_max
   ↓ SUCCESS
[flow_log] (적용 결과 기록)
Muster I — Automatische Klassifizierung von Downtime
Klassifizierung von Anlagenstoppereignissen nach Ursache, um sie präzise in der OEE-Verfügbarkeit zu berücksichtigen.
[flow_on_asset_event event_type='SHUTDOWN']
   ↓
[flow_switch]
   ├ CASE 점심: hour_of_day(ts) BETWEEN 12 AND 13 → [flow_create_calendar (계획정지)]
   ├ CASE 시프트 종료: 시프트 종료 시각 ±5분    → [flow_log (정상 종료)]
   ├ CASE 정기점검: 마지막 정비일 +30일 경과     → [flow_create_calendar (정기점검)]
   └ DEFAULT (비계획)                            → [flow_send_email (긴급)]
Muster J — Bidirektionale Synchronisation von Arbeitsaufträgen mit externem ERP
Bidirektionale Spiegelung PlantPulse ↔ externes ERP.
입력 1: ERP → 플랜트펄스
[flow_on_webhook] → [flow_create_work_order]

입력 2: 플랜트펄스 → ERP
[flow_on_entity_event type='ENTITY_CREATED' WorkOrder]
  → [flow_script_filter (출처가 ERP 가 아닌 경우만)]
  → [flow_http_request (ERP REST PUT)]
Um eine Endlosschleife zu vermeiden, markieren Sie von außen eingehende Nachrichten mit
metadata.source='ERP'und filtern Sie diese Nachricht im Flow der entgegengesetzten Richtung heraus.
Vorsichtsmaßnahmen bei der Industrieintegration
| Punkt | Empfehlung |
|---|---|
| OPC-Write-Befehl erst nach Sicherheitsverriegelung veröffentlichen | Erst nach Bedienerbestätigung oder Durchlauf der automatischen Sicherheitsregel |
| PLC-Pollingintervall nicht zu kurz einstellen | Unter 1 Sekunde Risiko einer starken CPU-Auslastung der PLC |
| Ressourcenlimit der Docker-Container des Edge-Geräts | Bei OPC-Erfassung + zusätzlichem Container Vorsicht bei CPU/Speicher über 80 % |
| In der Inbetriebnahmephase alle Befehle im Dry-Run-Modus | Nutzung der dry_run=true-Option von flow_edge_tag_write |
| Vorsorge für Stromausfall — nur persistenten Speicher-Trigger vertrauen | flow_on_webhook usw. sind flüchtig, Domain-Ereignis-Trigger sind persistent |
Cookbook für externe Systemintegration
Sammlung von flow_http_request-Konfigurationen und Payload-Beispielen für häufig aufgerufene externe Systeme.
Slack — Incoming-Webhook-Benachrichtigung
URL:    https://hooks.slack.com/services/T0000/B0000/{secret}
Method: POST
Headers:
  Content-Type: application/json
Body (body_template):
  {
    "text": "${data.title}",
    "blocks": [
      { "type": "header",  "text": { "type": "plain_text", "text": "${data.title}" } },
      { "type": "section", "text": { "type": "mrkdwn",     "text": "*자산:* ${metadata.asset_id}\n*값:* ${data.value}\n*시각:* ${metadata.ts}" } }
    ]
  }
- Erfolg: 200 + Body
ok - Fehlschlag: 400 (fehlerhafte Payload) / 404 (falsches Secret) / 429 (Aufrufbegrenzung pro Minute überschritten)
- Empfehlung:
flow_throttlemit max. 1× pro Minute verdrahten
Microsoft Teams — Webhook-Benachrichtigung
URL:    https://{org}.webhook.office.com/webhookb2/{id}/IncomingWebhook/{secret}
Method: POST
Headers:
  Content-Type: application/json
Body:
  {
    "@type":    "MessageCard",
    "@context": "https://schema.org/extensions",
    "themeColor": "FF0000",
    "title": "${data.title}",
    "sections": [{
      "facts": [
        { "name": "자산", "value": "${metadata.asset_id}" },
        { "name": "값",   "value": "${data.value}"       },
        { "name": "시각", "value": "${metadata.ts}"      }
      ]
    }]
  }
Verzweigen Sie
themeColornachFF0000(Rot)/FFA500(Orange)/00C853(Grün), um die Priorität zu visualisieren.
Jira — Automatische Erstellung eines Issues
URL:    https://{org}.atlassian.net/rest/api/3/issue
Method: POST
Headers:
  Authorization: Basic {base64(email:apitoken)}
  Content-Type:  application/json
Body:
  {
    "fields": {
      "project":    { "key": "OPS" },
      "summary":    "[자동] ${data.title}",
      "description": {
        "type": "doc",
        "version": 1,
        "content": [{
          "type": "paragraph",
          "content": [{ "type": "text", "text": "자산: ${metadata.asset_id}\n값: ${data.value}" }]
        }]
      },
      "issuetype":  { "name": "Bug" },
      "priority":   { "name": "High" }
    }
  }
- Der Response-Body
data.response_body.keyenthält einen Issue-Key wieOPS-1234, den Sie in Folgenodes verwenden können - Fehlschlag: 400 (falsches Feld) / 401 (Authentifizierung) / 403 (keine Projektberechtigung)
GitHub Issues — Automatische Erstellung eines Issues
URL:    https://api.github.com/repos/{owner}/{repo}/issues
Method: POST
Headers:
  Authorization: Bearer {pat_token}
  Accept:        application/vnd.github+json
Body:
  {
    "title":  "[자동] ${data.title}",
    "body":   "자산: ${metadata.asset_id}\n값: ${data.value}\n시각: ${metadata.ts}\ntrace: ${metadata.trace_id}",
    "labels": ["automation", "ops"]
  }
ERP (SAP S/4HANA OData) — Ausstellung eines Arbeitsauftrags
URL:    https://{host}/sap/opu/odata/sap/API_MAINTNOTIFICATION/MaintenanceNotification
Method: POST
Headers:
  Authorization:   Basic {base64(user:pass)}
  X-CSRF-Token:    fetch          ← 별도 GET 으로 토큰 받기
  Content-Type:    application/json
Body:
  {
    "NotificationType":         "M2",
    "MaintenanceNotificationType": "M2",
    "TechnicalObject":          "${metadata.asset_id}",
    "NotificationText":         "${data.title}",
    "MalfunctionStartDate":     "${data.start_date}",
    "Priority":                 "${data.priority}"
  }
Sie müssen zunächst per GET den CSRF-Token abrufen und dann mit demselben Sitzungscookie ein POST senden. Verbinden Sie zwei
flow_http_request-Nodes und leiten Sie den Token aus dem Response-Header des ersten Nodes an den Header des zweiten Nodes weiter.
MES (direktes INSERT in externe DB) — flow_jdbc_query
Direktes Einfügen einer Zeile in die Arbeitsauftragstabelle eines externen MES-Systems.
INSERT INTO mes.work_order
  (order_no, asset_id, product_id, qty, status, due_date, created_by)
VALUES
  (:order_no, :asset_id, :product_id, :qty, 'NEW', :due_date, 'flow')
| Node-Option | Wert |
|---|---|
datasource_id | mes_db (vorab in der Systemeinstellung registriert) |
query | obiges SQL |
binds | {"order_no":"${data.order_no}","asset_id":"${metadata.asset_id}",...} |
flow_jdbc_queryunterstützt neben SELECT auch INSERT/UPDATE/DELETE. Die Transaktion wird pro Node automatisch committed/zurückgerollt.
Grafana — Benachrichtigung bei automatischer Aktualisierung des Dashboards
URL:    https://{host}/api/annotations
Method: POST
Headers:
  Authorization: Bearer {api_key}
  Content-Type:  application/json
Body:
  {
    "dashboardUID": "...",
    "panelId":      4,
    "time":         ${metadata.ts},
    "tags":         ["alarm", "${metadata.asset_id}"],
    "text":         "${data.title}"
  }
Bei Alarmauftreten wird auf dem Graphen automatisch ein Marker angezeigt — sehr nützlich für die nachträgliche Analyse.
Telegram — Bot-Nachricht
URL:    https://api.telegram.org/bot{token}/sendMessage
Method: POST
Body:
  {
    "chat_id": "-1001234567890",
    "text":    "🚨 *${data.title}*\n자산: `${metadata.asset_id}`\n값: ${data.value}",
    "parse_mode": "Markdown"
  }
Schnellübersicht REST-Authentifizierungsmuster
| Authentifizierungsmethode | Header |
|---|---|
| API Key (Header) | X-API-Key: {token} |
| API Key (Query) | am Ende der URL ?api_key={token} |
| Bearer Token | Authorization: Bearer {token} |
| Basic Auth | Authorization: Basic {base64(user:pass)} |
| OAuth2 (Client Credentials) | Token-Ausstellung → Bearer-Header (Erneuerung über separaten Node) |
| HMAC-Signatur | body-/zeitbasierte Signatur per Skript berechnen und im X-Signature-Header |
Muster zur Antwortparsierung
Verwenden Sie nach der flow_http_request-Antwort data.response_body im nächsten Node:
// 응답에서 ID 추출
data.created_id = data.response_body.id;
data.status     = data.response_body.status;

// 응답 배열에서 첫 행만
data.first_item = (data.response_body.items || [])[0] || null;

// 응답이 문자열이면 JSON 파싱
if (typeof data.response_body === 'string') {
  try { data.response_body = JSON.parse(data.response_body); } catch (e) {}
}
msg
Sicherheitsempfehlungen beim Aufruf externer Systeme
| Punkt | Empfehlung |
|---|---|
| Token nicht im Klartext im Graphen belassen | Nach Registrierung im Speicher für Anmeldedaten der Systemeinstellung wie ${creds.slack_webhook} referenzieren |
| Bei sensiblen Informationen im Response-Body maskieren | Mit flow_script_transform PII/Token entfernen und dann an den nächsten Node |
| Separate Retry-Richtlinie je externes System | Wo die Aufrufhäufigkeit hoch ist, separat flow_retry + flow_throttle verdrahten |
| Aufrufergebnis als Audit-Log speichern | Mit flow_save_attributes Aufruf-Historienmetadaten zur Anlage hinzufügen |
Cookbook für Datentransformation
Sammlung von Transformationsmustern, die Sie unverändert in den Node flow_script_transform übernehmen können. Alle Beispiele basieren auf JavaScript und verwenden die Kurzaliase data / metadata.
Einheitenumwandlung
// 섭씨 → 화씨
data.temp_f = data.temp_c * 9 / 5 + 32;

// 바 → kPa
data.pressure_kpa = data.pressure_bar * 100;

// rpm → rad/s
data.angular_velocity = data.rpm * 2 * Math.PI / 60;

// kWh → MJ
data.energy_mj = data.energy_kwh * 3.6;

// 바이트 → MB (소수 1자리)
data.size_mb = Math.round(data.bytes / 1024 / 1024 * 10) / 10;

msg
Datums-/Zeitumwandlung
const d = new Date(metadata.ts);

// ISO 8601 — 2026-05-12T12:34:56.789Z
data.iso = d.toISOString();

// 사람용 — 2026-05-12 21:34:56 (KST)
data.local = d.toLocaleString('ko-KR', { hour12: false });

// 날짜만 — 2026-05-12
data.date = d.toISOString().slice(0, 10);

// 시간만 — 21:34:56
data.time = d.toTimeString().slice(0, 8);

// 분 단위로 내림 (스파크라인 키)
data.minute_key = Math.floor(metadata.ts / 60000) * 60000;

// 시간 단위로 내림
data.hour_key = Math.floor(metadata.ts / 3600000) * 3600000;

// 한국 시간 (UTC+9) 직접 더하기 (서버 시간이 UTC 인 경우)
data.kst_hour = new Date(metadata.ts + 9 * 3600000).getUTCHours();

msg
Stringnormalisierung
// 공백 trim + 소문자화
data.normalized = (data.text || '').trim().toLowerCase();

// 한글·영문 외 제거 (특수문자/공백 정리)
data.clean = (data.text || '').replace(/[^가-힣a-zA-Z0-9]/g, '');

// camelCase → snake_case
data.snake = (data.text || '').replace(/([A-Z])/g, '_$1').toLowerCase().replace(/^_/, '');

// 전화번호 정규화 (숫자만)
data.phone_digits = (data.phone || '').replace(/\D/g, '');

// 한국 휴대전화 자동 포맷 (010-1234-5678)
const p = (data.phone || '').replace(/\D/g, '');
data.phone_formatted = p.length === 11 ? p.replace(/(\d{3})(\d{4})(\d{4})/, '$1-$2-$3') : p;

msg
Abflachen verschachtelter Objekte
// data.location.address.city → data.city
function flatten(obj, prefix, out) {
  out = out || {};
  for (var k in obj) {
    var v = obj[k];
    var key = prefix ? prefix + '_' + k : k;
    if (v && typeof v === 'object' && !Array.isArray(v)) flatten(v, key, out);
    else out[key] = v;
  }
  return out;
}
data = flatten(data);
msg
Flaches Objekt → verschachtelt
// data.user_name + data.user_email → data.user = {...}
function unflatten(obj) {
  var out = {};
  for (var k in obj) {
    var parts = k.split('_');
    var cur = out;
    for (var i = 0; i < parts.length - 1; i++) {
      cur[parts[i]] = cur[parts[i]] || {};
      cur = cur[parts[i]];
    }
    cur[parts[parts.length - 1]] = obj[k];
  }
  return out;
}
data = unflatten(data);
msg
CSV-Zeilenerstellung
// 외부 시스템에 CSV 한 줄 보낼 때
function csvEscape(v) {
  if (v === null || v === undefined) return '';
  v = String(v);
  return /[,"\n]/.test(v) ? '"' + v.replace(/"/g, '""') + '"' : v;
}
data.csv_row = [
  csvEscape(metadata.ts),
  csvEscape(metadata.asset_id),
  csvEscape(data.value),
  csvEscape(data.quality)
].join(',');
msg
Array-Aggregation
var arr = data.values || [];

// 합·평균·최소·최대
data.sum = arr.reduce(function(a, b) { return a + b; }, 0);
data.avg = arr.length ? data.sum / arr.length : 0;
data.min = arr.length ? Math.min.apply(null, arr) : null;
data.max = arr.length ? Math.max.apply(null, arr) : null;

// 중앙값
var sorted = arr.slice().sort(function(a, b) { return a - b; });
var mid    = Math.floor(sorted.length / 2);
data.median = sorted.length === 0 ? null
            : sorted.length % 2 ? sorted[mid]
            : (sorted[mid - 1] + sorted[mid]) / 2;

msg
Bedingtes Hinzufügen von Feldern (Schema-Evolution)
// 알람 우선순위에 따라 색상·아이콘 자동 부여
var p = data.priority || 'INFO';
data.color   = { ERROR: '#d32f2f', WARN: '#f57c00', INFO: '#1976d2' }[p] || '#9e9e9e';
data.icon    = { ERROR: '🔴',       WARN: '🟠',       INFO: '🔵' }[p] || '⚪';
data.urgency = p === 'ERROR' ? 3 : p === 'WARN' ? 2 : 1;
msg
Maskierung eines Teils der Payload
function maskEmail(e) {
  if (!e || e.indexOf('@') < 0) return e;
  var parts = e.split('@');
  return parts[0].slice(0, 2) + '***@' + parts[1];
}
function maskPhone(p) {
  return (p || '').replace(/(\d{3})\d{4}(\d{4})/, '$1-****-$2');
}
data.user_email = maskEmail(data.user_email);
data.user_phone = maskPhone(data.user_phone);
msg
Mehrsprachige (i18n) Vorlage
// 메시지 본문을 사용자 로케일에 따라 분기
const tpl = {
  'ko-KR': '🚨 ${asset} 온도 ${value}°C 임계 초과',
  'en-US': '🚨 ${asset} temperature ${value}°C exceeds threshold',
  'ja-JP': '🚨 ${asset} 温度 ${value}°C 閾値超過'
};
const locale = metadata.user_locale || 'ko-KR';
const template = tpl[locale] || tpl['ko-KR'];
data.notification = template
  .replace('${asset}', metadata.asset_id)
  .replace('${value}', data.value);
msg
Sichere JSON-Path-Abfrage
// data.deep.nested.field 처럼 깊은 경로를 안전하게 조회
function get(obj, path, dflt) {
  var keys = path.split('.');
  var cur  = obj;
  for (var i = 0; i < keys.length; i++) {
    if (cur === null || cur === undefined) return dflt;
    cur = cur[keys[i]];
  }
  return cur === undefined ? dflt : cur;
}
data.city = get(data, 'location.address.city', 'Unknown');
msg
Nachrichtenzusammenführung (flow_merge-Nachbearbeitung)
// flow_merge 가 data.merged 배열로 모은 메시지들을 1건으로 합침
var items = data.merged || [];
data.summary = {
  count:     items.length,
  first_ts:  items[0]?.metadata?.ts,
  last_ts:   items[items.length - 1]?.metadata?.ts,
  assets:    Array.from(new Set(items.map(function(m) { return m.metadata?.asset_id; }))),
  max_value: Math.max.apply(null, items.map(function(m) { return m.data?.value || 0 }))
};
delete data.merged;
msg
Sammlung wiederverwendbarer Skripte
Skriptbibliothek, die Sie unverändert in die Nodes flow_script_filter / flow_script_transform / flow_switch übernehmen können. Alle Skripte basieren auf JavaScript und verwenden die Kurzaliase data / metadata.
Transformationsskripte
Einheitenumwandlung·Etikettierung
// 섭씨 → 화씨 + 등급 라벨
data.temp_f = data.temp * 1.8 + 32;
data.grade  = data.temp > 80 ? 'HIGH' : data.temp < 0 ? 'LOW' : 'OK';
msg
Ergänzung von Zeit-·Schicht-·Wochentag-Metadaten
const d = new Date(metadata.ts);
const h = d.getHours();
metadata.shift   = (h >= 6 && h < 14) ? 'A' : (h < 22) ? 'B' : 'C';
metadata.weekday = ['SUN','MON','TUE','WED','THU','FRI','SAT'][d.getDay()];
metadata.is_weekend = (d.getDay() === 0 || d.getDay() === 6);
msg
Berechnung des Alarmbands Durchschnitt ± 3σ
const m = data.mean, s = data.stddev || 1;
data.tag_id = originator.id + '.TEMP';
data.hi     = m + 3*s;  data.lo    = m - 3*s;
data.hi_hi  = m + 4*s;  data.lo_lo = m - 4*s;
data.use_alarm = true;
msg
Zuordnung MES PO → Arbeitsauftrag
const po = data;
data = {
  master_id: 'WO-MES-' + po.po_no,
  asset_id:  po.line_id || 'UNASSIGNED',
  title:     po.product_name + ' (' + po.qty + ')',
  due_date:  po.delivery_date,
  qty:       po.qty,
  product_id: po.product_code
};
msg
Normalisierung externer Payload (Vereinheitlichung unterschiedlicher Feldnamen)
// 외부 시스템에 따라 키 이름이 다른 경우 — 한 줄로 정규화
data.value     = data.value ?? data.val ?? data.v;
data.timestamp = data.timestamp ?? data.ts ?? metadata.ts;
data.tag_id    = data.tag_id ?? data.tagId ?? data.id;
msg
Kumulierung der Anzahl von Schwellenwertverletzungen (Stateful-Muster)
// 자산 attribute 와 함께 사용 — 상태는 메시지 자체에 적재
data.consecutive_fail = (data.consecutive_fail ?? 0) + (data.passed ? 0 : 1);
data.alert            = data.consecutive_fail >= 5;
msg
Zusammenfassung von Nachrichtenstatistiken (Aufbereitung des Merge-Ergebnisses)
// flow_merge 후 data.merged 배열을 받아 요약
const arr = data.merged || [];
data.count   = arr.length;
data.values  = arr.map(m => m.data.value).filter(v => v != null);
data.mean    = data.values.reduce((a,b)=>a+b, 0) / (data.values.length || 1);
data.max     = Math.max(...data.values);
data.min     = Math.min(...data.values);
delete data.merged;
msg
Anwendung zeitzonenabhängiger Schwellenwerte
const h = new Date(metadata.ts).getHours();
const threshold = (h >= 8 && h < 18) ? 90 : 70;   // 주간 90, 야간 70
data.alarm = data.value > threshold;
data.threshold = threshold;
msg
Filterskripte
Prioritäts-Whitelist
['ERROR', 'CRITICAL'].includes(data.priority)
Zeitfenster (nur werktags)
const h = new Date(metadata.ts).getHours();
h >= 8 && h < 20
Muster von Anlagen-·Tag-ID
/^MOTOR-.*$/.test(originator.id)
// 또는
metadata.tag_id && metadata.tag_id.startsWith('LINE-A.')
Schwellenwert + Stabilität (N-mal in Folge)
data.value > 100 && (data.consecutive_count ?? 0) >= 5
Prüfung von Geschäftszeiten·Feiertagen
const d = new Date(metadata.ts);
const h = d.getHours();
const wd = d.getDay();
// 평일 09-18시만 통과
wd >= 1 && wd <= 5 && h >= 9 && h < 18
Nur bestimmter Standort
['SITE-01', 'SITE-02'].includes(metadata.site_id)
Prüfung, ob alle Pflichtfelder existieren
data.value != null && data.tag_id && metadata.ts
Blockierung selbst veröffentlichter Nachrichten (bidirektionale Synchronisation)
metadata.source !== 'flow'
Switch-Case-Skripte
Nach Prioritätsstufe
// case "Critical"
['CRITICAL', 'EMERGENCY'].includes(data.priority)

// case "High"
data.priority === 'ERROR'

// case "Normal"
['WARN', 'INFO'].includes(data.priority)
Nach Anlagenstatus
// case "Running"
data.status === 'RUN'

// case "Stopped"
['STOP', 'IDLE', 'PAUSED'].includes(data.status)

// case "Faulted"
data.status === 'FAULT' || data.error_count > 0
Nach Arbeitsauftrags-Lebenszyklus
// case "Start"
data.event_type === 'START_REQUEST'

// case "End"
data.event_type === 'COMPLETE' && data.qty_done >= data.qty_planned

// case "Abort"
data.event_type === 'CANCEL'
Die oben genannten Skripte fassen im Betrieb häufig verwendete Muster zusammen. Sie funktionieren auch, wenn sie direkt im Graphen verdrahtet werden; passen Sie lediglich Schwellenwerte·Feldnamen an Ihre Domäne an.
Glossar
Fachbegriffe der Flow-Engine
| Begriff | Bedeutung |
|---|---|
| entity_type | Art der Subjekt-Entität der Nachricht — z. B. Asset, Tag, Site, Order, Customer, Product, Employee, Calendar |
| originator | Subjekt-Entität, auf die sich die Nachricht bezieht (entity_type + id). Beispiel: Asset/MOTOR-001 |
| type | Klassifizierungslabel der Nachricht. Identifiziert, welche Art von Ereignis der Trigger empfangen hat |
| data | Inhalt (Payload) der Nachricht — wird hauptsächlich von Transformations-·Aktionsnodes gelesen und geschrieben |
| metadata | Kontext der Nachricht (Zeit·Standort·Schicht·Tag-ID usw.) — bleibt auch nach Transformation bis zum Ende des Ablaufs erhalten |
| relation | Label des Ausgangs-Wires eines Nodes. SUCCESS/FAILURE/TRUE/FALSE/MATCH/NO_MATCH/DEFAULT/THROTTLED/EXHAUSTED (alle Großbuchstaben) |
*_field dynamische Option | Eingabeart, die statt eines statischen Werts einen Wert aus einem Pfad der Nachrichten-Payload liest (z. B. data.tag_id) |
| Glob-Muster | Wildcard-Ausdruck der Trigger-Option *_pattern — * passt auf 0 oder mehr Zeichen, ? passt auf genau 1 Zeichen |
| Snapshot | Beim Graph-Speichern automatisch angelegtes versionsweises Backup. Wird bei Vorfällen zum Zurücksetzen auf einen vorherigen Zustand verwendet |
| Teilaktualisierung (fetch+merge) | Methode, bei der der Update-Node nach Abfrage des bestehenden Datensatzes nur die eingegebenen Felder zusammenführt. Leere Werte werden ignoriert |
| SKIPPED | Behandlung, bei der eine nicht mit dem Trigger-Muster übereinstimmende Nachricht nicht an Folgenodes fließt und auch aus dem Zähler ausgeschlossen wird |
| EXHAUSTED | Zweig, der ausgelöst wird, wenn der flow_retry-Node die maximale Anzahl von Wiederholungen überschreitet |
| THROTTLED | Zweig, der ausgelöst wird, wenn der flow_throttle-Node Nachrichten blockiert, die das Limit im Fenster überschreiten |
Domänen-·Abkürzungsglossar
Eine Zusammenstellung von im Anlagenbetrieb häufig verwendeten Abkürzungen zur schnellen Referenz innerhalb dieses Handbuchs.
| Abkürzung | Bedeutung | In diesem Handbuch |
|---|---|---|
| MES | Manufacturing Execution System — Verwaltung von Arbeitsauftrag·Produktionsergebnis | Ziel externer Anbindung (HTTP/MQTT/externe DB) |
| ERP | Enterprise Resource Planning — unternehmensweites Ressourcen-·Planungssystem | Ziel externer Anbindung |
| SCADA | Supervisory Control and Data Acquisition — Überwachung·Steuerung | Ziel externer Anbindung / Ausgang von flow_publish_asset_command |
| OPC | Open Platform Communications — Industriekommunikationsstandard | Ziel der Edge-Kategorie (flow_edge_opc_*) |
| OEE | Overall Equipment Effectiveness — Verfügbarkeit × Leistung × Qualität | flow_on_oee_event-Trigger |
| RAM | Reliability·Availability·Maintainability | flow_on_ram_event-Trigger |
| EMS | Energy Management System | flow_on_ems_event-Trigger |
| EQL | Domain-Ereignisregelausdruck | language: "EQL"-Option von flow_script_filter/flow_script_transform |
| CEP | Complex Event Processing | EQL-basierte Regel-Engine. Alarme müssen ausschließlich über den CEP-Pfad entstehen, um Konsistenz zu gewähren |
| PO | Purchase Order — Bestell-·Produktionsauftrag | Einheit, die bei der MES-Anbindung in einen Arbeitsauftrag umgewandelt wird |
| WO | Work Order (Arbeitsauftrag) | flow_*_work_order-Node-Gruppe |
| CMMS | Computerized Maintenance Management System | Ziel externer Anbindung |
| MTTF/MTTR | Mean Time To Failure / To Repair | Kernkennzahl von RAM-Ereignissen |
| HMI | Human–Machine Interface | Bedienbildschirm von SCADA usw. |
Versionshinweise
Einführungszeitpunkte der wichtigsten Funktionsgruppen, die dieses Handbuch derzeit behandelt. Wenn Sie eine ältere Version betreiben, kann sich manches Verhalten unterscheiden.
V2026.05 — Erweiterung der Domänen-Automatisierung
- 11 Edge-Kategorien (Edge) neu eingeführt — Automatisierung von OPC-Server/Tag-CRUD + Monitoring
- 5 Zustandsübergänge des Arbeitsauftrags —
flow_start/end/pause/resume/abort_work_order - 2 Teilaktualisierungen des Tag-Alarmbands — Aktualisierung nur eingegebener Felder von numerischem/booleschem Alarmband
- Neuer
flow_retryAblaufsteuerungs-Node — Backoff + maximale Versuche + EXHAUSTED-Zweig - 5 neue Trigger —
flow_on_asset_health_status/_connection_status/_oee_event/_ram_event/_ems_event - Teilaktualisierung des Update-Nodes (fetch+merge) — Zusammenführung nur der eingegebenen Felder nach Abfrage des bestehenden Datensatzes
- Großbuchstaben-Standardisierung der Relations —
SUCCESS/FAILURE/... alle in Großbuchstaben, bestehende Graphen werden automatisch konvertiert - SKIPPED-Behandlung — Ausschluss von nicht mit dem Trigger-Muster übereinstimmenden Nachrichten aus dem Zähler
- Betriebswerkzeug „Alle neu bereitstellen (redeploy)“ — Massen-Neuladen aktiver Flows
- Alle Zähler zurücksetzen — Massenreset der Statistik auf Node- und Flow-Ebene
V2026.03 — Release-Stabilität
- Automatischer Snapshot beim Graph-Speichern
- Live-Debug-Panel (Aktualisierung alle 2 Sekunden unter dem Inspektor) + Node-Leuchtanzeige·Duration-Anzeige
- Import/Export (Graph-JSON-Datei)
- Einführung des Last-Watchdogs — Ausgabe eines Diagnoseprotokolls bei anhaltender Last
Davor
- M1 — Engine-·UI-Grundgerüst, Graph-CRUD, visuelle Canvas
- M2 — Domain-Aktionsnodes (Anlage·Tag·Arbeitsauftrag·Produktionsdomäne usw.)
- M3 — Diversifizierung der Trigger, 8 Arten von Filter/Transformation/Externer Anbindung, Skript-Engine
- M4 — Debug-Laden·Ausführungshistorie-Bildschirm, Statistik, Bereitstellen/Aufheben, Import/Export
- M5 — Integration der Domain-Trigger, Massenverifizierung von Szenarien
Alle in diesem Handbuch behandelten Funktionen und Verhalten basieren auf dem oben genannten Zeitpunkt V2026.05.
Verwandte Bildschirme
- CEP (Complex Event Processing): EQL-basierte Domain-Ereignisregel-Engine
- Alarm: Alarmauftreten·Historie
- Datenpunkt: Abfrage·Analyse von Tag-Daten
- Entwicklerhandbuch: Flow-Engine: Engine-Architektur·Node-Schnittstelle·DB-Schema