Dashboard (Plattform-Zusammenfassung / Site-Map)
Inhaltsverzeichnis
- Übersicht
- Bildschirmaufbau
- Oberer Seitenheader
- Globale Site-Map
- Datenpipeline-Karte
- Zusammenfassung Site-Dimensionen und Verbindungsstatus
- Rechte Health-Rail
- Plattform-Kernmetriken
- Untere Betriebs-Widgets
- Wichtige Drill-Downs
- Maßnahmen nach Anomaliesignal
- Häufig gestellte Fragen
- Verwandte Bildschirme
Übersicht
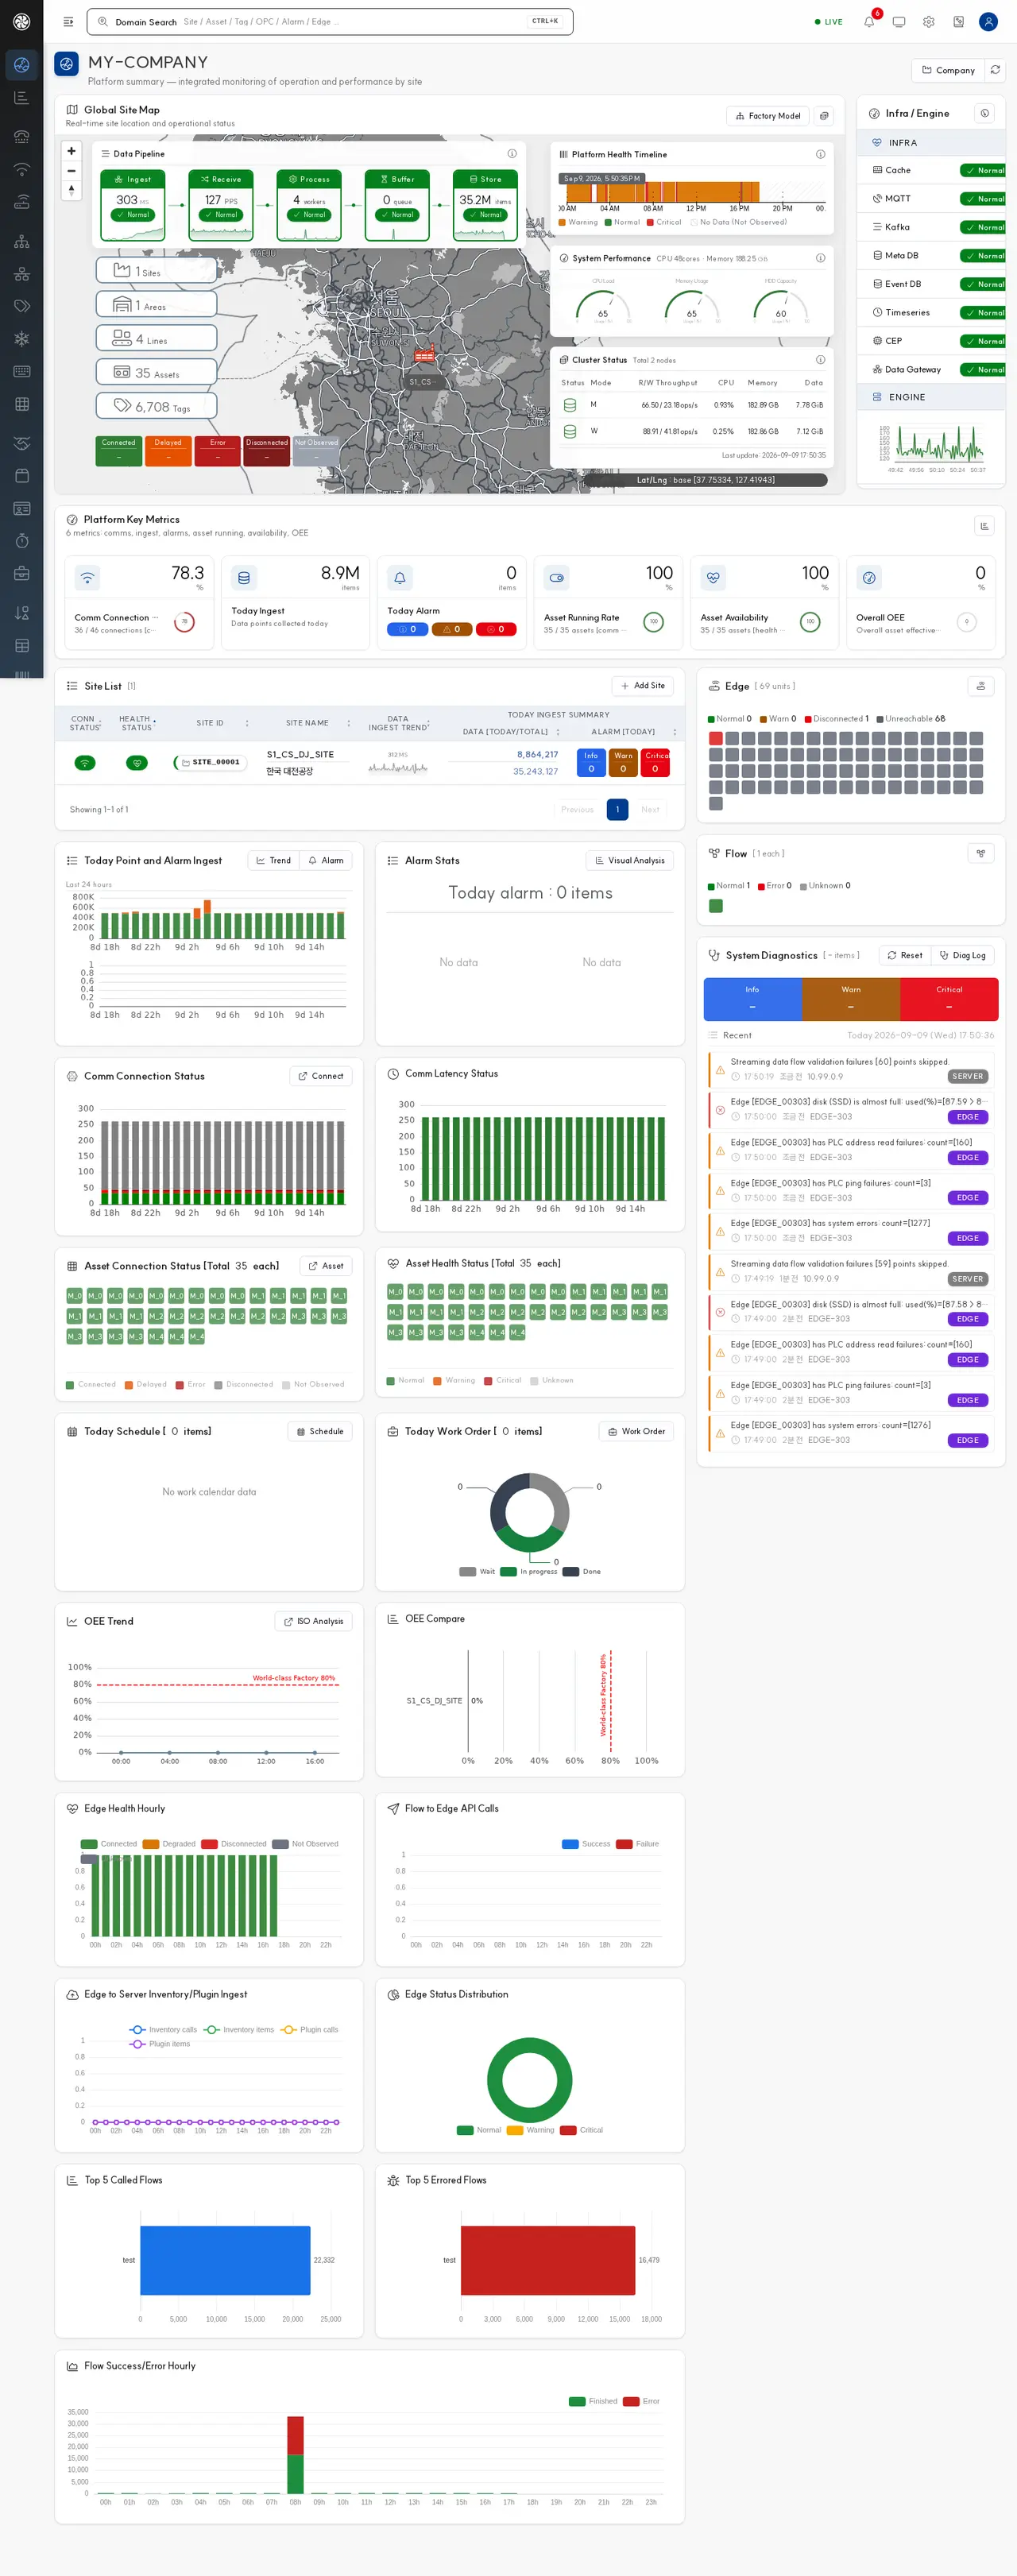
Das Dashboard ist der erste Betriebsbildschirm, den Sie nach dem Login sehen. Im linken Menü wird es als OVERVIEW > Dashboard angezeigt; die interne URL ist /map/index.
Dieser Bildschirm fasst die Site-Map, die Datenpipeline, die Infrastruktur-Health, den Cluster-Status und die wichtigsten KPIs in einer Ansicht zusammen, damit der Betreiber folgende Fragen schnell beantworten kann:
- In welcher Site oder Linie ist ein Anomaliesignal aufgetreten?
- Gibt es Blockaden in der Pipeline für Erfassung, Empfang, Verarbeitung oder Speicherung?
- Funktionieren Cache, WS, MQTT, Kafka, Event-DB und die Zeitreihen-Engine ordnungsgemäß?
- Liegen das heutige Erfassungsvolumen, die Alarme, die Anlagenauslastung und die OEE im normalen Bereich?
Der erste Bildschirm, der in älteren Dokumenten als „Zusammenfassung“ bezeichnet wurde, wurde in der aktuellen UI als Dashboard vereinheitlicht. Die URL bleibt wie bisher
/map/index.
Bildschirmaufbau
┌────────────────────────────────────────────────────────────────────┐
│ 상단 바: 메뉴 토글 / 도메인 검색 / LIVE / 알람 / 전체화면 / 설정 / 매뉴얼 / 사용자 │
├────────────────────────────────────────────────────────────────────┤
│ 한국핵심산업                                                        │
│ 플랫폼 요약 - 사이트별 운영·성능 통합 모니터링                       │
├──────────────────────────────────────────────────────────┬─────────┤
│ 글로벌 사이트 맵                                         │ 우측     │
│  ┌ 데이터 파이프라인: 수집 → 수신 → 처리 → 버퍼 → 저장 ┐  │ 헬스     │
│  │ 사이트 마커 / 지도 확대·축소 / 좌표 표시              │  │ 레일     │
│  │ 사이트·구역·라인·설비·태그 카운트                    │  │         │
│  │ 연결 상태 칩: 정상·지연·이상·끊김·안됨                │  │         │
│  └────────────────────────────────────────────────────┘  │         │
├────────────────────────────────────────────────────────────────────┤
│ 플랫폼 핵심 지표: 통신 연결률 / 금일 수집 / 금일 알람 / 가동률 / 가용률 / OEE │
├────────────────────────────────────────────────────────────────────┤
│ 하단 위젯: 사이트 목록 / 포인트·알람 / OPC / 설비 / 생산 / 엣지 / 플로우 / 진단 │
└────────────────────────────────────────────────────────────────────┘
| Bereich | Inhalt |
|---|---|
| Oberer Seitenheader | Firmenname, Schaltfläche [Firmenkonfiguration], Beschreibung „Plattform-Zusammenfassung - Integriertes Überwachungsportal für Betrieb und Leistung pro Site“ |
| Globale Site-Map | Site-Standorte, Marker-Status, Kartensteuerung, Koordinatenanzeige |
| Datenpipeline | Durchsatz und Status der Phasen Erfassung, Empfang, Verarbeitung, Puffer und Speicherung |
| Site-Dimensions-Zusammenfassung | Anzahl der Sites, Bereiche, Linien, Anlagen und Tags |
| Verbindungsstatus-Zusammenfassung | Anzahl der Status: Normale Verbindung, Verbindungsverzögerung, Verbindungsanomalie, Verbindungsabbruch, Nicht verbunden |
| Rechte Health-Rail | Plattform-Health-Timeline, Systemleistung, Cluster-Status, Infrastruktur/Engine-Status |
| Kern-KPIs | Kommunikationsverbindungsrate, Heutige Erfassung, Heutige Alarme, Anlagenauslastung, Anlagenverfügbarkeit, Gesamt-OEE |
| Untere Betriebs-Widgets | Site-Liste, Point- und Alarmtrends, OPC/Anlagenstatus, Produktionspläne/Work-Order, Edge/Flow/Diagnose |
Oberer Seitenheader
Am oberen Rand des Hauptinhalts wird der Firmenname groß angezeigt. Das Unternehmen bildet die oberste Ebene der Anlagenhierarchie und ist einzigartig pro Installation.
| Element | Beschreibung |
|---|---|
| Firmenname | Beispiel: 한국핵심산업 |
| Firmenkonfiguration | Öffnet das Fenster zur Bearbeitung von Firmenname, Rechtsform, Land, Zeitzone, Logo usw. |
| Hilfstext | 플랫폼 요약 - 사이트별 운영·성능 통합 모니터링 |
| Echtzeit-Benachrichtigungen | Änderungen des Anlagenstatus, Diagnose-Events usw. werden als Toast-Benachrichtigungen oben rechts angezeigt |
Informationen zur globalen Suche und zur Nutzung von Benachrichtigungen finden Sie unter Konsolennavigation und gemeinsame Bildschirme.
Globale Site-Map
Die Karte zeigt gleichzeitig die registrierten Standorte der Sites und deren Betriebsstatus. Site-Marker werden als Fabriksymbole dargestellt, wobei im Marker-Label die Site-ID oder ein Kurzname angezeigt wird.
Kartensteuerung
| Aktion | Methode |
|---|---|
| Zoomen | Schaltflächen + / - links auf der Karte oder Mausrad |
| Bewegen | Ziehen der Karte |
| Site prüfen | Klick auf den Site-Marker |
| Koordinaten prüfen | Breitengrad/Längengrad-Anzeige am unteren Kartenrand |
Marker-Interpretation
| Status | Bedeutung | Nächster Schritt |
|---|---|---|
| Normal | Hauptverbindungen und Dateneingang der Site sind normal | Nur KPIs und Erfassungsvolumen prüfen |
| Warnung | Teilweise Verbindungsverzögerung oder Anlagenwarnung | Verbindungsstatus, Alarm |
| Anomalie | Verbindungsanomalie, kritischer Alarm oder möglicher Datenabfall | Diagnose, Edge-Gateway |
| Unbestätigt | Koordinaten oder Erfassungshistorie unzureichend | Fabrikverwaltung, Datenpunkt |
Datenpipeline-Karte
Über der Karte wird der Datenfluss der Plattform in Form von Karten dargestellt.
수집 ─→ 수신 ─→ 처리 ─→ 버퍼 ─→ 저장
| Phase | Repräsentatives Maß | Normale Interpretation |
|---|---|---|
| Erfassung | Hz | Prüfen, ob der Erfassungszyklus vor Ort aktiv ist |
| Empfang | PPS | Anzahl der Datenpunkte, die der Server pro Sekunde empfängt |
| Verarbeitung | Anzahl Worker | Prüfen, ob die Pipeline-Worker ordnungsgemäß arbeiten |
| Puffer | Warteschlange | Prüfen, ob ein Stau in der Queue vorliegt |
| Speicherung | Anzahl Speicherungen | Prüfen, ob Zeitreihen- und Event-Daten akkumuliert werden |
Die kleinen Sparklines am unteren Rand jeder Karte zeigen den aktuellen Trend. Wenn die Werte auf 0 fallen oder nur der Puffer stetig ansteigt, ist von einem Engpass beim Dateneingang oder bei der Speicherung auszugehen.
Zusammenfassung Site-Dimensionen und Verbindungsstatus
Unten links auf der Karte werden die aktuelle Modelldimension und der Verbindungsstatus zusammengefasst.
Modelldimension
| Element | Bedeutung |
|---|---|
| Site | Anzahl der registrierten Fabriken oder Betriebsstätten |
| Bereich | Anzahl der betrieblichen Unterbereiche einer Site |
| Linie | Anzahl der Produktionslinien |
| Anlage | Anzahl der registrierten Anlagen |
| Tag | Anzahl der Erfassungs-, Berechnungs- und Status-Tags |
Wenn die Modelldimension von den Erwartungen abweicht, prüfen Sie den Registrierungsstatus von Sites, Assets und Tags in der Fabrikverwaltung.
Verbindungsstatus-Chips
| Chip | Bedeutung | Priorität |
|---|---|---|
| Normale Verbindung | Letzter Dateneingang normal | Referenz |
| Verbindungsverzögerung | Empfangverzögerung aufgetreten | Trend des Tages prüfen |
| Verbindungsanomalie | Kein Empfang oder Fehler über definierten Zeitraum | Sofortige Inspektion |
| Verbindungsabbruch | Langzeitiger Empfangsausfall | Vor-Ort, Edge und Netzwerk prüfen |
| Nicht verbunden | Bisher keine Empfangshistorie | Registrierungs- und Inbetriebnahmestatus prüfen |
Die genauen Statuskriterien basieren auf der Definition der Statuscodes.
Rechte Health-Rail
Die rechte Rail des Dashboards bietet eine schnelle Übersicht über den Gesundheitszustand der Plattform. Betreiber nutzen dies, um zwischen Site-Anomalien und Systemfehlern zu unterscheiden.
Plattform-Health-Timeline
| Element | Beschreibung |
|---|---|
| Aktuelle Zeit | Zeitpunkt der letzten Aggregation |
| Farben-Timeline | Status Normal, Warnung und Anomalie nach Zeitabschnitten |
| Zweck | Überprüfung, ob der Systemzustand zu einem bestimmten Zeitpunkt instabil war |
Konzentrieren sich orangefarbene oder rote Abschnitte in der Timeline, prüfen Sie die Diagnose-Logs und System-Logs desselben Zeitraums.
Systemleistung
| Anzeige | Bedeutung | Prüfkriterium |
|---|---|---|
| CPU-Last | CPU-Auslastung des Servers | Ursache prüfen, wenn über längere Zeit ≥ 80 % |
| Speichernutzung | JVM/System-Speicherauslastung | Speicherdruck prüfen bei kontinuierlichem Anstieg |
| HDD-Belegung | Auslastung des Datenspeichers | Bereinigung oder Erweiterung prüfen bei ≥ 85 % |
Cluster-Status
| Element | Bedeutung |
|---|---|
| Status | Rollen der Cluster-Nodes und deren Normalzustand |
| Modus | Betriebsmodus (z. B. Single, Master, Worker) |
| Lese-/Schreibverzögerung | Antwortverzögerung des Speichers |
| CPU / Speicher / Daten | Ressourcennutzung des Clusters |
| Letztes Update | Zeitpunkt der Cluster-Statusaggregation |
Infrastruktur- und Engine-Status
| Bereich | Elemente |
|---|---|
| Infrastruktur | Cache, WS, MQTT, Kafka, EventDB, Zeitreihe |
| Engine | Echtzeitmetriken für Erfassung, Verarbeitung, Verzögerung und Speicherung |
Wenn auch nur ein Infrastruktur-Element abnormal ist, ist es wahrscheinlicher ein plattformweites Problem als ein Problem auf Site-Ebene. Prüfen Sie zuerst System und Diagnose.
Plattform-Kernmetriken
Am unteren Rand des Dashboards werden sechs KPI-Karten angezeigt, die für Betriebsentscheidungen relevant sind.
| KPI | Bedeutung | Prüfung nach Klick |
|---|---|---|
| Kommunikationsverbindungsrate | Anzahl normale Verbindungen / Gesamtverbindungen | Verbindungsstatus |
| Heutige Erfassung | Anzahl der heute erfassten Datenpunkte | Datenpunkt, Tagesstatistik |
| Heutige Alarme | Gesamtzahl der heute aufgetretenen Alarme | Alarm |
| Anlagenauslastung | Anteil der Anlagen mit normalem Dateneingang | Anlage, Verbindungsstatus |
| Anlagenverfügbarkeit | Anteil der Anlagen mit normaler Gesundheitsdiagnose | Anlage, Diagnose |
| Gesamt-OEE | Gesamteffektivität aller Anlagen | Produktionsmanagement, ISO-Analyse |
Die KPI-Karten dienen nicht der Betrachtung eines einzelnen Wertes. Wenn ein Wert den normalen Bereich verlässt, müssen Sie über den Link der Karte zum entsprechenden Bildschirm navigieren, um die Ursache auf die Ebene von Site, Linie, Anlage oder Tag einzugrenzen.
Untere Betriebs-Widgets
Unter der Karte und den KPIs folgen Widgets, die den täglichen Betriebsfluss der gesamten Plattform (nicht nur einer ausgewählten Site) anzeigen.
| Widget | Anzeige | Navigation |
|---|---|---|
| Site-Liste | Verbindungsstatus, Gesundheitsstatus, Site-ID/Name, 24h-Datentrend, heutige Daten/Alarme | Klick auf Site-Name → Asset-Tree |
| Datenpunkte und Alarme | Trend von Punkt-Empfang und Alarmen der letzten 24h | Trend, Alarm |
| Alarmstatistik | Heutige Alarmsumme, Verteilung nach Priorität und EIN/AUS | Alarmanalyse |
| OPC-Trend | Kommunikationsverbindungsstatus, Kommunikationsverzögerungen | Verbindungsstatus |
| Anlagenstatus | Heatmap der Anlagenverbindungen, Heatmap der Anlagengesundheit | Asset, Anlage |
| Produktionsinfo | Heutiger Schichtplan, heutige Work-Order, OEE-Trend und Vergleich | Produktionsmanagement, ISO-Analyse |
| Edge | Stundenweise Edge-Health, Edge-API-Aufrufe, Edge-Push-Empfang, Edge-Statusverteilung | Edge |
| Flow | TOP 5 Aufrufe, TOP 5 Fehler, stündlicher Ausführungstrend | Flow |
| Diagnose-Sidebar | Edge-Heatmap, Flow-Gesundheits-Heatmap, Liste der Diagnose-INFO/WARN/ERROR | Diagnose, Systemlogs |
Die unteren Widgets sind nützlich, um den „Umfang“ eines Problems einzugrenzen. Wenn beispielsweise das heutige Erfassungsvolumen sinkt, können Sie in der Reihenfolge Site-Liste → OPC-Trend → Anlagen-Heatmap schnell feststellen, auf welcher Hierarchieebene der Datenfluss gestoppt ist.
Wichtige Drill-Downs
| Startpunkt | Nächster Bildschirm | Zweck |
|---|---|---|
| Kartenmarker | Fabrikverwaltung, Anlage | Überprüfung der Site-Linien-Anlagenstruktur |
| Verbindungsstatus-Chip | Verbindungsstatus | Identifikation von unterbrochenen/verzögerten Datenquellen |
| Edge-Anomalie | Edge-Gateway | Prüfung der Edge-Ressourcen und des PLC-Erfassungsstatus |
| Alarm-Toast | Alarm | Prüfung von alarmierendem Tag, Asset und Zeitpunkt |
| Diagnose-Toast | Diagnose | Ursachenverfolgung von Systemereignissen |
| Starker Erfassungsabfall | Tagesstatistik, Datenpunkt | Vergleich, bei welcher Site oder welchem Tag die Daten abgenommen haben |
| OEE-Abfall | Produktionsmanagement, ISO-Analyse | Analyse der Ursachen in Work-Order, Auslastung, Leistung oder Qualität |
Maßnahmen nach Anomaliesignal
| Symptom | Priorität Prüfung | Allgemeine Maßnahme |
|---|---|---|
| Starker Abfall der Verbindungsrate | Verbindungsstatus-Chips, Verbindungsstatus | Identifikation unterbrochener OPC/Edge, Prüfung Netzwerk und Erfassungsprozesse |
| Heutige Erfassung ist 0 oder stark gesunken | Erfassungs- und Empfangskarten der Datenpipeline | Prüfung in Reihenfolge: Edge-Erfassung → MQTT/Kafka → Speicher |
| Anstieg der Pufferwarteschlange | Pufferkarte der Pipeline, rechte Engine-Metriken | Prüfung auf Speicherverzögerung, Verzögerung bei externen Systemaufrufen, Anzahl der Worker |
| Infrastruktur-Element abnormal | Rechte Infrastruktur-Rail | Prüfung des Cache/WS/MQTT/Kafka/DB-Status unter System |
| Anstieg kritischer Alarme | Alarm-KPI, Alarm-Toast | Sortierung nach Tag, Asset und Priorität unter Alarm |
| Abfall der Anlagenverfügbarkeit | Anlagenverfügbarkeitskarte | Prüfung des Gesundheitszustands der Anlage, Diagnose-Logs, letzte Wartungshistorie |
| OEE-Abfall | Gesamt-OEE-Karte | Identifikation der sinkenden Dimension (Auslastung, Leistung, Qualität) in der ISO-Analyse |
Häufig gestellte Fragen
F: Die Zahlen im Dashboard scheinen einzufrieren. A: Prüfen Sie, ob der LIVE-Status oben grün ist. Wenn er grau ist oder die Zeit stehen bleibt, stellen Sie die Verbindung durch Aktualisieren des Browsers wieder her. Bei wiederholtem Auftreten prüfen Sie die Diagnose.
F: Die Site-Marker werden auf der Karte nicht angezeigt. A: Für die Sites müssen Breitengrad und Längengrad registriert sein. Prüfen Sie die Site-Koordinaten und den Registrierungsstatus des Modells in der Fabrikverwaltung.
F: Die Verbindungsrate ist niedrig, aber die Edge scheint normal zu sein. A: Der HTTP-Status eines Edge-Geräts und der Empfangsstatus von Tag-Daten können voneinander abweichen. Prüfen Sie im Verbindungsstatus, welche Ziele tatsächlich Verzögerungen oder Abbrüche aufweisen.
F: Alle Infrastruktur-Elemente in der rechten Health-Rail sind normal, aber eine einzelne Site ist abnormal. A: Es ist wahrscheinlicher, dass es sich um ein Problem mit dem Netzwerk, der Edge oder der OPC/PLC-Verbindung dieser Site handelt als um einen plattformweiten Fehler. Prüfen Sie zuerst den Site-Marker und den Verbindungsstatus.
F: Der Alarm-Toast ist verschwunden. Kann ich ihn wieder sehen?
A: Prüfen Sie unter Alarm den Zeitraum, indem Sie ihn auf 10M oder 30M eingrenzen. Bei Systemereignissen suchen Sie im selben Zeitraum unter Diagnose.
Verwandte Bildschirme
- Konsolennavigation und gemeinsame Bildschirme — Linkes Menü, obere Suche, gemeinsame Muster
- Tagesstatistik — Betriebliche Statistiken und Vergleichsanalyse nach Datum
- Verbindungsmanagement — Protokolle, Verbindungsstatus, Edge-Gateway
- Alarm — Echtzeitalarme und Historiensuche
- Anlagenmanagement — Anlagenliste und Anlagen-Dashboards
- Datenpunkt — Abfrage von Quelldaten pro Tag
- Diagnose — Systemdiagnose-Events
- System — Infrastruktur-Health, Logs, Konfiguration, Umgebungsinformationen
- Definition der Statuscodes — Statuscodes für Verbindung, Gesundheit, Alarm und Produktion