TimeSeries-Insight (AI 分析エンジン)
概要
PlantPulse TimeSeries-Insightは、製造時系列データに特化したAI異常検知、予測、総合分析MCPサーバーです。
IBM Granite TSPulse(異常検知)とTinyTimeMixer TTM(予測)AIモデルを活用し、センサーデータ、OEE、RAM、EMS、アラーム、作業指示など工場のすべての時系列データに対する知的な分析を提供します。
39個の分析ツールとフィーチャーストアにより、リアルタイム分析から事前計算済みの総合インサイトまでをサポートします。2026.10からは、ツールとして呼ばれるのを待たず自ら問題を見つけて«発見»として書き留め、コパイロットがそれを受け取って人に知らせます → AI発見と精度
insight-api(:8970)がツールとデータを担当し、モデル推論(TSPulse・TTM)は
insight-server(:8980)に委任します。GPUは推論側にのみ必要なので、2つのサービスを異なる
機器に置くことができます。
異常検知をコパイロットで見る場所
エンジンが見つけた設備異常は、コパイロットの提案 › やること › 突発に確認する異常として上がります。設備ごとに1行で、行を押すと 詳細でトレンド線・関連タグ・根拠を見てインシデントとして上げるまたは無視(理由)を決めます → 提案
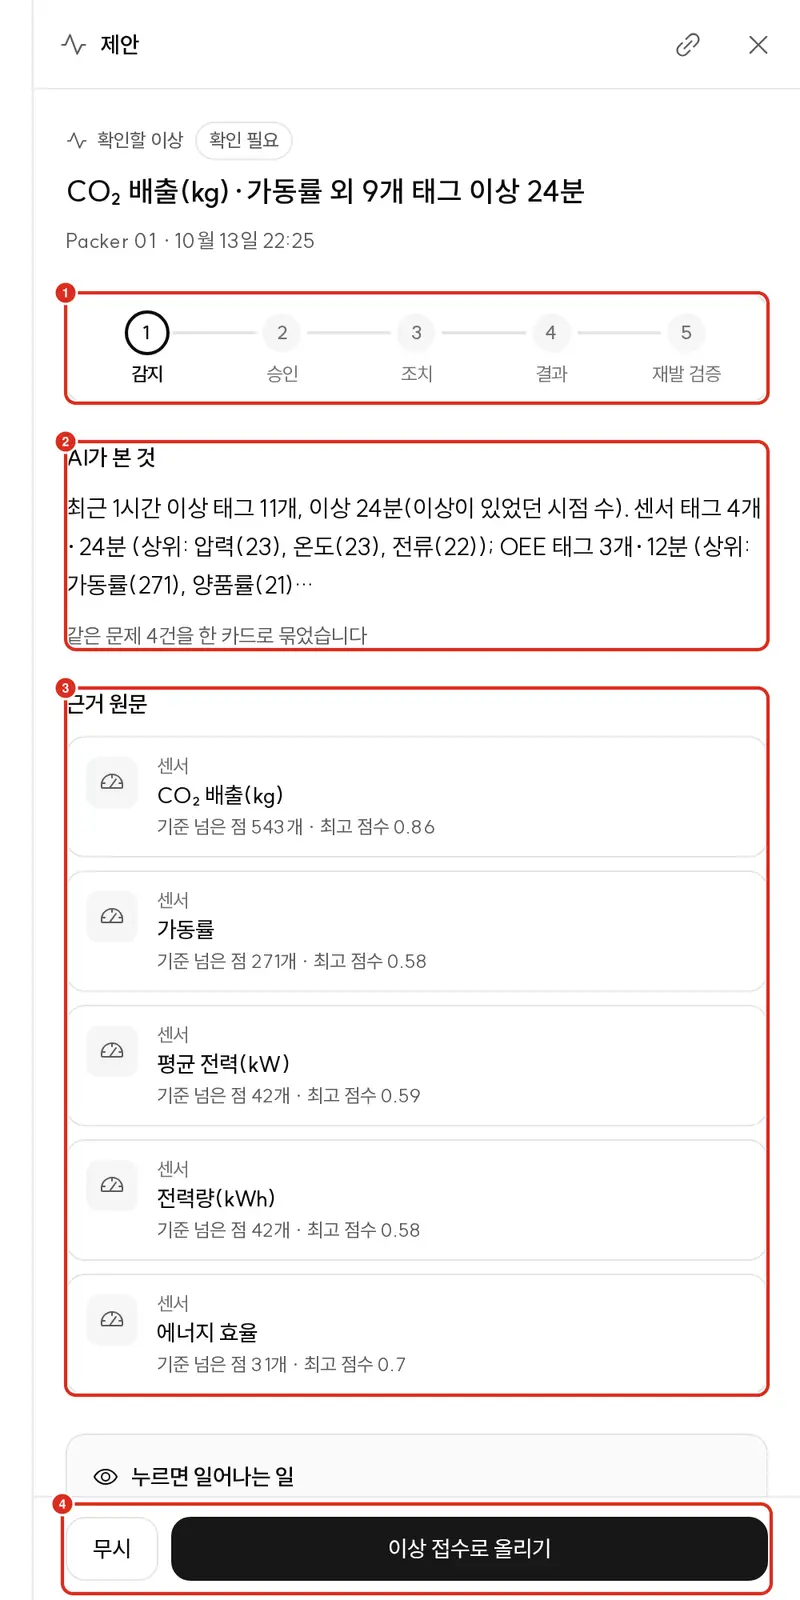
以前の«異常診断»メニューとその中の«運用コンソール»はなくなり、その役目は提案 › 突発で行います(旧アドレス /anomaly はリダイレクトされません)。
| 以前の運用コンソールでしていたこと | 今 |
|---|---|
| 異常リストをさっと見て・確認 | 提案 › やること › 突発。急ぐ順に並びます |
| 当たっていたか印をつける(AI判定) | 誤報であれば無視に理由を選びます → AI発見と精度 |
| フルスキャン・ターゲット«実行»ボタン | ボタンはありません。サーバーが周期どおりに回ります — 下記 |
| 設備タイムライン | デジタルスレッドが接続されたインストールでは「この設備の最近の出来事を時系列で見せて」と聞きます |
検知は2つの周期で回ります
| 何を測るか | いつ(デフォルト) | |
|---|---|---|
| 全体スキャン | 全設備 | 2時間ごと |
| ターゲット検知 | 最近アラームが鳴った設備のみ | 10分ごと |
周期・重要度基準・通知チャネルは異常検知・インシデント対応にあります。
設備ごとに通知だけ止めていた場所(ミュート)と«ノイズトップ10»は新画面にありません。
新しく接続した設備や長く止まっていた設備は、タグごとに基準が定まるまで異常スコアが出ません。 その間は異常があっても確認する異常として上がってきません → AI発見と精度 — 学習中・判定不可
AI異常検知 (Anomaly Detection)
基盤モデル: IBM Granite TSPulse
| 対象 | ツール | 分析内容 |
|---|---|---|
| 設備センサー | detect_asset_anomaly | 温度、圧力、振動などセンサー異常パターン検知 |
| システムリソース | detect_system_anomaly | CPU、メモリ、ディスク異常検知 |
| OEE | detect_oee_anomaly | 稼働率、性能、品質異常パターン |
| RAM | detect_ram_anomaly | MTBF、MTTR異常パターン |
| EMS | detect_ems_anomaly | エネルギー消費、電力、炭素排出異常 |
| 作業指示 | detect_order_anomaly | 生産品質異常(OEE/RAM/EMS/複合) |
| アラーム | detect_alarm_anomaly | アラーム頻度異常パターン |
主なパラメータ:
threshold— 異常判定しきい値。設備センサー(detect_asset_anomaly)は補正スコアに対する値で、デフォルト5.0です — 🔴0は«自動»ではなくほぼすべての点を異常として数えますtop_k— 上位異常メトリック数lookback_minutes— 分析時間範囲target_columns— 分析対象(未指定時は全センサー自動取得)
設備センサーの異常スコア(score_scale: calibrated)は、分析ウィンドウの直前区間を基準として、
再構成誤差がその区間の典型的なばらつき(中央値・MAD)から何倍乖離しているか(ロバストz)です。
0が«平常»、5がデフォルトのしきい値です。
- 状態タグ(運転/停止のような値)はスコア対象から外れます。
- カウンタータグ(累積生産数など)は累積値ではなく5間隔増分の平均として見ます — 生産が 止まると増分が0に落ちることを捉えます。
- モデルの最初のウィンドウを複製した先頭区間はスコアから除外します。
- 集計・平滑化ウィンドウはセンサー基準8 / 4です(
aggr_win_size・smoothing_window_size)。 以前の32 / 16はスコアを30分近くぼかし、短い停止を見逃していました。
OEE・RAM・EMSのようなドメイン側スコアは依然として呼び出しごとに0~1に合わせた値です — 同じthreshold
でも尺度が異なります。
AI予測 (Forecasting)
基盤モデル: TinyTimeMixer — Granite-TTM R3(512-96-dec-512-r3、文脈512・予測96)
| 対象 | ツール | 予測内容 |
|---|---|---|
| 設備センサー | forecast_asset | センサー値の将来トレンド |
| システムリソース | forecast_system | CPU/メモリ/ディスク使用率 |
| OEE | forecast_oee | 稼働率、性能、品質の将来推移 |
| RAM | forecast_ram | 設備信頼性指標の将来トレンド |
| EMS | forecast_ems | エネルギー消費、炭素排出の見通し |
| 作業指示 | forecast_order | 生産品質の将来推移 |
| アラーム | forecast_alarm | アラーム頻度トレンド、故障予測 |
主なパラメータ:
prediction_length— 予測ステップ数enable_bounds— 信頼区間(上限/下限)出力
応答の model_used を見てください — 200だからといってTTMとは限りません
予測応答には何で出したかが一緒に付きます。
| 値 | 意味 |
|---|---|
TTM | 学習済みモデルが出しました |
NAIVE | データが不足してdrift・seasonal-naiveで出しました。fallback_reason に理由が入ります |
NAIVE もHTTP 200ですデータが不足しているときのみ、エンジンは失敗を上げず単純外挿に落とします。 呼び出す側が200だけを見ると、「TTM予測」の場所で単純外挿を見ることになります。
ですから**model_used を読んで記録してください。** NAIVE が増えればそれがそのままシグナルです。
単純外挿でも値を出せなかった列は0で埋めず、dropped_columns に記載して除外します。すべての列が
除外されると422です。
それ以外の失敗は吸収しません — 再試行しても直らない、あるいは隠してはいけないためです。
| 何 | 応答 |
|---|---|
| 致命的なCUDAエラー(GPUが死亡)・推論キューが詰まっている | 503 + Retry-After |
| モデル設定エラー(下記)・重みロード失敗・コード欠陥 | 500 |
信頼区間(enable_bounds)を要求したのに付いてこなかった場合は**bounds_reason**が理由を語ります —
「この設備は区間を出せない」と「送ったデータが不足していた」をここで切り分けます。
TS_TTM_MODEL_CLASS — チェックポイント世代とローダーを合わせる設定
予測モデル(TTM)は世代によって読み込むクラスが異なります。 insight-server の環境変数一つで選びます(2026-09-21以降の版に入りました — それ以前の版にはこの設定はなくForPredictionに固定です)。
| 値 | 使う場所 |
|---|---|
| 空欄(デフォルト) | チェックポイントの config.json(decompose)が選びます — 大体これにしておきます |
ForPrediction | TTM R2 チェックポイント |
ForDecomposedPrediction | Granite-TTM R3(分解予測)チェックポイント |
イメージに焼き込まれたデフォルトモデルはR3です。R2もmodel/ttm-r2として一緒に収録されており、戻すときは
クラスに触れずパス1行だけを変更します。
TS_TTM_DIR=/app/model/ttm-r2 # R2 로 되돌리기 — 클래스는 그 디렉터리의 config 가 정합니다
R2とR3は重みキーが一つも重複していないのに互いのチェックポイントを例外なく読み込みます。そのままにすると445個のパラメータが全部新しく作られた(ランダムな)モデルが出来上がり、それがmodel_used="TTM"という名札を付けて答えを出します。
現在はロード時にチェックポイントになく新しく作られたパラメータが一つでもあれば拒否します。ログにはこう残ります。
[MODEL_LOAD] TTM dir=… , class=ForPrediction, in_channels=…
[MODEL_LOAD_FAIL] TTM dir=… — 학습된 가중치를 못 읽었다. 무작위 초기화 모델로 대체하지 «않는다».
    reason=[ForPrediction] 체크포인트에 없어 새로 지은 파라미터 445개 (예: …) —
           클래스가 체크포인트 세대와 맞는지 보라(TS_TTM_MODEL_CLASS)
設定エラーはサーバーを落としません — 同じプロセスが異常検知もサービスしているため、予測設定一つで無関係な機能まで止めることはありません。
代わりに**/health に表れます。** 応答の models にモデルごとのロード状態が載り、一つでもロード
できないと status が**degradedです(HTTPは200)。コンテナのヘルスチェックが使う/pingは両
モデルが両方失敗したときのみ**503です — 予測だけ死んだときにコンテナが再起動を繰り返さないように
するためです。
"status": "degraded",
"models": {
  "tspulse": { "loaded": true,  "error": null },
  "ttm":     { "loaded": false, "error": "ModelConfigError: …" }
}
⚠ /health に models 項目がなければ、それ以前の版です — その版ではヘルスチェックが正常に
見えるので、下記の予測リクエストと起動ログで見分けてください。これも版によって異なります。
| 版 | 予測リクエスト | 起動ログ |
|---|---|---|
| 2026-09-21以降 | HTTP 500 | [MODEL_WARMUP_FAIL] TTM ch=… 설정이 체크포인트와 맞지 않는다 — 이 설정으로는 모든 예측이 실패한다 |
| それ以前 | HTTP 200・model_used="NAIVE" | [MODEL_WARMUP_SKIP] TTM ch=… |
以前の版では設定エラーも単純外挿に吸収され、/health 正常・予測200・すべての答えが静かに単純外挿のまま動くことがありました。今は再試行しても直らない失敗(設定)と一時的な失敗(データ不足など)を分け、前者だけを上げます。
🔴 どちらの版かは版番号ではなく«ログの行»で見分けてください。 今月のイメージタグは
日付まで付いて何度も焼き直されます(2026.09-<date>-<시각>) — 同じ2026.09でも版が異なります。
値を誤って入力するとデフォルト値に静かに落ちずその場で拒否します。次のいずれかです。
| 状況 | ログに出る言葉 |
|---|---|
| 知らない名前 | TS_TTM_MODEL_CLASS='…' 를 모른다 — ['ForDecomposedPrediction', 'ForPrediction'] 중 하나여야 한다 |
| 名前は合っているがライブラリが古い | … 를 골랐는데 이 tsfm_public 판에 그 클래스가 없다 (granite-tsfm 0.3.9 이상 필요) |
アラーム深層分析
| ツール | 説明 |
|---|---|
get_alarm_stats | アラーム統計サマリー — 頻度、優先度分布、Topアラーム、Topタグ |
analyze_alarm_duration | アラーム継続時間/MTTA分析 — 劣化検知、平均認知時間の推移 |
analyze_alarm_correlation | アラーム-センサー相関 — どのセンサー変化がアラームを誘発するか |
設備健全性指数
get_asset_health — センサー + OEE + RAM + EMS + アラームを総合して0~100点の健全性スコアを算出
フィーチャーストア (Feature Store)
事前計算済みフィーチャーとLLMコンテキストにより高速な総合分析を提供します。
| ツール | 説明 |
|---|---|
get_feature_status | フィーチャーストア状態 — スケジューラージョブ、実行時刻、バックフィル状態 |
get_asset_features | 設備フィーチャー照会 — 健全性スコア、異常スコア、アラーム、状態、生産指標 |
get_asset_context | LLMコンテキスト — 日次総合分析要約テキスト(事前生成) |
analyze_asset | 設備総合分析 — 健全性スコア、センサー、アラーム、OEE/RAM/EMS、原因ヒント |
explain_asset_anomaly | 異常原因分析 — 異常タグ、アラーム、状態変化に基づく原因推定 |
trigger_feature_pipeline | フィーチャーパイプライン手動実行 |
フィーチャーストアアーキテクチャ:
- スケジューラー: 時間別(hourly)、日別(daily)の自動フィーチャー計算
- 埋め込み: 設備フィーチャーをベクトルに変換して類似度検索をサポート
- LLMコンテキスト: 日次総合分析テキストを事前生成し、応答速度を最大化
MCPリソース (6個)
| リソースURI | 説明 |
|---|---|
plantpulse://system/info | システム情報 |
plantpulse://domains | ドメイン一覧およびAPIエンドポイント |
plantpulse://metrics/oee | OEEメトリック説明 |
plantpulse://metrics/ram | RAMメトリック説明 |
plantpulse://metrics/ems | EMSメトリック説明 |
plantpulse://metrics/alarm | アラームメトリックおよび分析能力 |
発見・注意・生産 (2026.10)
エンジンが自ら書き留めたものを読み、生産に関する質問に答えるツールです。チャットではinsight_
プレフィックスが付いて表示されます。
| ツール | 説明 |
|---|---|
list_findings | AIが自ら見つけておいた発見 — 設備異常・オーダー目標未達・データ途切れ・データ品質・連鎖停止・故障リスク・限界値到達・電力ピーク・AI設定変更など。重要度・緊急度・根拠事実・状態 |
get_attention_ranking | サイト別**「今日まず見るべき設備」**ランキング — 注意スコア(0~100)と理由3つ、前日比ランキング変動 |
forecast_order_completion | 進行中のワークオーダーが計画終了までに目標数量に到達するか — 予想良品数(P10~P90)・到達確率・不足数量 |
get_oee_losses | OEEがなぜ低いか — 稼働率・性能・品質ロス時間、6大ロス、停止原因 |
get_spc_chart | 設備・製品の不良率管理図(p管理図) — 中心線・管理限界・異常シグナル |
autonomy_status | AIが自ら行う改善(正常基準線・スコアラー)の現在状態 — モード・使用中バージョン・シャドウ・一時停止 |
2026.10 再リリース(2026-10-20) から list_findings · get_attention_ranking は最初から有効になっており、「今日まず見るべき設備は?」 · 「開いている発見を整理して」にすぐ答えます。
forecast_order_completion · get_oee_losses · get_spc_chart · autonomy_status の4つはオフの状態で入るため、問い合わせで使うには管理者が
AI管理コンソール › MCPゲートウェイ › ツール で有効化します → MCPゲートウェイ
設備・タグ理解
設備にタグが数千個付いていると、どれが何なのか人がすべて説明することはできません。以下のツールは実データ統計とプラットフォームメタデータでタグの性質を自動整理します。
| ツール | 説明 |
|---|---|
list_asset_tags | 設備のタグ一覧 |
get_asset_profile | 設備プロファイル — どのタグがどんな性質か整理 |
get_asset_tag_relations | タグ間相関 — 一緒に動くタグをまとめる |
事例検索・比較
| ツール | 説明 |
|---|---|
find_similar_assets | 類似設備検索 — ベクトル埋め込みコサイン類似度に基づく |
find_similar_anomalies | 類似異常事例検索 — 過去に同じ形の異常があったか |
find_fleet_outlier | フリート外れ値 — 同種設備の中で一つだけ違う動きをするもの |
search_pattern | パターン検索 — 指定した波形に似た区間を探す |
check_failure_precursor | 故障前兆点検 — 故障前に現れていたシグナルが今見えるか |
活用シナリオ
| シナリオ | 活用ツール |
|---|---|
| 設備異常早期検知 | detect_asset_anomaly → explain_asset_anomaly |
| 予知保全計画 | get_asset_health → forecast_asset → forecast_ram |
| 日次設備ブリーフィング | get_asset_context → get_asset_features |
| アラーム急増原因分析 | get_alarm_stats → analyze_alarm_correlation → analyze_alarm_duration |
| 類似設備比較分析 | analyze_asset → find_similar_assets |
| この異常、以前にもあったか | detect_asset_anomaly → find_similar_anomalies |
| 故障する前に捉える | check_failure_precursor → forecast_ram |
| 同じ設備なのに一つだけ異常 | find_fleet_outlier → analyze_asset |
| エネルギー異常検知 | detect_ems_anomaly → forecast_ems |
| 生産品質予測 | detect_order_anomaly → forecast_order |
| このオーダーは時間通りに終わるか | forecast_order_completion → get_oee_losses |
| 今日どこから見るべきか | get_attention_ranking → list_findings |