診断
目次
- 概要
- 画面構成
- 上部検索エリア
- タイムライン
- 左側 — 診断ログテーブル
- 右側統計パネル (3つ)
- 全出力 (CSV)
- 障害発生時の標準診断手順
- よく見る診断メッセージパターン
- よくある質問
- 関連画面
概要
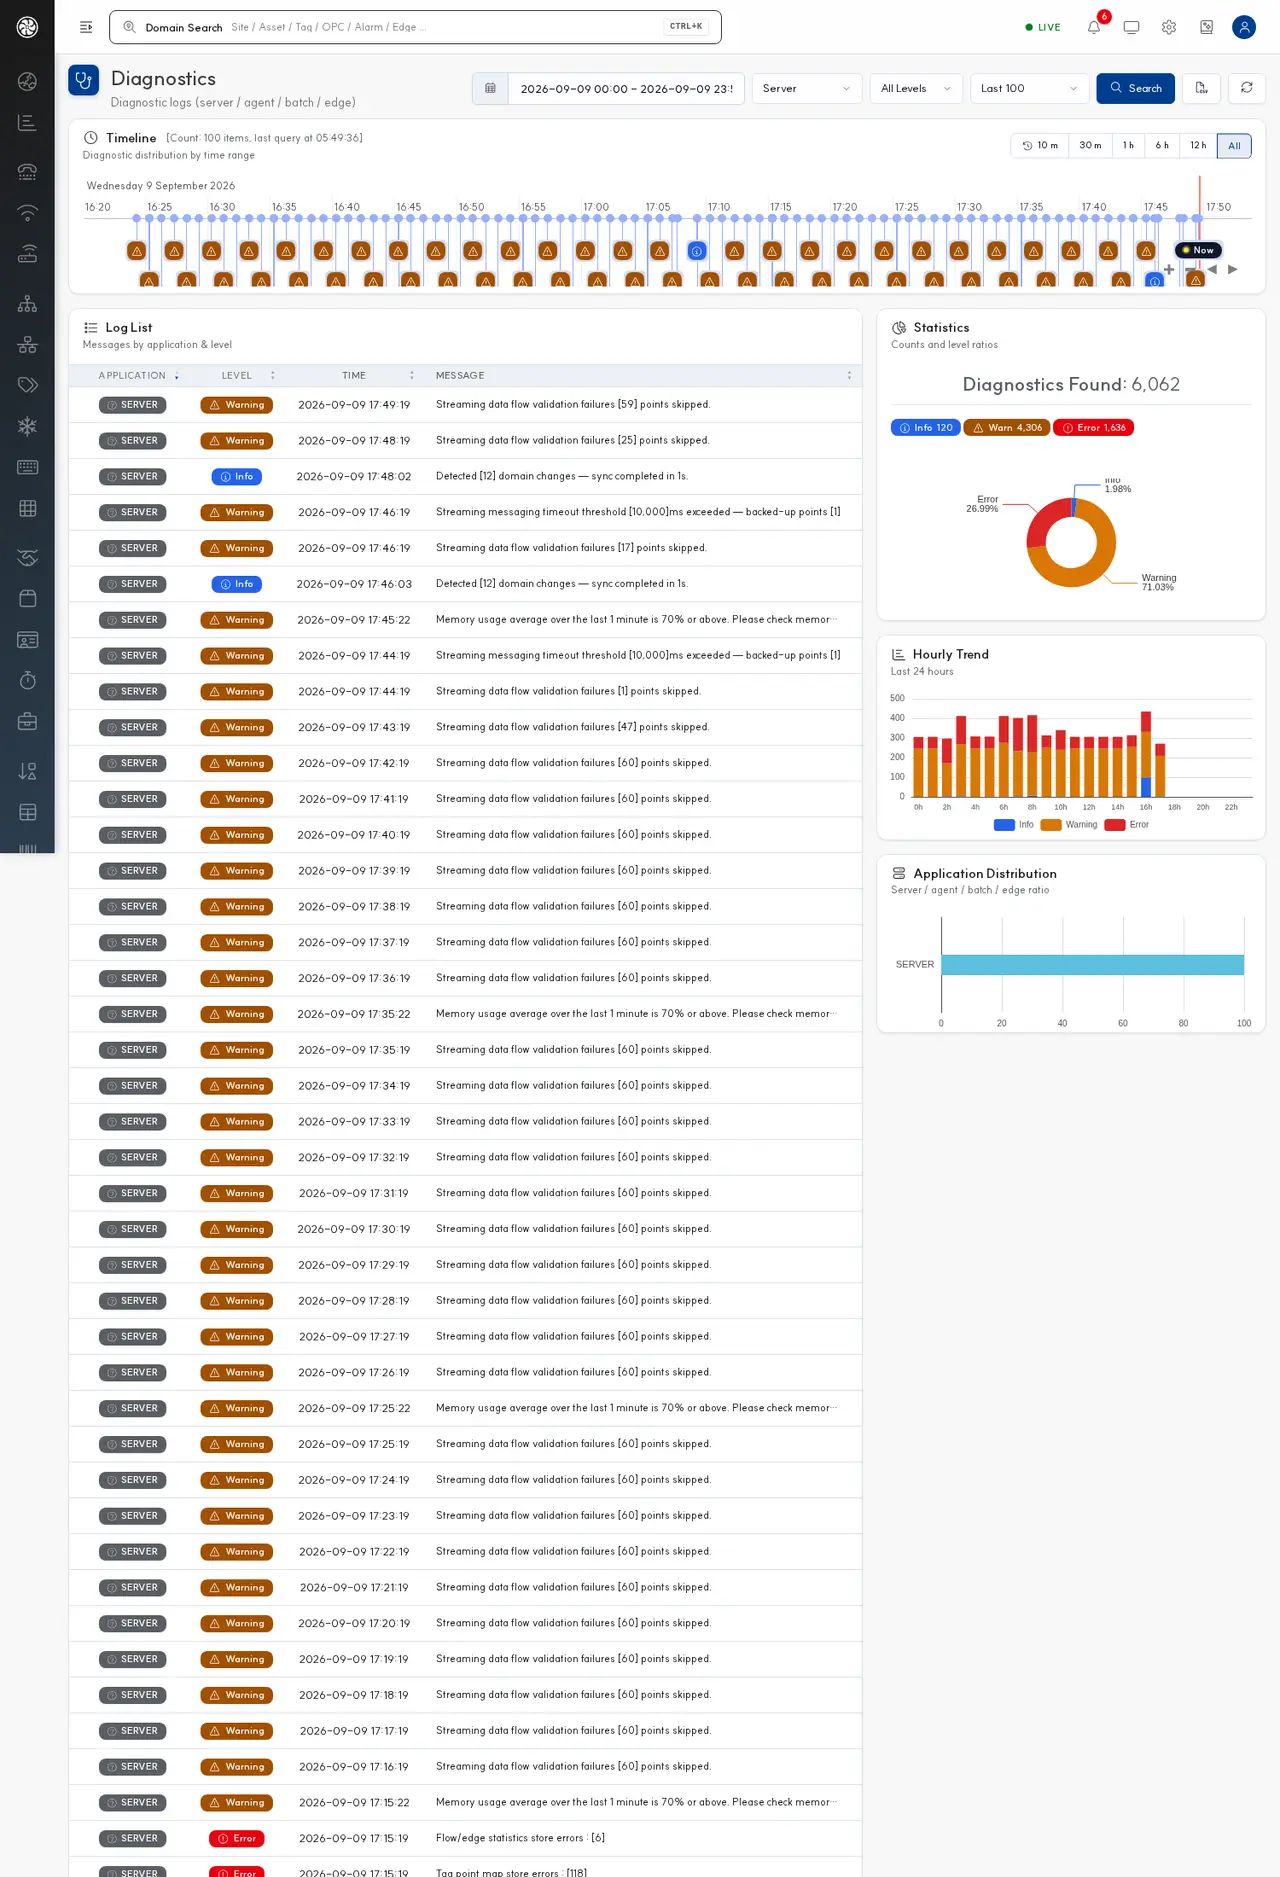
診断画面は、プラットフォーム内部で発生したすべての診断イベント(情報・警告・重大)を、時系列タイムライン + テーブル + 統計チャートの3つの視点で同時に表示します。システム管理者や運用担当者が障害原因を把握する際に最初にアクセスする画面です。
この画面は以下の動作をひとつにまとめています。
- タイムライン — 時間の流れの中で、どこで何が起こったかを一目で確認
- ログテーブル — 正確な時刻・アプリケーション・レベル・メッセージ内容
- 統計パネル — レベル割合・時間帯分布・アプリケーション分布
パス: 左メニュー > System > 診断 (内部URL /diagnostic/index)
画面構成
┌───────────────────────────────────────────────────────────────────────────────┐
│ 🩺 진단                                                                          │
│   [기간]  [애플리케이션]  [레벨]  [건수]  [조회] [전체 출력] [↻]                  │ ← ① 검색 영역
├───────────────────────────────────────────────────────────────────────────────┤
│                          타임라인 + 빠른 시간 범위                                │ ← ② 타임라인
├──────────────────────────────────────────────────────────┬────────────────────┤
│                                                          │ 🥧 통계             │
│                  진단 로그 테이블                          │  검색된 진단 N건    │
│      애플리케이션 │ 레벨 │ 시간      │ 메세지              │  정보·경고·심각 뱃지│ ← ③
│      ...                                                 │  레벨 비율 차트     │
│                                                          ├────────────────────┤
│                                                          │ 📊 시간별 발생 추이 │
│                                                          ├────────────────────┤
│                                                          │ 🖥 애플리케이션별  │
│                                                          │   분포              │
└──────────────────────────────────────────────────────────┴────────────────────┘
| エリア | 位置 | 表示 |
|---|---|---|
| ① 検索エリア | 右上フォーム | 期間・アプリケーション・レベル・表示件数 + 照会/全出力/更新 |
| ② タイムライン | 全幅 | 時間軸上に診断マーカー + クイック時間範囲6ボタン |
| ③ 左側 | col-lg-8 | 診断ログテーブル(固定4カラム) |
| ③ 右側 | col-lg-4 | 統計3パネル(レベル割合・時間推移・アプリケーション分布) |
上部検索エリア
ページ右上の検索フォームは1行で配置されており、左→右の順に以下のコントロールがあります。
入力フィールドとボタン
| コントロール | 幅 | 形式 | デフォルト・オプション | 説明 |
|---|---|---|---|---|
期間 (search_time) | 280px | テキスト入力(中央揃え、太字) | 空 | クリックすると日時範囲選択が開き、開始/終了時刻を設定。フォーム内ではhiddenフィールド search_date_from / search_date_to で送信される |
アプリケーション (app_name) | 120px | ドロップダウン | サーバー (SERVER), エージェント (AGENT), バッチ (BATCH), エッジゲートウェイ (EDGE) | 診断を発行したモジュール |
レベル (level) | 100px | ドロップダウン | 全レベル, 情報 (INFO), 警告 (WARN), 重大 (ERROR) | 診断レベルフィルター。空の場合は全て |
メッセージ検索 (message) | 250px (非表示) | テキスト入力 | 空 | メッセージ本文キーワード検索。デフォルトは非表示で、運用環境に応じて表示 |
件数 (limit) | 130px | ドロップダウン | 100, 200, 300, 500, 1,000 | 表示する最近の診断件数 |
| 照会 | (自動) | 赤ボタン + 🔍 | — | 上記条件で診断データを照会 |
| 全出力 | (自動) | 赤ボタン + 📄 | — | 現在の条件の診断結果をCSVファイルで一括ダウンロード |
更新 (realtime_icon) | (自動) | 赤ボタン + ↻ | — | 直前の条件のまま再照会 — ダッシュボード形式として利用可能 |
アプリケーションドロップダウンの意味
| 値 | ラベル | 説明 |
|---|---|---|
SERVER | サーバー | Webサーバー・管理コンソール・ドメインサービス |
AGENT | エージェント | データ収集エージェント(パイプライン) |
BATCH | バッチ | バッチ処理・集計・レポート生成 |
EDGE | エッジゲートウェイ | エッジデバイス(現場に設置されたゲートウェイ) |
レベルドロップダウンの意味
| 値 | ラベル | 色 | 意味 | 推奨対応 |
|---|---|---|---|---|
| `` (空の値) | 全レベル | — | すべてのレベル | |
INFO | 情報 | 青 | 正常動作の情報・開始/終了通知など | 特に対応不要 |
WARN | 警告 | オレンジ | 潜在的な問題・ソフト閾値超過 | 推移確認、同時刻の他モジュール点検 |
ERROR | 重大 | 赤 | エラー・機能障害・例外 | 即座に原因特定 + システム管理者 |
タイムライン
検索エリア下のパネルに診断タイムラインが描画されます。
| 項目 | 説明 |
|---|---|
| ヘッダー | 🕐 "タイムライン" + 右側に小さな文字で検索結果概要(result_txt) |
| タイムライン本文 | alarm_timeline — 横軸が時間、診断項目が色付きマーカーで表示 |
| マーカー色 | 情報=青、警告=オレンジ、重大=赤 |
| ホバー | マーカーにマウスを乗せると時刻 + メッセージプレビューのツールチップ |
| クリック | 該当診断の行が左側テーブルで自動ハイライト |
クイック時間範囲 (Timeline range)
タイムラインヘッダー右側の6つのボタンで即座にズームできます。
| ボタン | data-range | 動作 |
|---|---|---|
| 10分前 | 10M | 直前10分区間にズーム |
| 30分前 | 30M | 直前30分区間にズーム |
| 1時間前 | 1H | 直前1時間区間にズーム |
| 6時間前 | 6H | 直前6時間区間にズーム |
| 12時間前 | 12H | 直前12時間区間にズーム |
| 全期間 | ALL | 検索全体区間 (デフォルト有効) |
クイック範囲ボタンは、画面に既に照会された結果上でズームのみ適用します。より長い期間を見るには、検索エリアの 期間 入力で新しく照会する必要があります。
左側 — 診断ログテーブル
| 애플리케이션 | 레벨 | 시간              | 메세지                                |
|-------------|------|------------------|--------------------------------------|
| server      | ERROR| 2026-05-08 12:00 | Connection timeout to upstream...     |
| messaging   | WARN | 2026-05-08 11:55 | Buffer overflow threshold reached...  |
| カラム | 幅 | 整列 | 表示 |
|---|---|---|---|
| アプリケーション | 140px | 中央 | 診断を発行したモジュール名 (例: server, agent, batch, edge) |
| レベル | 80px | 中央 | 色付きバッジ — INFO(青) / WARN(オレンジ) / ERROR(赤) |
| 時間 | 160px | 中央 | 診断発生時刻 (yyyy-MM-dd HH:mm:ss) |
| メッセージ | 自動(残り) | 左 | 診断本文 (テーブルが table-layout: fixed のためセル幅に合わせて切れる — 改行で見たい場合は行をダブルクリックまたはマウスホバー) |
行インタラクション
- ホバー: 行背景をハイライト
- クリック: タイムラインの該当マーカーが同期ハイライト (左右同期)
- ダブルクリック/ポップアップ: 本文全体やスタックトレースなどの追加情報がモーダルで表示
テーブル下部ページネーション
照会件数が多い場合、ページ単位で分割されます。1ページあたりの行数は検索エリアの 件数 ドロップダウン(100/200/300/500/1,000)に応じて決定されます。
右側統計パネル (3つ)
検索結果の統計可視化。すべて左側テーブルと同じデータを異なる視点で表示します。
1. 統計 — レベル割合 (diag_level_chart)
┌────────────────────────────────┐
│  검색된 진단 : N 건             │  ← 큰 글씨 헤드라인
│  [정보 N] [경고 N] [심각 N]     │  ← 3색 뱃지
│                                │
│        도넛/막대 차트           │  ← diag_level_chart (150px 높이)
└────────────────────────────────┘
| 項目 | ID | 表示 |
|---|---|---|
| ヘッドライン | — | "検索された診断 : N 件" 大きな文字 |
| 検索された総件数 | diag_total_count | 整数 |
| 情報バッジ | diag_info_count | 情報レベルの件数 — 青背景 |
| 警告バッジ | diag_warn_count | 警告レベルの件数 — オレンジ背景 |
| 重大バッジ | diag_error_count | 重大レベルの件数 — 赤背景 |
| レベル割合チャート | diag_level_chart | 情報・警告・重大の割合チャート |
| 空状態案内 | diag_stats_empty | データがない場合 "データがありません。" と表示 |
2. 時間別発生推移 (diag_hourly_chart)
| 項目 | 説明 |
|---|---|
| ヘッダー | 📊 "時間別発生推移" |
| チャート | 時間帯(時間単位)の棒グラフ (高さ170px) — X軸が時間、Y軸が診断件数 |
| 棒の分割 | 情報/警告/重大が色で積み上げて表示 |
解釈: 急に1つの時間帯で棒が伸び上がった場合、その時刻に大規模な異常があったということ。時刻をメモし、左側テーブルで該当時刻の行をダブルクリックして詳細を確認。
3. アプリケーション別分布 (diag_app_chart)
| 項目 | 説明 |
|---|---|
| ヘッダー | 🖥 "アプリケーション別分布" |
| チャート | ドーナツ/棒グラフ (高さ140px) — アプリケーション別の診断件数 |
解釈: 1つのアプリケーションが全体の70%以上を占める場合、そのモジュールに集中した障害の可能性。検索エリアの アプリケーション ドロップダウンで絞り込んで照会し、左側テーブルを確認してください。
全出力 (CSV)
検索エリアの 全出力 ボタンをクリックすると、現在の検索条件のすべての診断をCSVファイルでダウンロードできます。
CSVカラム
| カラム | 形式 |
|---|---|
| アプリケーション | テキスト |
| レベル | テキスト (INFO/WARN/ERROR) |
| 時間 | テキスト (yyyy-MM-dd HH:mm:ss) |
| メッセージ | テキスト (二重引用符でエスケープ) |
CSVは画面に表示されている行だけでなく、検索条件に一致する全結果をエクスポートします。件数 ドロップダウン(最近のN件)の影響を受けないため、長期分析に適しています。
CSV活用のヒント
- システム管理者へ引き継ぐ際に圧縮(.zip)して添付
- 外部分析ツール(スプレッドシート・BIツール)に取り込み、モジュール・時間帯・キーワード別に追加分析
- 同じパターンが毎日繰り返されるか、1週間分をまとめて比較
障害発生時の標準診断手順
障害が発生した際は、次の順序で進めると効率的に原因を特定できます。
ステップ1 — 時間範囲を絞り込む
- 期間 入力に障害発生時刻 ±10分 ~ ±30分を指定
- 件数 は1,000件に (見逃しがないように)
ステップ2 — 重大を優先して照会
- レベル ドロップダウンを 重大(ERROR) に設定 → 照会
- 左側テーブルの最初の行(最も新しいERROR)からメッセージを確認
- 右側の アプリケーション別分布 チャートでどのモジュールがERRORを多く発生させているか確認
ステップ3 — 同時刻の警告を確認
- レベル を 警告(WARN) に変更し、同じ期間を照会
- ERRORの直前1〜5分間に発生したWARNメッセージを確認 — 通常ERRORの手掛かりになります
ステップ4 — モジュール別に絞り込む
- ERROR/WARNが最も多いアプリケーションを アプリケーション ドロップダウンで選択
- レベル を 全レベル に戻して、モジュール内のすべての流れを確認 — INFOが途切れる時点が手掛かり
ステップ5 — メッセージパターン
左側テーブルのメッセージ本文を確認。同じメッセージが繰り返されているか(ルール暴走)、一度だけ発生した単発か(外部状態の変動)を区別。
ステップ6 — システム管理者へ引き継ぎ
運用担当者自身で障害原因に対処できない場合は、全出力 ボタンでCSVファイルを取得し、システム管理者に引き継ぎます。報告時には以下を添付すると良いでしょう。
- 障害発生時刻(最初のERROR時刻)
- 影響範囲(どのサイト/モジュール)
- ERRORメッセージ1〜3件のテキスト
- CSVファイル
よく見る診断メッセージパターン
| メッセージキーワード | 意味 | 一般的な対応 |
|---|---|---|
Connection timeout | 外部サービス接続タイムアウト | ネットワーク状態・対象サービスの稼働状況 |
Out of memory / OOM | メモリ不足 | システムリソース点検・再起動検討 (システム管理者) |
Disk space low | ディスク空き容量不足 | 古いデータの整理またはディスク増設 |
Authentication failed | 認証失敗 | トークン・アカウント情報の期限切れ/エラー確認 |
Buffer overflow | 処理キュー満杯 | トリガー事前フィルター・外部IOスロットルで負荷を平準化 |
Job already running | ジョブ重複実行 | 前のジョブ未完了 — システム管理者点検 |
Failed to parse | メッセージパース失敗 | 外部システムのペイロード形式を確認 |
Schema mismatch | DB/メッセージスキーマ不一致 | システム管理者点検 (デプロイ直後の可能性あり) |
Pipeline exception | データパイプライン例外 | 日次統計の選択日詳細チャートも合わせて確認 |
Edge disconnect | エッジデバイス切断 | 接続管理 でデバイスごとの状態を確認 |
よくある質問
Q. メッセージ検索(キーワード)入力欄が見当たりません。
A. 運用環境設定によってはメッセージ本文検索が無効になっている場合があります(display:none)。有効化が必要な場合はシステム管理者にお問い合わせください。
Q. 診断データの保存期間は?
A. デフォルトで7日間です。長期保存が必要な場合は、全出力 でCSVを外部システムに保存するか、フロー の診断トリガー(flow_on_diagnostic)で外部ログシステムに自動保存できます。
Q. ERRORが非常に多く蓄積されており、すべて同じメッセージです。無視しても良いですか? A. 同じERRORが短時間で繰り返される場合、1つの原因が暴走している可能性が高く、カウントだけでは大きな意味を持ちません。まず最初の発生時刻とメッセージ自体を確認してください。
Q. 更新ボタンを自動更新に変更できますか? A. 画面は明示的な更新のみ動作します。運用監視用途で自動更新が必要な場合は、短い間隔で更新をクリックするか、フロー の通知自動化でERROR発生時にプッシュを受け取るよう設定してください。
Q. タイムラインのマーカー色が密集しすぎています。 A. 件数 ドロップダウンを小さい値(100〜200件)に下げるか、レベル をERROR/WARNに絞り込むと見やすくなります。
Q. 同時刻にすべてのモジュールがERRORを発行しました。 A. 共通インフラ(メッセージチャネル・ストレージ)の障害の可能性が高いです。ダッシュボード ヘルスレール のインフラ/エンジン状態を合わせて確認してください。
Q. CSVダウンロードに時間がかかります。 A. 検索条件が広すぎる可能性があります。期間を24時間以下に短縮するか、モジュールを限定してください。