TimeSeries-Insight (AI 분석 엔진)
개요
PlantPulse TimeSeries-Insight는 제조 시계열 데이터에 특화된 AI 이상 탐지, 예측, 종합 분석 MCP 서버입니다.
IBM Granite TSPulse(이상탐지)와 TinyTimeMixer TTM(예측) AI 모델을 활용하여, 센서 데이터, OEE, RAM, EMS, 알람, 작업지시 등 공장의 모든 시계열 데이터에 대한 지능형 분석을 제공합니다.
39개 분석 도구와 피처 스토어를 통해 실시간 분석부터 사전 계산된 종합 인사이트까지 지원합니다. 2026.10 부터는 도구로 불리기를 기다리지 않고 스스로 문제를 찾아 «발견» 으로 적어 두고, 코파일럿이 그것을 받아 사람에게 알립니다 → AI 발견과 정확도
insight-api(:8970)가 도구와 데이터를 담당하고, 모델 추론(TSPulse·TTM)은
insight-server(:8980)에 위임합니다. GPU 는 추론 쪽에만 필요하므로 두 서비스를 다른
장비에 둘 수 있습니다.
이상탐지를 코파일럿에서 보는 자리
엔진이 찾아낸 설비 이상은 코파일럿의 제안 › 할 일 › 돌발에 확인할 이상으로 올라옵니다. 설비마다 한 줄이고, 줄을 누르면 상세에서 추세선 · 관련 태그 · 근거를 보고 이상 접수로 올리기 또는 무시(사유)를 정합니다 → 제안
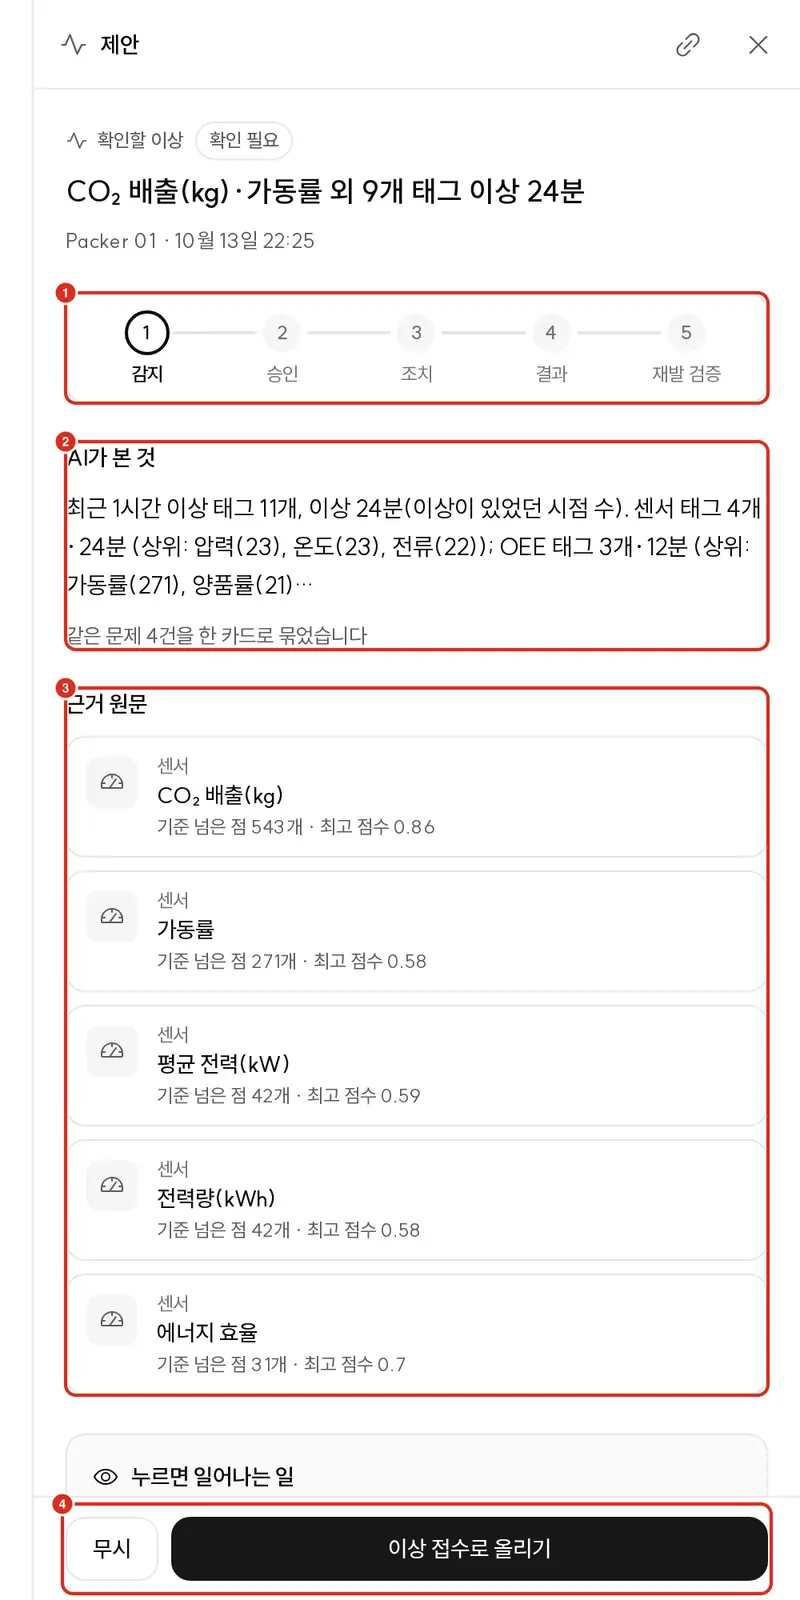
예전의 «이상 진단» 메뉴와 그 안의 «운영 콘솔» 은 없어졌고, 그 일은 제안 › 돌발에서 합니다(옛 주소 /anomaly 는 넘어가지 않습니다).
| 예전 운영 콘솔에서 하던 일 | 지금 |
|---|---|
| 이상 목록 훑기 · 확인 | 제안 › 할 일 › 돌발. 급한 순으로 놓입니다 |
| 맞았는지 표시(AI 판정) | 헛경보면 무시에 사유를 고릅니다 → AI 발견과 정확도 |
| 풀스캔 · 타깃 «실행» 단추 | 단추는 없습니다. 서버가 주기대로 돕니다 — 아래 |
| 설비 타임라인 | 디지털 스레드가 연결된 설치에서 묻기에 「이 설비에 최근 일어난 일을 시간순으로 보여줘」 |
탐지는 두 가지 주기로 돕니다
| 무엇을 재나 | 언제(기본) | |
|---|---|---|
| 전체 훑기 | 전체 설비 | 2시간마다 |
| 타깃 탐지 | 최근 알람이 뜬 설비만 | 10분마다 |
주기 · 심각도 기준 · 알림 채널은 이상탐지 · 이상 접수 대응에 있습니다.
설비별로 알림만 멈춰 두던 자리(뮤트)와 «노이즈 톱10» 은 새 화면에 없습니다.
새로 붙인 설비나 오래 멈췄던 설비는 태그마다 기준을 잡을 때까지 이상 점수가 나오지 않습니다. 그동안은 이상이 있어도 확인할 이상으로 올라오지 않습니다 → AI 발견과 정확도 — 학습 중 · 판정 불가
AI 이상 탐지 (Anomaly Detection)
기반 모델: IBM Granite TSPulse
| 대상 | 도구 | 분석 내용 |
|---|---|---|
| 설비 센서 | detect_asset_anomaly | 온도, 압력, 진동 등 센서 이상 패턴 감지 |
| 시스템 리소스 | detect_system_anomaly | CPU, 메모리, 디스크 이상 감지 |
| OEE | detect_oee_anomaly | 가용률, 성능, 품질 이상 패턴 |
| RAM | detect_ram_anomaly | MTBF, MTTR 이상 패턴 |
| EMS | detect_ems_anomaly | 에너지 소비, 전력, 탄소배출 이상 |
| 작업지시 | detect_order_anomaly | 생산 품질 이상 (OEE/RAM/EMS/복합) |
| 알람 | detect_alarm_anomaly | 알람 빈도 이상 패턴 |
주요 파라미터:
threshold— 이상 판정 임계값. 설비 센서(detect_asset_anomaly)는 보정 점수에 대는 값이고 기본 5.0 입니다 — 🔴0은 «자동» 이 아니라 거의 모든 점을 이상으로 셉니다top_k— 상위 이상 메트릭 수lookback_minutes— 분석 시간 범위target_columns— 분석 대상 (미지정 시 전체 센서 자동 조회)
설비 센서의 이상 점수(score_scale: calibrated)는 분석 창 바로 앞 구간을 기준으로 삼아,
재구성 오차가 그 구간의 전형적 흔들림(중앙값 · MAD)에서 몇 배만큼 벗어났는지(로버스트 z)입니다.
0 이 «평소», 5 가 기본 임계입니다.
- 상태 태그(운전/정지 같은 값)는 점수 대상에서 빠집니다.
- 카운터 태그(누적 생산 수 등)는 누적값이 아니라 5간격 증분의 평균으로 봅니다 — 생산이 멈추면 증분이 0 으로 떨어지는 것을 잡습니다.
- 모델 첫 창을 복제한 앞쪽 구간은 점수에서 뺍니다.
- 집계·평활 창은 센서 기준 8 / 4 입니다(
aggr_win_size·smoothing_window_size). 예전 32 / 16 은 점수를 30분 가까이 뭉개 짧은 정지를 놓쳤습니다.
OEE · RAM · EMS 같은 도메인 쪽 점수는 여전히 호출마다 0~1 로 맞춘 값입니다 — 같은 threshold
라도 척도가 다릅니다.
AI 예측 (Forecasting)
기반 모델: TinyTimeMixer — Granite-TTM R3 (512-96-dec-512-r3, 문맥 512 · 예측 96)
| 대상 | 도구 | 예측 내용 |
|---|---|---|
| 설비 센서 | forecast_asset | 센서값 미래 추세 |
| 시스템 리소스 | forecast_system | CPU/메모리/디스크 사용률 |
| OEE | forecast_oee | 가용률, 성능, 품질 미래 추이 |
| RAM | forecast_ram | 설비 신뢰성 지표 미래 추세 |
| EMS | forecast_ems | 에너지 소비, 탄소배출 전망 |
| 작업지시 | forecast_order | 생산 품질 미래 추이 |
| 알람 | forecast_alarm | 알람 빈도 추세, 고장 예측 |
주요 파라미터:
prediction_length— 예측 스텝 수enable_bounds— 신뢰구간(상한/하한) 출력
응답의 model_used 를 보십시오 — 200 이라고 TTM 이 아닙니다
예측 응답에는 무엇으로 냈는지가 같이 옵니다.
| 값 | 뜻 |
|---|---|
TTM | 학습된 모델이 냈습니다 |
NAIVE | 데이터가 모자라 drift · seasonal-naive 로 냈습니다. fallback_reason 에 이유가 들어옵니다 |
NAIVE 도 HTTP 200 입니다데이터가 모자랄 때만, 엔진은 실패를 올리지 않고 단순 외삽으로 내려갑니다. 호출하는 쪽이 200 만 보면 「TTM 예측」 자리에서 단순 외삽을 보게 됩니다.
그래서 model_used 를 읽고 기록하십시오. NAIVE 가 늘어나면 그것이 곧 신호입니다.
단순 외삽으로도 값을 못 낸 열은 0 으로 채우지 않고 dropped_columns 에 적어 뺍니다. 모든 열이
빠지면 422 입니다.
그 밖의 실패는 흡수하지 않습니다 — 재시도해도 안 낫거나, 숨기면 안 되기 때문입니다.
| 무엇 | 응답 |
|---|---|
| 치명적 CUDA 오류(GPU 가 죽음) · 추론 대기열이 참 | 503 + Retry-After |
| 모델 설정 오류(아래) · 가중치 적재 실패 · 코드 결함 | 500 |
신뢰구간(enable_bounds)을 요청했는데 안 붙어 왔으면 bounds_reason 이 이유를 말합니다 —
「이 설비는 구간을 못 낸다」와 「보낸 데이터가 모자랐다」를 여기서 가릅니다.
TS_TTM_MODEL_CLASS — 체크포인트 세대와 로더를 맞추는 설정
예측 모델(TTM)은 세대에 따라 읽는 클래스가 다릅니다. insight-server 의 환경변수 하나로 고릅니다(2026-09-21 이후 판에 들어갔습니다 — 그 이전 판에는 이 설정이 없고 ForPrediction 으로 고정입니다).
| 값 | 쓰는 곳 |
|---|---|
| 비워 둠 (기본값) | 체크포인트의 config.json(decompose)이 고릅니다 — 대개 이것으로 둡니다 |
ForPrediction | TTM R2 체크포인트 |
ForDecomposedPrediction | Granite-TTM R3(분해 예측) 체크포인트 |
이미지에 구워진 기본 모델은 R3 입니다. R2 도 model/ttm-r2 로 같이 실려 있어, 되돌릴 때는
클래스를 건드리지 않고 경로 한 줄만 바꿉니다.
TS_TTM_DIR=/app/model/ttm-r2 # R2 로 되돌리기 — 클래스는 그 디렉터리의 config 가 정합니다
R2 와 R3 는 가중치 키가 하나도 겹치지 않는데도 서로의 체크포인트를 예외 없이 읽습니다. 그대로 두면 445개 파라미터가 전부 새로 지어진(무작위) 모델이 만들어지고, 그것이 model_used="TTM" 이라는 이름표를 달고 답을 냅니다.
지금은 적재할 때 체크포인트에 없어 새로 지은 파라미터가 하나라도 있으면 거부합니다. 로그에 이렇게 남습니다.
[MODEL_LOAD] TTM dir=… , class=ForPrediction, in_channels=…
[MODEL_LOAD_FAIL] TTM dir=… — 학습된 가중치를 못 읽었다. 무작위 초기화 모델로 대체하지 «않는다».
    reason=[ForPrediction] 체크포인트에 없어 새로 지은 파라미터 445개 (예: …) —
           클래스가 체크포인트 세대와 맞는지 보라(TS_TTM_MODEL_CLASS)
설정 오류는 서버를 죽이지 않습니다 — 같은 프로세스가 이상탐지도 서비스하기 때문에, 예측 설정 하나로 무관한 기능까지 멈추지는 않습니다.
대신 /health 에 드러납니다. 응답의 models 에 모델별 적재 상태가 실리고, 하나라도 못
올라오면 status 가 degraded 입니다(HTTP 는 200). 컨테이너 헬스체크가 쓰는 /ping 은 두
모델이 다 실패했을 때만 503 입니다 — 예측만 죽었을 때 컨테이너가 재기동을 반복하지 않게 하기
위해서입니다.
"status": "degraded",
"models": {
  "tspulse": { "loaded": true,  "error": null },
  "ttm":     { "loaded": false, "error": "ModelConfigError: …" }
}
⚠ /health 에 models 항목이 없으면 그보다 이전 판입니다 — 그 판에서는 헬스체크가 정상으로
보이니, 아래 예측 요청과 기동 로그로 가리십시오. 이것도 판에 따라 다릅니다.
| 판 | 예측 요청 | 기동 로그 |
|---|---|---|
| 2026-09-21 이후 | HTTP 500 | [MODEL_WARMUP_FAIL] TTM ch=… 설정이 체크포인트와 맞지 않는다 — 이 설정으로는 모든 예측이 실패한다 |
| 그 이전 | HTTP 200 · model_used="NAIVE" | [MODEL_WARMUP_SKIP] TTM ch=… |
예전 판에서는 설정 오류도 단순 외삽으로 흡수돼 /health 정상 · 예측 200 · 모든 답이 조용히 단순 외삽인 채로 돌 수 있었습니다. 지금은 재시도해도 안 낫는 실패(설정)와 일시적 실패(데이터 부족 등)를 갈라, 앞쪽만 올려보냅니다.
🔴 둘 중 어느 판인지는 판 번호가 아니라 «로그 줄» 로 가리십시오. 이 달의 이미지 태그는
날짜까지 붙어 여러 번 다시 구워집니다(2026.09-<날짜>-<시각>) — 같은 2026.09 라도 판이 다릅니다.
값을 틀리게 적으면 기본값으로 조용히 떨어지지 않고 그 자리에서 거부합니다. 둘 중 하나입니다.
| 상황 | 로그에 나오는 말 |
|---|---|
| 아는 이름이 아님 | TS_TTM_MODEL_CLASS='…' 를 모른다 — ['ForDecomposedPrediction', 'ForPrediction'] 중 하나여야 한다 |
| 이름은 맞는데 라이브러리가 낮음 | … 를 골랐는데 이 tsfm_public 판에 그 클래스가 없다 (granite-tsfm 0.3.9 이상 필요) |
알람 심층 분석
| 도구 | 설명 |
|---|---|
get_alarm_stats | 알람 통계 요약 — 빈도, 우선순위 분포, Top 알람, Top 태그 |
analyze_alarm_duration | 알람 지속시간/MTTA 분석 — 열화 감지, 평균 인지 시간 추이 |
analyze_alarm_correlation | 알람-센서 상관관계 — 어떤 센서 변화가 알람을 유발하는지 |
설비 건강 지수
get_asset_health — 센서 + OEE + RAM + EMS + 알람을 종합하여 0~100점 건강 점수 산출
피처 스토어 (Feature Store)
사전 계산된 피처와 LLM 컨텍스트로 빠른 종합 분석을 제공합니다.
| 도구 | 설명 |
|---|---|
get_feature_status | 피처 스토어 상태 — 스케줄러 잡, 실행 시각, 백필 상태 |
get_asset_features | 설비 피처 조회 — 건강점수, 이상점수, 알람, 상태, 생산 지표 |
get_asset_context | LLM 컨텍스트 — 일별 종합 분석 요약 텍스트 (사전 생성) |
analyze_asset | 설비 종합 분석 — 건강점수, 센서, 알람, OEE/RAM/EMS, 원인 힌트 |
explain_asset_anomaly | 이상 원인 분석 — 이상 태그, 알람, 상태 변화 기반 원인 추정 |
trigger_feature_pipeline | 피처 파이프라인 수동 실행 |
피처 스토어 아키텍처:
- 스케줄러: 시간별(hourly), 일별(daily) 자동 피처 계산
- 임베딩: 설비 피처를 벡터로 변환하여 유사도 검색 지원
- LLM 컨텍스트: 일별 종합 분석 텍스트를 사전 생성하여 응답 속도 극대화
MCP 리소스 (6개)
| 리소스 URI | 설명 |
|---|---|
plantpulse://system/info | 시스템 정보 |
plantpulse://domains | 도메인 목록 및 API 엔드포인트 |
plantpulse://metrics/oee | OEE 메트릭 설명 |
plantpulse://metrics/ram | RAM 메트릭 설명 |
plantpulse://metrics/ems | EMS 메트릭 설명 |
plantpulse://metrics/alarm | 알람 메트릭 및 분석 역량 |
발견 · 주의 · 생산 (2026.10)
엔진이 스스로 적어 둔 것을 읽고, 생산 쪽 질문에 답하는 도구입니다. 채팅에서는 insight_
접두어가 붙어 보입니다.
| 도구 | 설명 |
|---|---|
list_findings | AI 가 스스로 찾아 둔 발견 — 설비 이상 · 오더 목표 미달 · 데이터 끊김 · 데이터 품질 · 연쇄 정지 · 고장 위험 · 한계치 도달 · 전력 피크 · AI 설정 변경 등. 심각도 · 급함 · 근거 사실 · 상태 |
get_attention_ranking | 사이트별 「오늘 먼저 볼 설비」 순위 — 주의 점수(0~100)와 이유 셋, 어제 대비 순위 변화 |
forecast_order_completion | 진행 중 워크오더가 계획 종료까지 목표 수량에 닿는지 — 예상 양품(P10~P90) · 도달 확률 · 부족 수량 |
get_oee_losses | OEE 가 왜 낮은지 — 가동률 · 성능 · 품질 손실 시간, 6대 손실, 정지 원인 |
get_spc_chart | 설비 · 제품의 불량률 관리도(p 관리도) — 중심선 · 관리 한계 · 이상 신호 |
autonomy_status | AI 가 스스로 하는 개선(정상 기준선 · 점수기)의 지금 상태 — 모드 · 사용 중 버전 · 그림자 · 일시정지 |
2026.10 재릴리즈(2026-10-20) 부터 list_findings · get_attention_ranking 은 처음부터 켜져 있어 「오늘 먼저 볼 설비는?」 · 「열린 발견 정리해 줘」 에 바로 답합니다.
forecast_order_completion · get_oee_losses · get_spc_chart · autonomy_status 넷은 꺼진 채 들어오므로, 묻기에서 쓰려면 관리자가
AI 관리 콘솔 › MCP 게이트웨이 › 도구 에서 켭니다 → MCP 게이트웨이
설비·태그 이해
설비에 태그가 수천 개씩 달려 있으면 어느 것이 무엇인지 사람이 다 설명할 수 없습니다. 아래 도구는 실데이터 통계와 플랫폼 메타데이터로 태그의 성격을 자동 정리합니다.
| 도구 | 설명 |
|---|---|
list_asset_tags | 설비의 태그 목록 |
get_asset_profile | 설비 프로파일 — 어떤 태그가 어떤 성격인지 정리 |
get_asset_tag_relations | 태그 사이 상관관계 — 함께 움직이는 태그 묶기 |
사례 검색·비교
| 도구 | 설명 |
|---|---|
find_similar_assets | 유사 설비 검색 — 벡터 임베딩 코사인 유사도 기반 |
find_similar_anomalies | 유사 이상 사례 검색 — 과거에 같은 모양의 이상이 있었는지 |
find_fleet_outlier | 플릿 이상치 — 같은 종류 설비 중 혼자 다르게 움직이는 것 |
search_pattern | 패턴 검색 — 지정한 파형과 닮은 구간 찾기 |
check_failure_precursor | 고장 전조 점검 — 고장 전에 나타나던 신호가 지금 보이는지 |
활용 시나리오
| 시나리오 | 활용 도구 |
|---|---|
| 설비 이상 조기 감지 | detect_asset_anomaly → explain_asset_anomaly |
| 예지 정비 계획 | get_asset_health → forecast_asset → forecast_ram |
| 일별 설비 브리핑 | get_asset_context → get_asset_features |
| 알람 폭주 원인 분석 | get_alarm_stats → analyze_alarm_correlation → analyze_alarm_duration |
| 유사 설비 비교 분석 | analyze_asset → find_similar_assets |
| 이 이상, 전에도 있었나 | detect_asset_anomaly → find_similar_anomalies |
| 고장 나기 전에 잡기 | check_failure_precursor → forecast_ram |
| 같은 설비인데 하나만 이상 | find_fleet_outlier → analyze_asset |
| 에너지 이상 감지 | detect_ems_anomaly → forecast_ems |
| 생산 품질 예측 | detect_order_anomaly → forecast_order |
| 이 오더 제시간에 끝나나 | forecast_order_completion → get_oee_losses |
| 오늘 어디부터 봐야 하나 | get_attention_ranking → list_findings |