TimeSeries-Insight (AI 分析引擎)
概述
PlantPulse TimeSeries-Insight 是专为制造时序数据打造的 AI 异常检测、预测与综合分析 MCP 服务器。
它基于 IBM Granite TSPulse(异常检测)与 TinyTimeMixer TTM(预测)AI 模型,为传感器数据、OEE、RAM、EMS、报警、工单等工厂全部时序数据提供智能分析。
通过 39 个分析工具与特征存储,支持从实时分析到预先计算的综合洞察。自 2026.10 起,引擎不再等待被工具调用,而是自行发现问题并记录为«发现»,由副驾驶接收后通知人员 → AI 发现与准确度
insight-api(:8970)负责工具与数据,模型推理(TSPulse·TTM)则委托给
insight-server(:8980)。GPU 仅推理侧需要,因此两个服务可部署在不同
设备上。
在副驾驶中查看异常检测的位置
引擎发现的设备异常会以待确认异常的形式出现在副驾驶的建议 › 待办 › 突发中。每台设备一行,点击该行可在 详情中查看趋势线 · 相关标签 · 依据,并决定升级为事件或忽略(填写原因)→ 建议
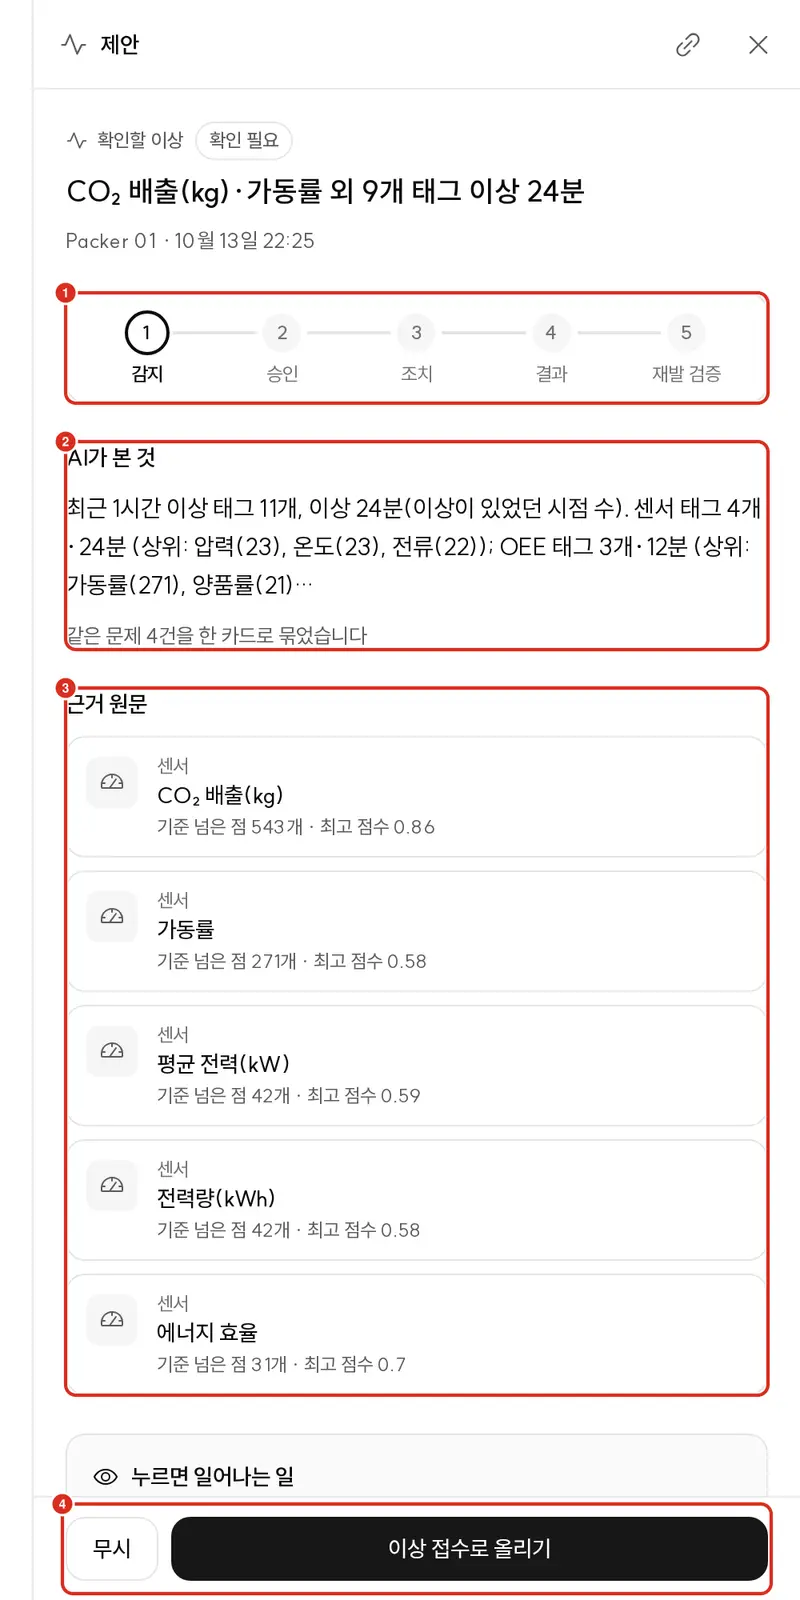
以往的«异常诊断»菜单及其中的«运维控制台»已被移除,相关工作改在建议 › 突发中完成(旧地址 /anomaly 不会跳转)。
| 以往在运维控制台中的操作 | 现在 |
|---|---|
| 浏览 · 确认异常列表 | 建议 › 待办 › 突发。按紧急程度排列 |
| 标记是否准确(AI 判定) | 若为误报,在忽略中选择原因 → AI 发现与准确度 |
| 全量扫描 · 定向«执行»按钮 | 没有按钮。服务器按周期自动运行 — 见下 |
| 设备时间线 | 在已连接数字主线的部署中,提问「按时间顺序显示这台设备最近发生的事」 |
检测按两种周期运行
| 检测对象 | 时机(默认) | |
|---|---|---|
| 全量扫描 | 全部设备 | 每 2 小时 |
| 定向检测 | 仅近期出现报警的设备 | 每 10 分钟 |
周期 · 严重度标准 · 通知渠道见 异常检测 · 事件响应。
按设备暂停通知的功能(静音)和«噪声 Top10»在新界面中已不存在。
新接入的设备或长期停机的设备,在为各标签建立基线之前不会产生异常分数。 在此期间即使存在异常,也不会上报为待确认异常 → AI 发现与准确度 — 学习中 · 无法判定
AI 异常检测 (Anomaly Detection)
基础模型: IBM Granite TSPulse
| 对象 | 工具 | 分析内容 |
|---|---|---|
| 设备传感器 | detect_asset_anomaly | 检测温度、压力、振动等传感器异常模式 |
| 系统资源 | detect_system_anomaly | 检测 CPU、内存、磁盘异常 |
| OEE | detect_oee_anomaly | 时间开动率、性能、质量异常模式 |
| RAM | detect_ram_anomaly | MTBF、MTTR 异常模式 |
| EMS | detect_ems_anomaly | 能耗、电力、碳排放异常 |
| 工单 | detect_order_anomaly | 生产质量异常 (OEE/RAM/EMS/复合) |
| 报警 | detect_alarm_anomaly | 报警频次异常模式 |
主要参数:
threshold— 异常判定阈值。设备传感器(detect_asset_anomaly)是针对校正分数的取值,默认为 5.0 — 🔴0并非«自动»,而是几乎把所有点都算作异常top_k— 返回的高位异常指标数量lookback_minutes— 分析时间范围target_columns— 分析对象(未指定时自动查询全部传感器)
设备传感器的异常分数(score_scale: calibrated)以分析窗口紧邻之前的区间为基准,
衡量重构误差相对该区间典型波动(中位数 · MAD)偏离了多少倍(稳健 z 值)。
0 表示«平时»,5 为默认阈值。
- 状态标签(如运行/停止之类的值)不参与评分。
- 计数器标签(如累计产量)不按累计值,而按 5 间隔增量的均值来看 — 以便捕捉生产 停止时增量跌至 0 的情况。
- 由模型首个窗口复制而来的前段区间不计入评分。
- 聚合 · 平滑窗口在传感器基准下为 8 / 4(
aggr_win_size·smoothing_window_size)。 以往的 32 / 16 会把分数抹平近 30 分钟,从而漏掉短时停机。
OEE · RAM · EMS 等领域侧的分数仍是每次调用归一到 0~1 的值 — 即使 threshold
相同,量纲也不同。
AI 预测 (Forecasting)
基础模型: TinyTimeMixer — Granite-TTM R3 (512-96-dec-512-r3,上下文 512 · 预测 96)
| 对象 | 工具 | 预测内容 |
|---|---|---|
| 设备传感器 | forecast_asset | 传感器值未来趋势 |
| 系统资源 | forecast_system | CPU/内存/磁盘使用率 |
| OEE | forecast_oee | 时间开动率、性能、质量未来走势 |
| RAM | forecast_ram | 设备可靠性指标未来趋势 |
| EMS | forecast_ems | 能耗、碳排放展望 |
| 工单 | forecast_order | 生产质量未来走势 |
| 报警 | forecast_alarm | 报警频次趋势、故障预测 |
主要参数:
prediction_length— 预测步数enable_bounds— 输出置信区间(上限/下限)
请查看响应中的 model_used — 返回 200 不代表来自 TTM
预测响应会同时说明结果由什么生成。
| 值 | 含义 |
|---|---|
TTM | 由已训练模型生成 |
NAIVE | 数据不足,由 drift · seasonal-naive 生成。fallback_reason 中会给出原因 |
NAIVE 同样返回 HTTP 200仅在数据不足时,引擎不会抛出失败,而是降级为简单外推。 调用方若只看 200,就会在「TTM 预测」的位置看到简单外推结果。
因此请读取并记录 model_used。 NAIVE 增多本身就是信号。
连简单外推也无法给出值的列不会用 0 填充,而是记入 dropped_columns 并剔除。若所有列
都被剔除,则返回 422。
其他失败不会被吸收 — 因为重试也无济于事,或者本就不该被隐藏。
| 情形 | 响应 |
|---|---|
| 致命 CUDA 错误(GPU 宕机)· 推理队列已满 | 503 + Retry-After |
| 模型配置错误(见下)· 权重加载失败 · 代码缺陷 | 500 |
若请求了置信区间(enable_bounds)却未返回,bounds_reason 会说明原因 —
在这里区分「这台设备无法给出区间」与「发送的数据不足」。
TS_TTM_MODEL_CLASS — 用于匹配检查点世代与加载器的配置
预测模型(TTM)依世代不同,读取的类也不同。 通过 insight-server 的一个环境变量来选择(该配置加入于 2026-09-21 之后的版本 — 更早版本没有该配置,固定为 ForPrediction)。
| 值 | 适用场景 |
|---|---|
| 留空(默认值) | 由检查点的 config.json(decompose)决定 — 通常保持此设置 |
ForPrediction | TTM R2 检查点 |
ForDecomposedPrediction | Granite-TTM R3(分解预测)检查点 |
镜像内置的默认模型为 R3。R2 也以 model/ttm-r2 一并打包,回退时无需改动
类,只需改一行路径。
TS_TTM_DIR=/app/model/ttm-r2 # R2 로 되돌리기 — 클래스는 그 디렉터리의 config 가 정합니다
R2 与 R3 的权重键完全不重叠,却仍会毫无异常地互相读取对方的检查点。若放任不管,就会生成445 个参数全部重新随机初始化的模型,并顶着 model_used="TTM" 的名号给出答案。
现在,加载时只要存在检查点中不存在、需要新建的参数,就会拒绝加载。日志中会留下如下记录。
[MODEL_LOAD] TTM dir=… , class=ForPrediction, in_channels=…
[MODEL_LOAD_FAIL] TTM dir=… — 학습된 가중치를 못 읽었다. 무작위 초기화 모델로 대체하지 «않는다».
    reason=[ForPrediction] 체크포인트에 없어 새로 지은 파라미터 445개 (예: …) —
           클래스가 체크포인트 세대와 맞는지 보라(TS_TTM_MODEL_CLASS)
配置错误不会让服务器宕掉 — 因为同一进程也在提供异常检测服务,不能因一个预测配置就让无关功能停摆。
取而代之的是体现在 /health 上。 响应的 models 中会携带各模型的加载状态,只要有一个未能
加载,status 即为 degraded(HTTP 仍为 200)。容器健康检查所使用的 /ping 仅在两个
模型都失败时才返回 503 — 这是为了避免仅预测功能失效时容器反复重启。
"status": "degraded",
"models": {
  "tspulse": { "loaded": true,  "error": null },
  "ttm":     { "loaded": false, "error": "ModelConfigError: …" }
}
⚠ 若 /health 中没有 models 项,说明是更早的版本 — 在该版本中健康检查看起来正常,
请改用下面的预测请求与启动日志来判别。这同样因版本而异。
| 版本 | 预测请求 | 启动日志 |
|---|---|---|
| 2026-09-21 之后 | HTTP 500 | [MODEL_WARMUP_FAIL] TTM ch=… 설정이 체크포인트와 맞지 않는다 — 이 설정으로는 모든 예측이 실패한다 |
| 更早 | HTTP 200 · model_used="NAIVE" | [MODEL_WARMUP_SKIP] TTM ch=… |
在旧版本中,配置错误也会被简单外推吸收,从而出现 /health 正常 · 预测 200 · 所有答案悄悄变成简单外推的运行状态。现在会区分重试也无法恢复的失败(配置)与临时性失败(数据不足等),只把前者上报。
🔴 要判别属于哪个版本,请依据«日志行»而非版本号。 当月的镜像标签带到日期,并会多次重新构建(2026.09-<date>-<시각>)— 即便 2026.09 相同,版本也可能不同。
若取值填错,不会悄悄回落到默认值,而是当场拒绝。分为两种情况。
| 情形 | 日志中的提示 |
|---|---|
| 不是已知名称 | TS_TTM_MODEL_CLASS='…' 를 모른다 — ['ForDecomposedPrediction', 'ForPrediction'] 중 하나여야 한다 |
| 名称正确但库版本过低 | … 를 골랐는데 이 tsfm_public 판에 그 클래스가 없다 (granite-tsfm 0.3.9 이상 필요) |
报警深度分析
| 工具 | 说明 |
|---|---|
get_alarm_stats | 报警统计摘要 — 频次、优先级分布、Top 报警、Top 标签 |
analyze_alarm_duration | 报警持续时间/MTTA 分析 — 劣化检测、平均确认时间走势 |
analyze_alarm_correlation | 报警-传感器相关性 — 哪些传感器变化会触发报警 |
设备健康指数
get_asset_health — 综合传感器 + OEE + RAM + EMS + 报警,计算 0~100 分健康分数
特征存储 (Feature Store)
通过预先计算的特征与 LLM 上下文提供快速综合分析。
| 工具 | 说明 |
|---|---|
get_feature_status | 特征存储状态 — 调度器作业、执行时刻、回填状态 |
get_asset_features | 设备特征查询 — 健康分数、异常分数、报警、状态、生产指标 |
get_asset_context | LLM 上下文 — 按日综合分析摘要文本(预先生成) |
analyze_asset | 设备综合分析 — 健康分数、传感器、报警、OEE/RAM/EMS、原因提示 |
explain_asset_anomaly | 异常原因分析 — 基于异常标签、报警、状态变化推断原因 |
trigger_feature_pipeline | 手动执行特征流水线 |
特征存储架构:
- 调度器: 按小时(hourly)、按日(daily)自动计算特征
- 嵌入: 将设备特征转换为向量,支持相似度检索
- LLM 上下文: 预先生成按日综合分析文本,最大化响应速度
MCP 资源 (6 个)
| 资源 URI | 说明 |
|---|---|
plantpulse://system/info | 系统信息 |
plantpulse://domains | 域列表及 API 端点 |
plantpulse://metrics/oee | OEE 指标说明 |
plantpulse://metrics/ram | RAM 指标说明 |
plantpulse://metrics/ems | EMS 指标说明 |
plantpulse://metrics/alarm | 报警指标及分析能力 |
发现 · 关注 · 生产 (2026.10)
用于读取引擎自行记录的内容,并回答生产侧问题的工具。在聊天中会带有 insight_
前缀显示。
| 工具 | 说明 |
|---|---|
list_findings | AI 自行发现并记录的发现 — 设备异常 · 工单目标未达成 · 数据中断 · 数据质量 · 连锁停机 · 故障风险 · 触及限值 · 电力峰值 · AI 配置变更等。含严重度 · 紧急度 · 依据事实 · 状态 |
get_attention_ranking | 各站点的**「今天优先查看的设备」**排名 — 关注分数(0~100)与三条理由、相对昨日的排名变化 |
forecast_order_completion | 进行中的工单到计划结束时是否能达到目标数量 — 预计良品(P10~P90)· 达成概率 · 缺口数量 |
get_oee_losses | OEE 为何偏低 — 时间开动率 · 性能 · 质量损失时间、六大损失、停机原因 |
get_spc_chart | 设备 · 产品的不良率控制图(p 控制图)— 中心线 · 控制限 · 异常信号 |
autonomy_status | AI 自主改进(正常基线 · 评分器)的当前状态 — 模式 · 使用中的版本 · 影子 · 暂停 |
自 2026.10 再发布(2026-10-20) 起,list_findings · get_attention_ranking 初始即开启,因此「今天优先查看哪些设备?」· 「整理一下未关闭的发现」可以直接作答。
forecast_order_completion · get_oee_losses · get_spc_chart · autonomy_status 四个以关闭状态加入,若要在提问中使用,需由管理员在
AI 管理控制台 › MCP 网关 › 工具 中开启 → MCP 网关
设备·标签理解
当一台设备挂有成千上万个标签时,人无法逐一说明其含义。下列工具会基于实际数据统计与平台元数据,自动梳理标签的性质。
| 工具 | 说明 |
|---|---|
list_asset_tags | 设备的标签列表 |
get_asset_profile | 设备画像 — 梳理哪些标签具有何种性质 |
get_asset_tag_relations | 标签间相关性 — 将同步变化的标签归为一组 |
案例检索·对比
| 工具 | 说明 |
|---|---|
find_similar_assets | 相似设备检索 — 基于向量嵌入余弦相似度 |
find_similar_anomalies | 相似异常案例检索 — 过去是否出现过同样形态的异常 |
find_fleet_outlier | 机群离群 — 同类设备中唯独表现不同的那台 |
search_pattern | 模式检索 — 查找与指定波形相似的区间 |
check_failure_precursor | 故障前兆巡检 — 故障前曾出现的信号当前是否可见 |
应用场景
| 场景 | 使用工具 |
|---|---|
| 设备异常早期发现 | detect_asset_anomaly → explain_asset_anomaly |
| 预知维护计划 | get_asset_health → forecast_asset → forecast_ram |
| 每日设备简报 | get_asset_context → get_asset_features |
| 报警风暴原因分析 | get_alarm_stats → analyze_alarm_correlation → analyze_alarm_duration |
| 相似设备对比分析 | analyze_asset → find_similar_assets |
| 这种异常以前是否出现过 | detect_asset_anomaly → find_similar_anomalies |
| 在故障发生前抓住它 | check_failure_precursor → forecast_ram |
| 同型设备中仅有一台异常 | find_fleet_outlier → analyze_asset |
| 能源异常检测 | detect_ems_anomaly → forecast_ems |
| 生产质量预测 | detect_order_anomaly → forecast_order |
| 这个工单能否按时完成 | forecast_order_completion → get_oee_losses |
| 今天应从哪里看起 | get_attention_ranking → list_findings |