高可用性 (HA) 配置
将两台边缘设备连接到同一台 PLC,这样即使一台故障,数据采集也不会中断。
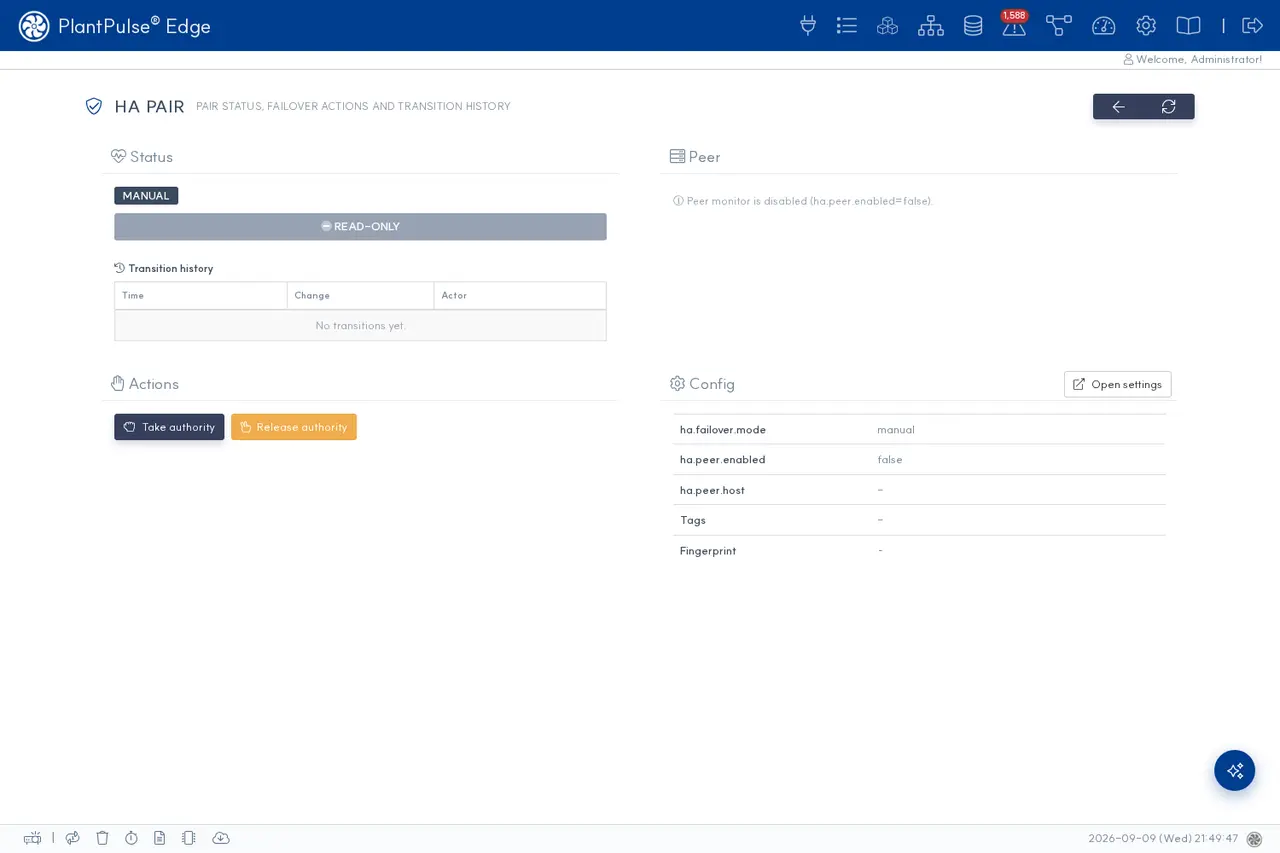
界面在左侧菜单的 HA PAIR (/ui/ha) 中。
要实现什么高可用性 — 读两个,写一个
| 如何处理 | |
|---|---|
| 读取(采集) | 两台边缘设备各自独立地读取同一台 PLC。互不依赖 |
| 写入(控制) | 仅一台执行。由 edge.plc.write_authority 决定哪台 |
读取重叠没有损失,但写入则不同。 如果两台边缘设备同时持有写入权限, 同一命令会发送两次到 PLC(脑裂)。整个架构就是为阻止这种情况而设计的。
edge.plc.write_authority 的默认值是 true — 如果没有配置,意味着该节点是唯一
的写入主体,因此只有一台边缘设备的现场无需额外操作即可正常工作。
界面阅读指南
| 位置 | 内容 |
|---|---|
| 模式徽章 | MANUAL / AUTO — ha.failover.mode |
| 权限条 | 此边缘设备当前是否为写入负责者。如果是 READ-ONLY 则不是 |
| 切换历史 | 何时 · 什么发生了变化 · 谁操作了 |
| 操作 | 根据模式不同(见下文) |
| 对端 | 对侧边缘设备的状态。如果是 ha.peer.enabled=false 则为空 |
| 配置 | ha.failover.mode · ha.peer.enabled · ha.peer.host · 标签 · 指纹 |
标签指纹 (Fingerprint)
通过一个值比较两台边缘设备是否具有相同的标签定义。如果不一致,
界面会通过 TAG DRIFT 提示 — 表示只在一侧添加了标签而忽略了另一侧,
如果此时进行故障转移,切换过去的一方将无法采集部分标签数据。
两种模式
manual — 操作员手动切换(默认)
- 操作:
Take authority(获取) ·Release authority(释放) - 对端监视器会监控对侧边缘设备,但不会自动切换。
对端监视器(HaPeerMonitor)会每 10 秒轮询(首次轮询在启动后 15 秒)
对侧边缘设备的 GET /api/v1/ha/status,以显示状态并留下警告日志。
任何情况下都不更改配置。
如果把网络短暂中断误判为“对端已宕机”并进行升级,就会出现双方同时写入的
状态。因此在 manual 下只做到显示和告警,升级由人来完成。
自动升级由 auto 模式完成,它依据的是PLC心跳,而不是边缘之间的网络(见下文)。
auto — 通过PLC心跳自动升级
启用条件:ha.failover.mode=auto,且 ha.failover.heartbeat_opc ·
ha.failover.heartbeat_address 两者都已设置。只要有一个为空,就会在日志中留下
以下警告,并且不进行自动变更(与 manual 相同地运行)。
HA auto-failover degraded to manual — ha.failover.heartbeat_opc/address not set.
判定规则
| 情况 | 做什么 |
|---|---|
| 写入负责方(WRITER) | 每隔 heartbeat_interval_ms 向PLC心跳地址写入包含自身 writer_id 的值 |
待机方(STANDBY)看到的心跳值在 takeover_timeout_ms 内没有变化 | 自行升级为WRITER |
| 心跳读取本身失败 | 不视为“停止”——无法观测不等于已死亡,因此不升级 |
| 其他WRITER的心跳仍然活跃 | 不升级 |
| 两台同时声称是WRITER | writer_id 较低的一方获胜,较高的一方退让 |
| WRITER 连续写入心跳失败 | 达到 max(3, ceil(timeout ÷ interval)) 次后自行降为STANDBY——默认值下为 ceil(2000 ÷ 500) = 4次 |
| 启动 | 无论配置如何,始终以STANDBY启动。如果没有WRITER在写心跳,会在 takeover_timeout_ms 后升级——只剩一台的边缘也会自行成为WRITER |
| 曾宕机的一方恢复 | 不会自动夺回权限(无自动回切) |
- 操作:
Force writer·Force standby·Clear override——叠加在上述自动判定之上的 手动强制。用Clear override解除后即恢复自动判定 (API 为PUT /api/v1/ha/failover/override)。
Force writer 强制,就是双重写入手动强制会跳过自动判定。如果把两台边缘都强制为WRITER,没有任何机制能阻止—— 强制由运维人员负责。
takeover_timeout_ms 的默认值2000来自这样的前提:“PLC直连,读取通常在100ms以内 → 正常
观测间隔约600ms”。
- 经由网关等读取较慢的现场,请调高
takeover_timeout_ms。 - 需要更快检测时,不是降低timeout,而是先缩短
heartbeat_interval_ms。 timeout 不能低于2000(填写更低的值也会被提升到2000)。 - 设得过短可能会出现短暂的双writer窗口。在下一次观测时会收敛到
writer_id较低的一方。
对端判定状态
| 状态 | 含义 | 需要做的操作 |
|---|---|---|
OK | 正常 — 仅一方持有写入权限 | — |
DOWN | 无法访问对端 | 检查对端是否真的故障,若故障则在本侧执行 Take authority |
DUAL_AUTHORITY | 双方都持有写入权限 | 立即在一侧执行 Release authority |
NO_AUTHORITY | 无人持有写入权限 | 在一侧执行 Take authority — 在此之前控制不会发出 |
+TAG_DRIFT | 标签定义不一致 | 对齐标签并确认指纹一致 |
配置
放入 /etc/kopens/app.properties(= app.properties 符号链接)并重启 →
app.properties 参考
| 键 | 含义 | 默认值 |
|---|---|---|
edge.plc.write_authority | 此边缘设备是否为写入负责者 | true |
ha.failover.mode | manual / auto | manual |
ha.peer.enabled | 启用对端监视器 | false |
ha.peer.host | 对侧边缘设备地址 | — |
ha.failover.heartbeat_opc | 用于写入和读取心跳的连接(OPC)id——auto 必填 | — |
ha.failover.heartbeat_address | PLC的心跳地址——auto 必填 | — |
ha.failover.heartbeat_address2 | 可选的镜像寄存器。留空则不使用 | (空) |
ha.failover.heartbeat_data_type | 心跳地址的数据类型 | DWord |
ha.failover.heartbeat_interval_ms | 心跳写入·观测周期(下限250) | 500 |
ha.failover.takeover_timeout_ms | 心跳在这段时间内无变化即升级(下限2000——更低的值会被提升到2000) | 2000 |
ha.failover.writer_id | 本边缘的心跳id。两台边缘设为不同的值——同时声称时较低的一方获胜 | 1 |
auto 模式不是让两台边缘直接互相确认,而是通过写入负责方向PLC的一个地址写入心跳的方式
来判定存活。即使边缘之间的网络中断,PLC也能看到双方,因此可以区分“彼此看不到”
和“真正宕机”两种情况。
API
供程序调用时使用。
| 路径 | 内容 |
|---|---|
GET /api/v1/ha/status | 当前状态 — 与对端监视器轮询的相同 |
PUT /api/v1/ha/write-authority | 获取 · 释放写入权限 |
PUT /api/v1/ha/failover/override | 强制指定 · 解除——仅限 auto 模式(否则为409 NOT_AUTO_MODE) |
POST /api/v1/ha/definitions | 将标签定义复制到对端 |
请求·响应格式见 REST API 的“冗余(HA)”一节。
现场部署时
- 将两台边缘设备连接到不同的交换机。如果连接到同一交换机,该交换机将成为 单点故障,高可用性便失去意义。
- 在两台边缘设备上配置相同的标签定义,并确认指纹一致。
- 仅在一台设备上设置
edge.plc.write_authority=true。 - 通过
ha.peer.enabled=true和ha.peer.host让双方互相可见。 如果要使用auto,请为两台边缘设置相同的heartbeat_opc·heartbeat_address和不同的writer_id。 - 如果与平台侧的高可用性一起使用 → 平台高可用性(HA)
高可用性是为了数据的可用性。设备的安全状态在任何软件故障下都 由 PLC / 安全 PLC(SIS) 独立保障。边缘设备或平台并非保障安全的主体。