高可用 (HA) 配置
将平台的两套(A·B) 并排部署,即使其中一套完全宕机,也能确保不丢失任何一条运营数据。此配置专为发电厂、大型工厂以及需要 24/365 不间断运行的设备而设计。
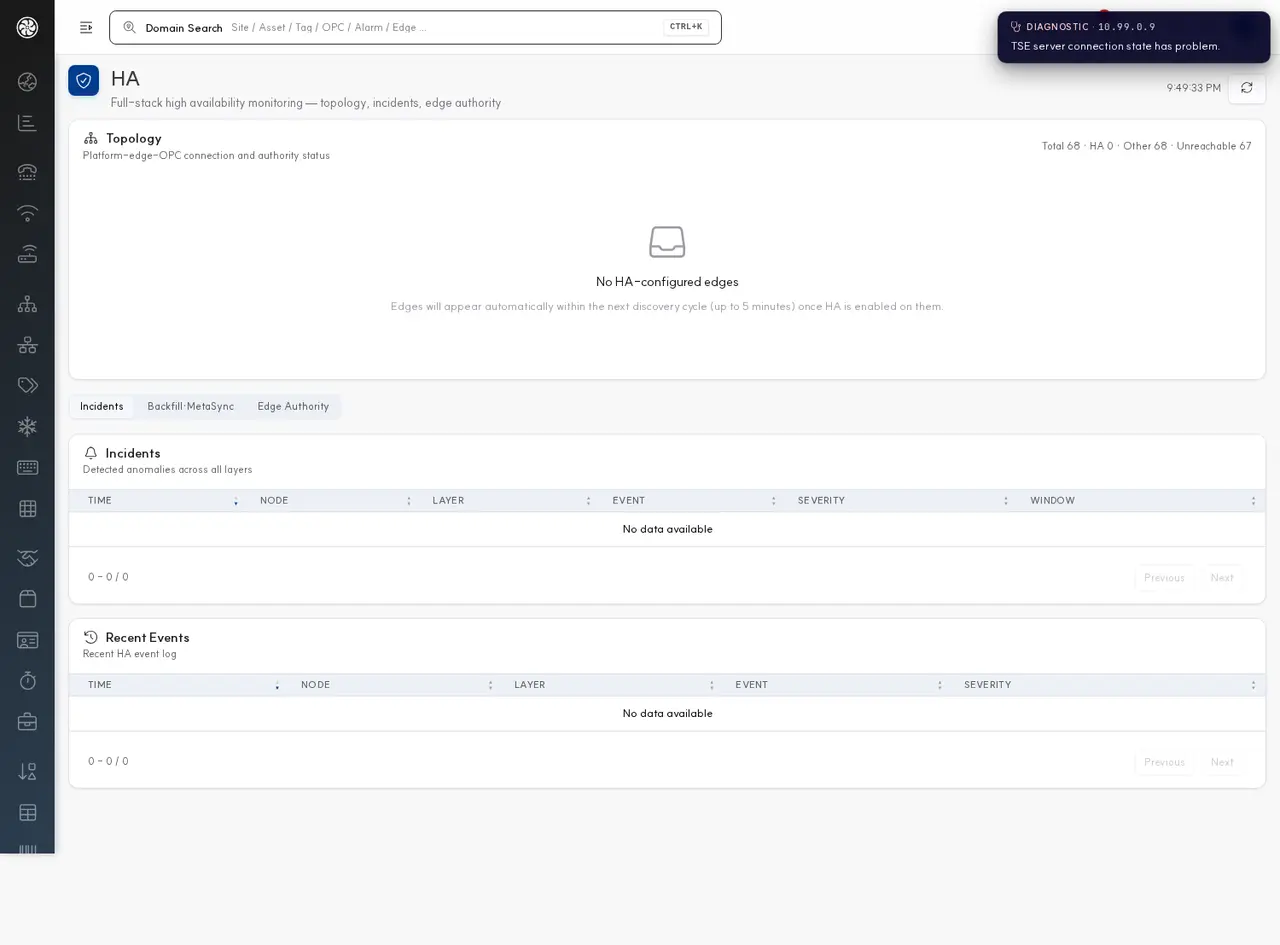
HA 负责数据的可用性、一致性、无丢失。设备的安全状态由 PLC / 安全PLC(SIS) 在任何软件故障下独立保证(IEC 61508 / 61511 SIL)。平台并非保障安全的责任主体。
两项承诺
1 · 数据不丢失
当一侧宕机时,另一侧会累积数据。恢复后,平台会只补回缺失的部分。它不计算或猜测时间——因为 Kafka 提交偏移量游标 精确知道已接收至何处。
2 · 控制指令只发往一处
控制指令与数据截然不同。它不会发送到两侧,而只发送到健康的单一领导者。如果权限所有者不明确,则不发送(故障关闭)。
连接被拒绝发生在发送前,因此可以安全地切换到另一侧。但是,超时 是一种“不确定是否已发送”的状态,因此不会重试——重试就意味着双重操作。
配置 — Edge-平台对
由两个 Edge 分别读取同一个 PLC,并发送到不同的平台。因此,两个平台都能实时收到相同的数据。
一个 PLC 由两个 Edge 独立采集,Edge #1 只发往 A,Edge #2 只发往 B。这不同于给一个平台连接两个 Edge —— 那是重复存储。
如果连接到同一交换机,该交换机将成为单点故障,使高可用失去意义 → Edge 高可用
平时不执行任何操作
plantpulse-ha 守护进程在每个平台上常驻运行,但在正常状态下不会代替传输流量。平时的数据供应由上述 Edge 对完成。守护进程仅在一侧宕机并恢复后才工作,此时执行两项操作。
| 执行的操作 | 内容 |
|---|---|
| 时序数据回填 | 订阅对端的 pp-batch 主题,当本地恢复后,仅重新发布宕机期间遗漏的数据段到本地 pp-batch。现有的 batch-web 会照常加载,因此无需修改目标端代码 |
| 主从元数据同步 | 对于标签元数据、资产结构、报警定义等不通过 Kafka 传输的配置,备用集群会从主集群的 PostgreSQL 每60秒拉取 一次 |
主从元数据同步也会迁移现场平板应用(frontline)的数据 — 作业员账户和负责范围(含 PIN 哈希)、亭模式设置 · 各设备停机原因列表 · 已注册的平板。AI 密钥仅在 metasync.include.tokens=true 时迁移,会话 · 审计日志 · 登录缓存在各节点分别保存(frontline 双机热备)。
event 而非 pp-batchpp-batch 是已经通过 CEP 处理之后的形式。因此,即使回放,目标端的 CEP 也不会再次触发。旧模型(event 主题的持续扇出)因 CEP 重触发和持续双重传输负载的原因已被废弃。
回填如何进行
INIT → GUARD → WAIT_LOCAL_READY → CATCH_UP → TAIL
                                     ↑          ↓
                                   PAUSED ←─────┘   (헬스 상실 / 회복)
| 状态 | 内容 |
|---|---|
GUARD | 如果对端与本地的 clusterId 相同,则拒绝启动 —— 防止误将自身视为对端 |
WAIT_LOCAL_READY | 等待本地 server-web 的健康状态稳定 |
CATCH_UP | 将边界时间 T_b 之前的数据段重新发布到本地 |
TAIL | T_b 之后的数据可能已被 Edge 写入本地,因此丢弃 |
PAUSED | 失去健康状态时停止且不提交偏移量 |
INCIDENT | 如果存在因超过保留期而无法读取的数据段,则记录日志并从 earliest 继续 |
切换依据是消费者滞后,而是「记录时间戳与固定边界 T_b」。如果在流量较少的分区上依据滞后判断,会导致误判和抖动。
在 TAIL 中,也执行延迟60秒提交(commit.lag.seconds)—— 这是为了让下一次 CATCH_UP 能自然地覆盖健康状态丢失前极短时间窗口内的数据。
循环在结构上已被阻止
重新发布的记录会带有 pp-ha-origin 头。带有该头的记录不会再被重新发布 —— 仅允许原始(h=0)→ 重发(h=1),h=1 即停止。
重复数据会被吸收
在边界附近,同一记录可能被发送两次,但 Aster TSDB 的重新加载是基于 tag_id + timestamp 的幂等操作,因此不会残留标签点丢失或重复。
保证与局限
如果宕机时间超过对端的 pp-batch 保留期,则超过部分无法自动恢复。该数据段会被记录到 INCIDENT,如需恢复,需通过 backfill.force.from 进行手动重新播放。请将保留期设置得比预期最大宕机时间更长。
| 局限 | 说明 |
|---|---|
| 统计计数器非幂等 | 标签点重新加载完全幂等,但 count = count + ? 形式的统计计数器在重复播放时可能会被过度计数 |
| 无法自行处理非对称故障 | 如果仅一个 Edge 宕机导致一侧供应中断,本地平台本身是健康的,因此健康网关无法检测到 → 需要手动重新播放 |
| 主从同步单向 | 仅为主 → 备。控制台配置请始终在主集群上更改 —— 在备集群更改,将在下个同步周期被覆盖 |
仅有一个 Edge 的站点 — 双传输客户端
在无法部署两个 Edge 的现场,采集器会直接向两个集群进行双重传输。
plantpulse-api-ha 提供与现有 APIClient 相同的接口,因此只需替换数据生成部分即可。
- 写入会扇出到所有目标并立即返回(每个目标有独立的队列、工作线程和退避策略)。
- 读取采用领导者优先 + 故障转移 + 粘性连接的方式。
- 拓扑信息通过每10秒轮询 HA 守护进程的
/api/cluster来缓存(last-known-good)。
运维
# 기동 · 정지 (각 플랫폼에서)
sh/start.sh [설정파일]     # 기본 config/plantpulse-ha.properties, 이미 떠 있으면 WARN + exit 0
sh/stop.sh                 # SIGTERM → 15초 대기 → SIGKILL
sh/log-viewer.sh
部署布局为 <서비스 루트>/plantpulse-ha/{sh,lib,logs,config,etc}。
发生故障时
| 情况 | 会发生什么 |
|---|---|
| 集群 B 宕机 | A 照常接收数据。B 恢复后,B 的守护进程会通过 CATCH_UP 读取仅存在于 A 上的数据段,并将其重新发布到 B → 数据收敛 |
| 仅守护进程宕机 | 提交偏移量不在守护进程,而在对端 Broker 中。重启后,会从最后一次提交的偏移量继续(需要重新通过健康网关) |
| 在主集群更改配置 | 备用集群会在下个周期(60秒)应用差异 |
相关文档
Edge 高可用 (HA) · 备份与恢复 · 集群安装