仪表板 (平台摘要 / 站点地图)
目录
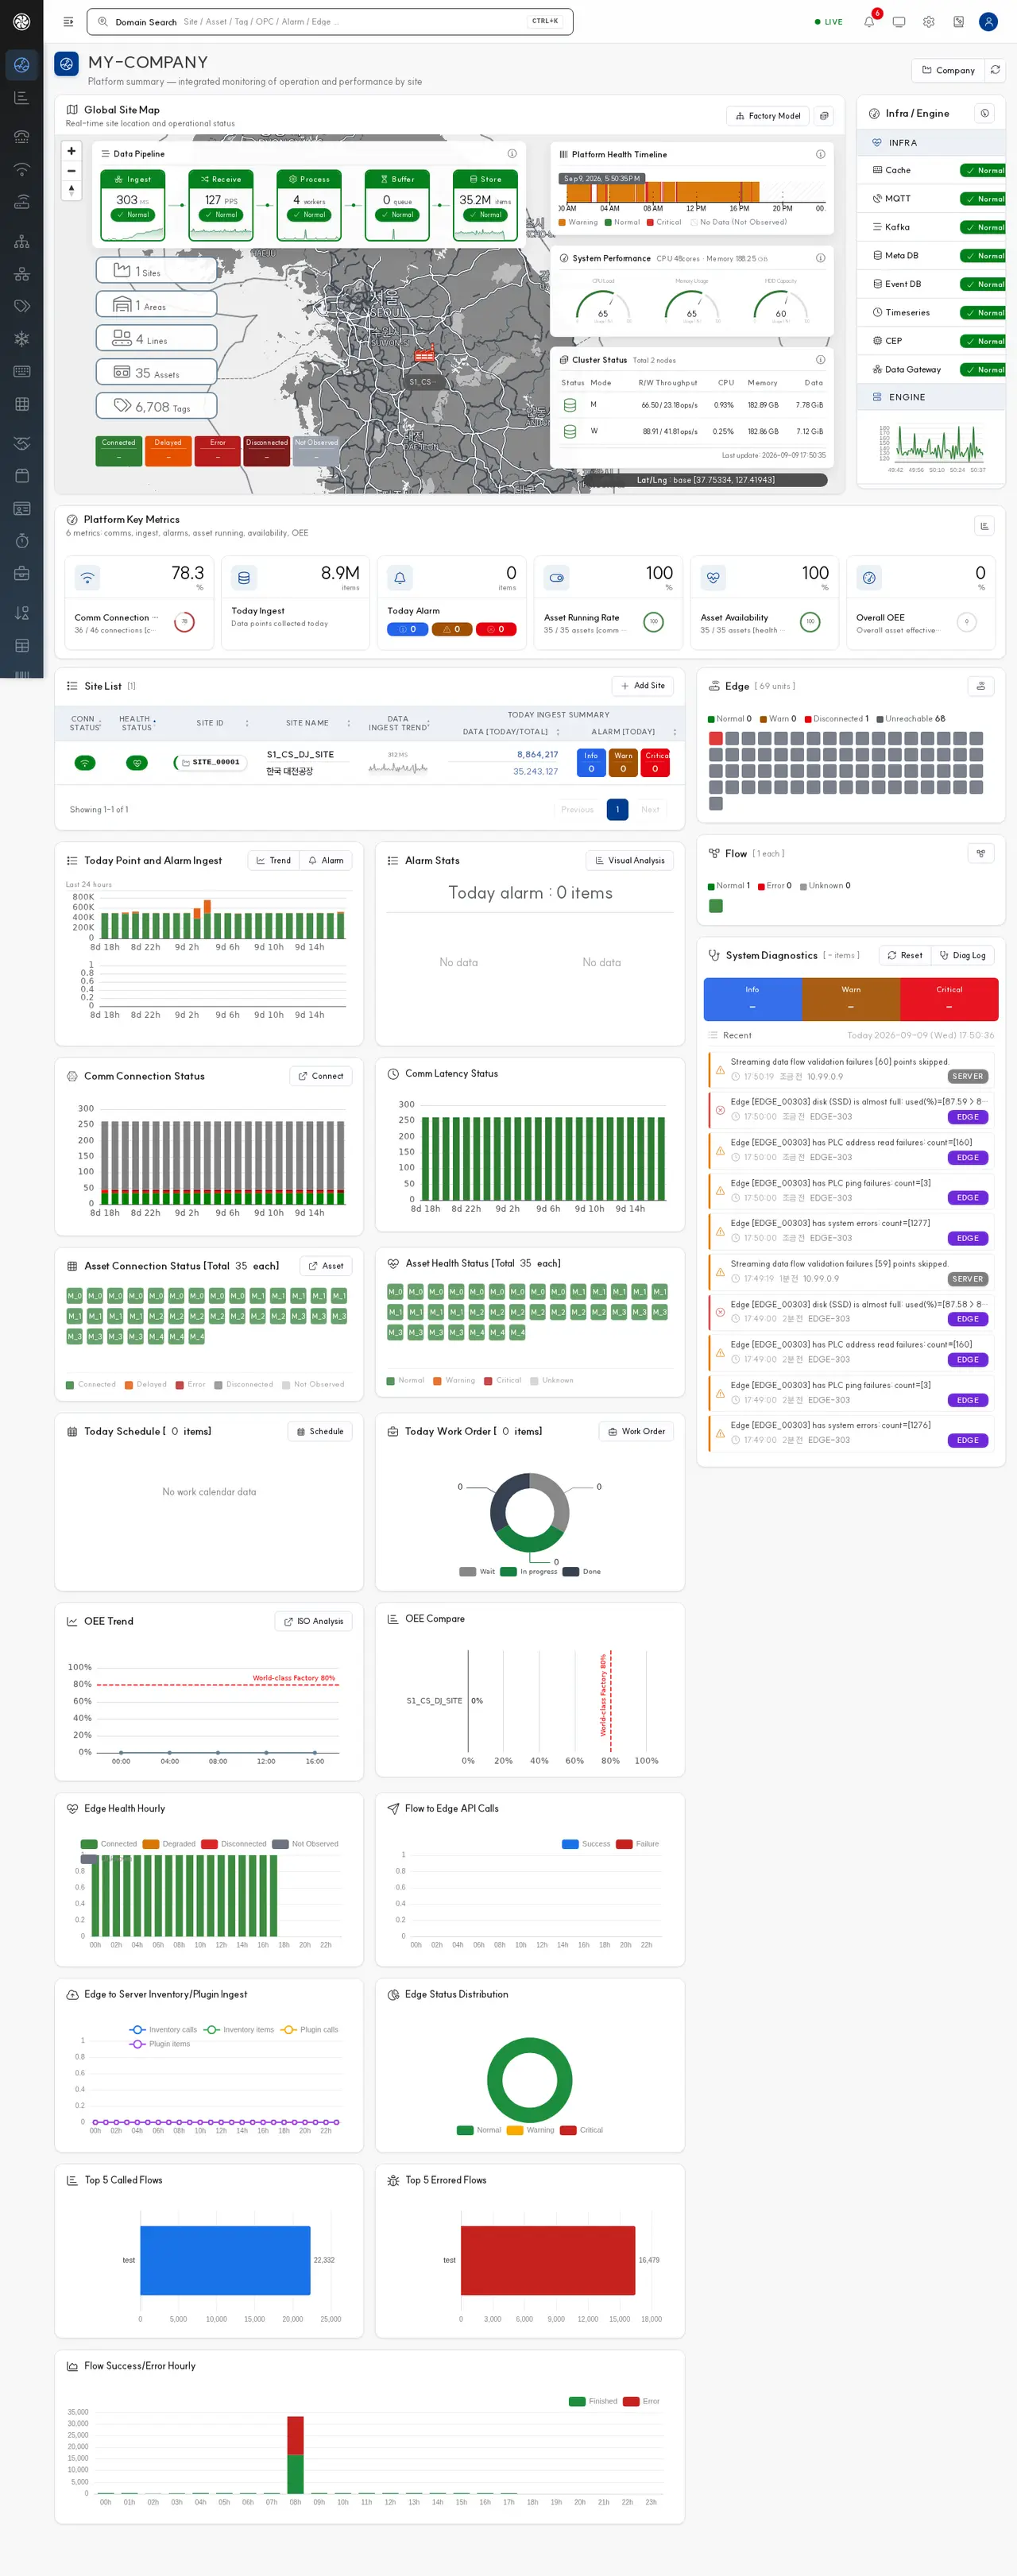
概览
仪表板是登录后首先确认的运维主页。在左侧菜单中显示为 OVERVIEW > 仪表板,内部 URL 为 /map/index。
该画面将站点地图、数据流水线、基础设施健康状况、集群状态及核心 KPI 汇总在同一画面中,使运维人员能够快速回答以下问题:
- 哪个站点或生产线出现了异常信号
- 数据采集、接收、处理、存储流水线是否阻塞
- 缓存、WS、MQTT、Kafka、事件数据库、时序引擎是否正常
- 今日采集量、报警、设备开工率、OEE 是否在常规范围内
在旧版文档中被称为“摘要”的首个画面,在当前 UI 中统一整理为 仪表板。URL 与之前相同,为
/map/index。
画面构成
┌────────────────────────────────────────────────────────────────────┐
│ 상단 바: 메뉴 토글 / 도메인 검색 / LIVE / 알람 / 전체화면 / 설정 / 매뉴얼 / 사용자 │
├────────────────────────────────────────────────────────────────────┤
│ 한국핵심산업                                                        │
│ 플랫폼 요약 - 사이트별 운영·성능 통합 모니터링                       │
├──────────────────────────────────────────────────────────┬─────────┤
│ 글로벌 사이트 맵                                         │ 우측     │
│  ┌ 데이터 파이프라인: 수집 → 수신 → 처리 → 버퍼 → 저장 ┐  │ 헬스     │
│  │ 사이트 마커 / 지도 확대·축소 / 좌표 표시              │  │ 레일     │
│  │ 사이트·구역·라인·설비·태그 카운트                    │  │         │
│  │ 연결 상태 칩: 정상·지연·이상·끊김·안됨                │  │         │
│  └────────────────────────────────────────────────────┘  │         │
├────────────────────────────────────────────────────────────────────┤
│ 플랫폼 핵심 지표: 통신 연결률 / 금일 수집 / 금일 알람 / 가동률 / 가용률 / OEE │
├────────────────────────────────────────────────────────────────────┤
│ 하단 위젯: 사이트 목록 / 포인트·알람 / OPC / 설비 / 생산 / 엣지 / 플로우 / 진단 │
└────────────────────────────────────────────────────────────────────┘
| 区域 | 显示内容 |
|---|---|
| 顶部页面页眉 | 企业名称、[企业设置] 按钮、“平台摘要 - 按站点综合监测运维与性能”说明 |
| 全局站点地图 | 站点位置、标记状态、地图操作、坐标显示 |
| 数据流水线 | 采集 → 接收 → 处理 → 缓冲 → 存储各阶段的吞吐量与状态 |
| 站点规模摘要 | 站点、区域、生产线、设备、标签数量 |
| 连接状态摘要 | 正常连接、连接延迟、连接异常、连接断开、未连接计数 |
| 右侧健康栏 | 平台健康时间线、系统性能、集群状态、基础设施/引擎状态 |
| 核心 KPI | 通信连接率、今日采集、今日报警、设备开工率、设备可用率、综合 OEE |
| 底部运维组件 | 站点列表、数据点·报警趋势、OPC/设备状态、生产计划·工作单、Edge·流·诊断 |
顶部页面页眉
正文顶部大幅显示企业名称。企业是设备层级的最高层,且每个安装实例仅对应一个。
| 项目 | 说明 |
|---|---|
| 企业名称 | 例:한국핵심산업 |
| 企业设置 | 打开可修改企业名称、法人信息、国家、时区、Logo 等的窗口 |
| 辅助说明 | 플랫폼 요약 - 사이트별 운영·성능 통합 모니터링 |
| 实时通知 | 设备状态变更、诊断事件等以 Toast 形式显示在右上角 |
关于顶部的全局搜索与通知使用方法,请参考 控制台导航与公共画面。
全局站点地图
地图同时显示已注册站点的位置和运行状态。站点标记以工厂图标表示,标记标签显示站点 ID 或简称。
地图操作
| 动作 | 方法 |
|---|---|
| 放大/缩小 | 地图左侧 + / - 按钮或鼠标滚轮 |
| 移动 | 拖动地图 |
| 确认站点 | 点击站点标记 |
| 确认坐标 | 地图底部显示的经纬度 |
标记解读
| 状态 | 含义 | 下一步确认 |
|---|---|---|
| 正常 | 站点的主要连接与数据流入正常 | 仅确认 KPI 与采集量 |
| 注意 | 部分连接延迟或设备警告 | 连接状态, 报警 |
| 异常 | 连接异常·严重报警·数据骤减可能 | 诊断, Edge 网关 |
| 未确认 | 坐标或采集记录不足 | 工厂管理, 数据点 |
数据流水线卡片
地图上方以卡片形式显示平台的数据处理流。
수집 ─→ 수신 ─→ 처리 ─→ 버퍼 ─→ 저장
| 阶段 | 代表指标 | 正常解读 |
|---|---|---|
| 采集 | Hz | 现场采集环路是否运行 |
| 接收 | PPS | 服务器每秒接收的数据点数 |
| 处理 | 工作线程数 | 流水线 Worker 是否正常运行 |
| 缓冲 | 等待队列 | 队列是否无积压 |
| 存储 | 存储记录数 | 时序·事件存储是否在累积 |
每个卡片底部的微型折线图显示近期变化趋势。如果数值掉至 0 或仅缓冲持续增加,则怀疑为数据流入或存储瓶颈。
站点规模·连接状态摘要
地图左下方汇总当前模型规模与连接状态。
模型规模
| 项目 | 含义 |
|---|---|
| 站点 | 注册的工厂或营业场所数量 |
| 区域 | 站点下属的运行区域数量 |
| 生产线 | 生产线数量 |
| 设备 | 注册的设备数量 |
| 标签 | 采集·计算·状态标签数量 |
如果模型规模与预期值不符,请在 工厂管理 中确认站点、资产、标签的注册状态。
连接状态芯片
| 芯片 | 含义 | 优先级 |
|---|---|---|
| 正常连接 | 最近数据接收正常 | 参考 |
| 连接延迟 | 发生接收延迟 | 确认当日趋势 |
| 连接异常 | 超过基准时间未接收或出错 | 立即巡检 |
| 连接断开 | 长时间未接收 | 确认现场·Edge·网络 |
| 未连接 | 尚无接收记录 | 确认注册·试运行状态 |
具体状态标准请参考 状态代码定义。
右侧健康栏
仪表板右侧栏快速显示平台自身的健康状态。运维人员以此区分站点异常与系统异常。
平台健康时间线
| 项目 | 说明 |
|---|---|
| 最近时间 | 最后一次统计时间 |
| 彩色时间线 | 分时间段的正常·注意·异常状态 |
| 用途 | 确认特定时间段系统状态是否波动 |
如果时间线上出现集中的橙色/红色区间,请确认同时间段的 诊断 日志与 系统 日志。
系统性能
| 仪表 | 含义 | 巡检标准 |
|---|---|---|
| CPU 负载 | 服务器 CPU 使用率 | 长期 80% 以上则确认负载原因 |
| 内存使用 | JVM/系统内存使用率 | 持续上升则确认内存压力 |
| HDD 占用 | 数据存储空间使用率 | 85% 以上则考虑清理或扩容 |
集群状态
| 项目 | 含义 |
|---|---|
| 状态 | 集群节点角色与是否正常 |
| 模式 | 单机/Master/Worker 等运行模式 |
| 读/写延迟 | 存储响应延迟 |
| CPU / 内存 / 数据 | 集群资源使用量 |
| 最后更新 | 集群状态统计时间 |
基础设施与引擎状态
| 区域 | 项目 |
|---|---|
| 基础设施 | 缓存, WS, MQTT, Kafka, 事件DB, 时序 |
| 引擎 | 采集·处理·延迟·存储相关实时指标 |
如果基础设施项目中有任何一项异常,则极有可能是平台共性问题而非单一站点问题。请先确认 系统 和 诊断。
平台核心指标
仪表板底部显示 6 个用于运维判断的 KPI 卡片。
| KPI | 含义 | 点击后确认 |
|---|---|---|
| 通信连接率 | 正常连接数 / 总连接数 | 连接状态 |
| 今日采集 | 今日采集的数据点总数 | 数据点, 日统计 |
| 今日报警 | 今日发生的报警总数 | 报警 |
| 设备开工率 | 数据流入正常的设备比例 | 设备, 连接状态 |
| 设备可用率 | 健康诊断正常的设备比例 | 设备, 诊断 |
| 综合 OEE | 全设备综合效率 | 生产管理, ISO 分析 |
KPI 卡片并非仅查看单一数值的画面。如果数值超出常规范围,应通过卡片的关联画面下钻,缩小范围以确认是哪个站点 → 生产线 → 设备 → 标签导致的原因。
底部运维组件
在地图和 KPI 之下,依次排列的是查看整个平台当日运行流(而非特定站点)的组件。
| 组件 | 显示内容 | 跳转 |
|---|---|---|
| 站点列表 | 连接状态, 健康状态, 站点 ID/名, 24小时数据趋势, 今日数据·报警 | 点击站点名 → 资产树 |
| 数据点及报警 | 最近 24 小时数据点接收·报警趋势 | 趋势, 报警 |
| 报警统计 | 今日报警总计, 优先级·ON/OFF 分布 | 报警分析 |
| OPC 趋势 | 通信连接状态, 通信延迟状态 | 连接状态 |
| 设备状态 | 设备连接热力图, 设备健康热力图 | 资产, 设备 |
| 生产信息 | 今日班表, 今日工作单, OEE 趋势·比较 | 生产管理, ISO 分析 |
| Edge | Edge 健康按小时, Edge API 调用, Edge 推送接收, Edge 状态分布 | Edge |
| 流 | 调用 TOP 5, 错误 TOP 5, 每小时执行趋势 | 流 |
| 诊断侧边栏 | Edge 热力图, 流健康热力图, 诊断 INFO/WARN/ERROR 列表 | 诊断, 系统日志 |
底部组件有助于缩小问题的“范围”。例如,若今日采集量减少,可按「站点列表 → OPC 趋势 → 设备热力图」顺序向下确认,从而快速找到在哪个层级停止。
主要下钻
| 出发点 | 下一个画面 | 目的 |
|---|---|---|
| 地图标记 | 工厂管理, 设备 | 确认站点·生产线·设备结构 |
| 连接状态芯片 | 连接状态 | 识别断开·延迟的数据源 |
| Edge 异常 | Edge 网关 | 确认 Edge 设备资源·PLC 采集状态 |
| 报警 Toast | 报警 | 确认报警发生的标签·资产·时间 |
| 诊断 Toast | 诊断 | 追踪系统事件原因 |
| 采集量骤减 | 日统计, 数据点 | 比较哪个站点·标签的数据减少 |
| OEE 下降 | 生产管理, ISO 分析 | 分解工作单·开工率·性能·质量原因 |
按异常信号应对
| 症状 | 优先确认 | 一般措施 |
|---|---|---|
| 通信连接率骤降 | 连接状态芯片, 连接状态 | 识别断开的 OPC/Edge, 确认网络·采集进程 |
| 今日采集为 0 或骤减 | 数据流水线 采集·接收卡片 | 按 Edge 采集, MQTT/Kafka, 存储顺序确认 |
| 缓冲等待增加 | 流水线 缓冲卡片, 右侧引擎指标 | 确认存储延迟, 外部系统调用延迟, Worker 数量 |
| 基础设施项目异常 | 右侧基础设施栏 | 在 系统 中确认缓存/WS/MQTT/Kafka/DB 状态 |
| 严重报警增加 | 报警 KPI, 报警 Toast | 在 报警 中按标签·资产·优先级排序 |
| 设备可用率下降 | 设备可用率卡片 | 确认设备健康状态, 诊断日志, 最近维修记录 |
| OEE 下降 | 综合 OEE 卡片 | 在 ISO 分析 中确认开工率·性能·质量中哪个轴下降 |
常见问题
Q. 仪表板的数字似乎停止更新了。 A. 请确认顶部的 LIVE 状态是否为绿色。如果显示为灰色或时间停止,请尝试刷新浏览器重新连接;若问题重复出现,请确认 诊断。
Q. 地图上不显示站点标记。 A. 站点必须注册经纬度。请在 工厂管理 中确认站点的坐标和模型注册状态。
Q. 连接率较低,但 Edge 看起来正常。 A. Edge 设备的 HTTP 状态与标签数据接收状态可能不同。请在 连接状态 中确认实际接收延迟或断开的对象。
Q. 右侧健康栏的基础设施全部正常,但只有一个站点异常。 A. 这更有可能是该站点的网络、Edge、OPC/PLC 连接问题,而非平台共性故障。请先确认站点标记和 连接状态。
Q. 报警 Toast 消失了。还能再次查看吗?
A. 在 报警 中将近期时间范围缩小至 10M 或 30M 确认。如果是系统事件,请在 诊断 中查询同一时间段。